【本节目标】
1. 树概念及结构
2. 二叉树概念及结构
3. 二叉树顺序结构及实现
4. 二叉树链式结构及实现
1.树概念及结构
1.1树的概念
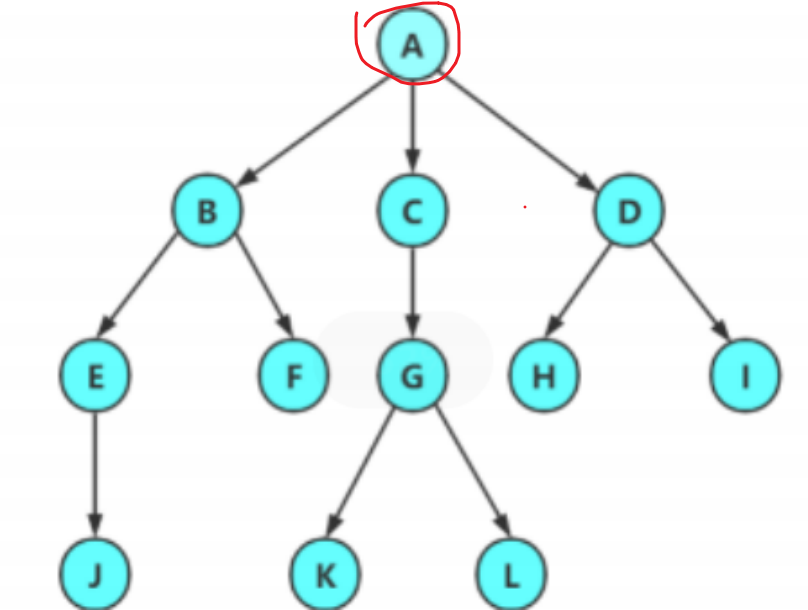
树是一种 非线性(线性结构就是顺序表链表) 的数据结构,它是由 n ( n>=0 )个有限结点组成一个具有层次关系的集合。 把它叫做树是因 为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的 。
- 有一个特殊的结点,称为根结点,根节点没有前驱结点(如下图)
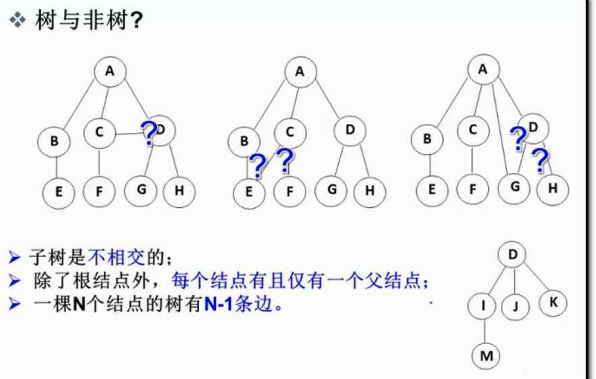
注意:树形结构中,子树之间不能有交集,否则就不是树形结构
1.2 树的相关概念
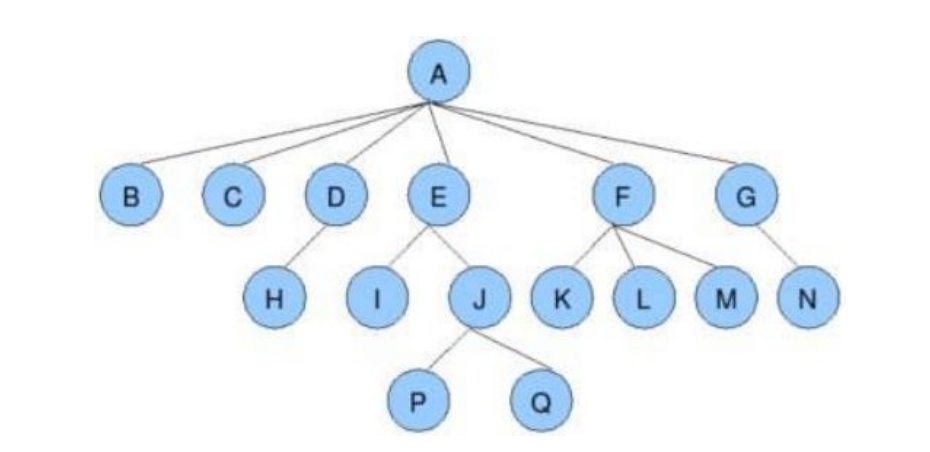
节点的度 :一个节点含有的子树的个数称为该节点的度; 如上图: A 的为 6
叶节点或终端节点 :度为 0 的节点称为叶节点; 如上图: B 、 C 、 H 、 I... 等节点为叶节点
非终端节点或分支节点 :度不为 0 的节点; 如上图: D 、 E 、 F 、 G... 等节点为分支节点
双亲节点或父节点 :若一个节点含有子节点,则这个节点称为其子节点的父节点; 如上图: A 是 B 的父节点
孩子节点或子节点 :一个节点含有的子树的根节点称为该节点的子节点; 如上图: B 是 A 的孩子节点
兄弟节点 :具有相同父节点的节点互称为兄弟节点; 如上图: B 、 C 是兄弟节点
树的度 :一棵树中,最大的节点的度称为树的度; 如上图:树的度为 6
节点的层次 :从根开始定义起,根为第 1 层,根的子节点为第 2 层,以此类推;
树的高度或深度 :树中节点的最大层次; 如上图:树的高度为 4
堂兄弟节点 :双亲在同一层的节点互为堂兄弟;如上图: H 、 I 互为兄弟节点
节点的祖先 :从根到该节点所经分支上的所有节点;如上图: A 是所有节点的祖先
子孙 :以某节点为根的子树中任一节点都称为该节点的子孙。如上图:所有节点都是 A 的子孙
森林 :由 m ( m>0 )棵互不相交的树的集合称为森林;
1.3 树的表示
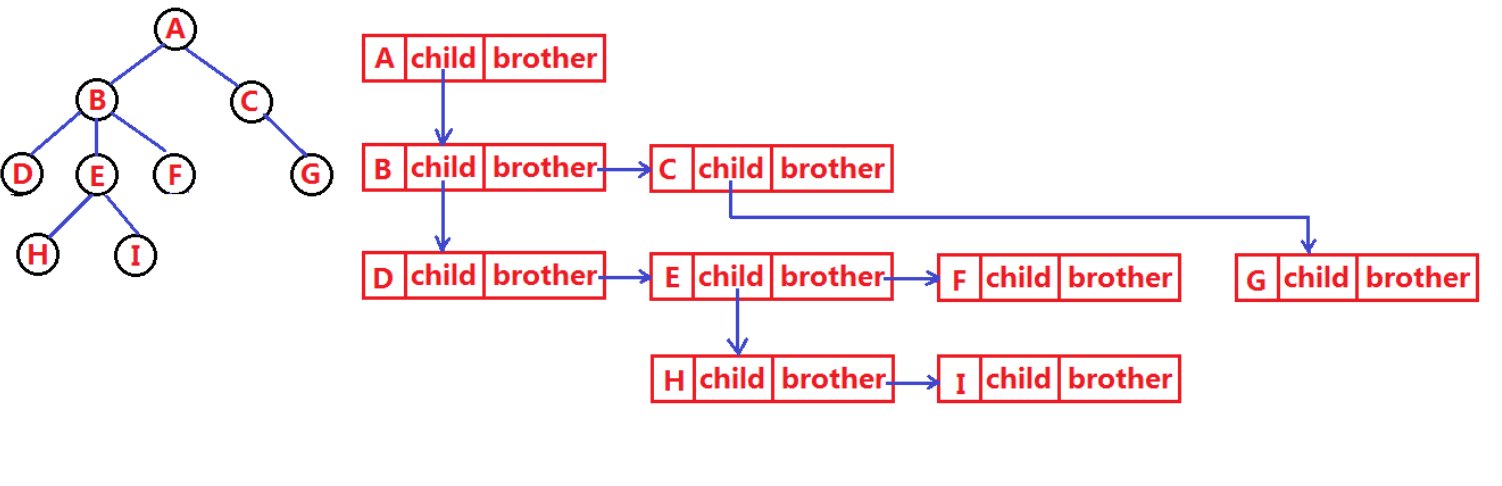
树结构相对线性表就比较复杂了,要存储表示起来就比较麻烦了, 既然保存值域,也要保存结点和结点之间 的关系 ,实际中树有很多种表示方式如:双亲表示法,孩子表示法、孩子双亲表示法以及孩子兄弟表示法 等。我们这里就简单的了解其中最常用的孩子兄弟表示法 。
typedef int DataType;
struct Node
{struct Node* _firstChild1; // 第一个孩子结点struct Node* _pNextBrother; // 指向其下一个兄弟结点DataType _data; // 结点中的数据域
};
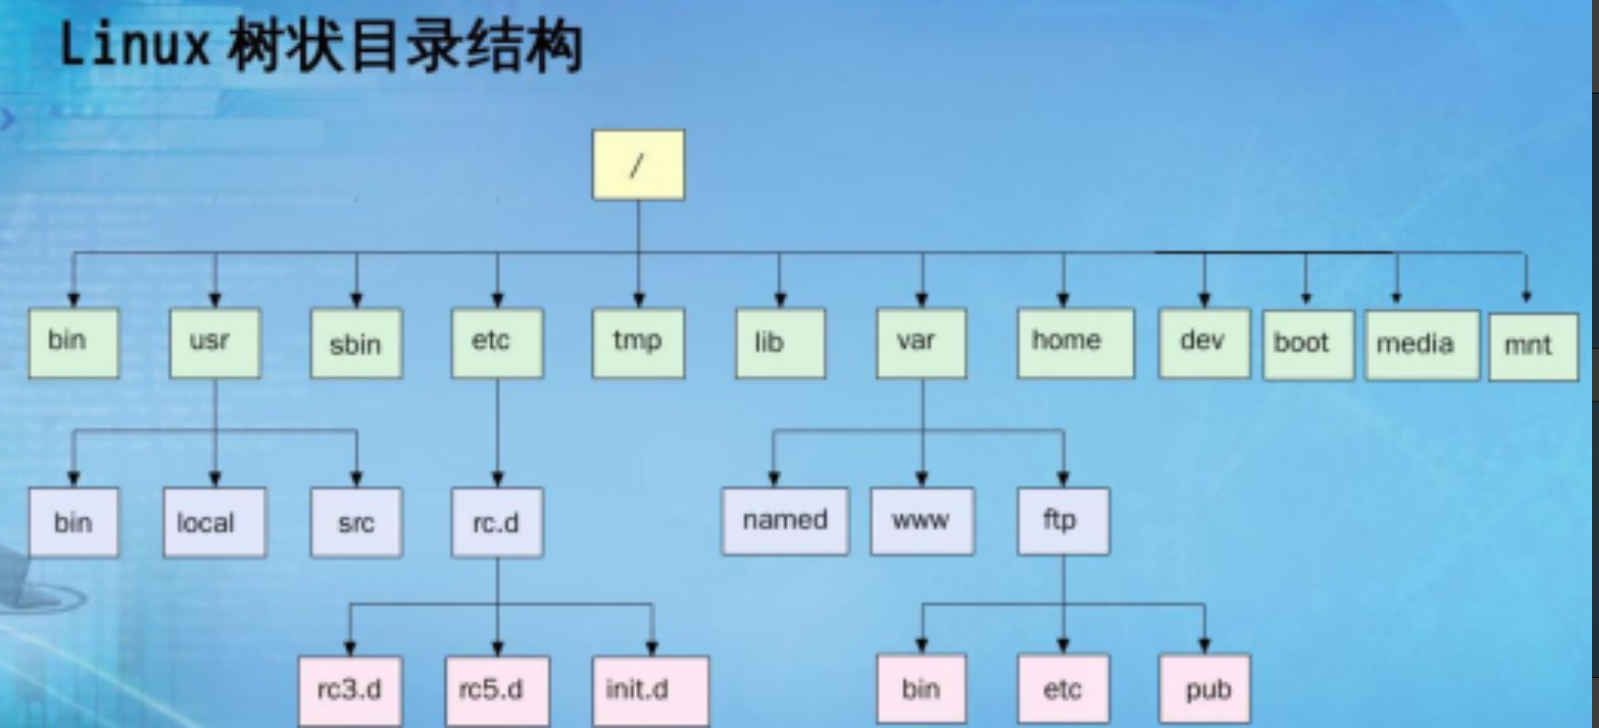
1.4 树在实际中的运用(表示文件系统的目录树结构)
2.二叉树概念及结构
2.1概念
一棵二叉树是结点的一个有限集合,该集合
1. 或者为空
2. 由一个根节点加上两棵别称为左子树和右子树的二叉树组成
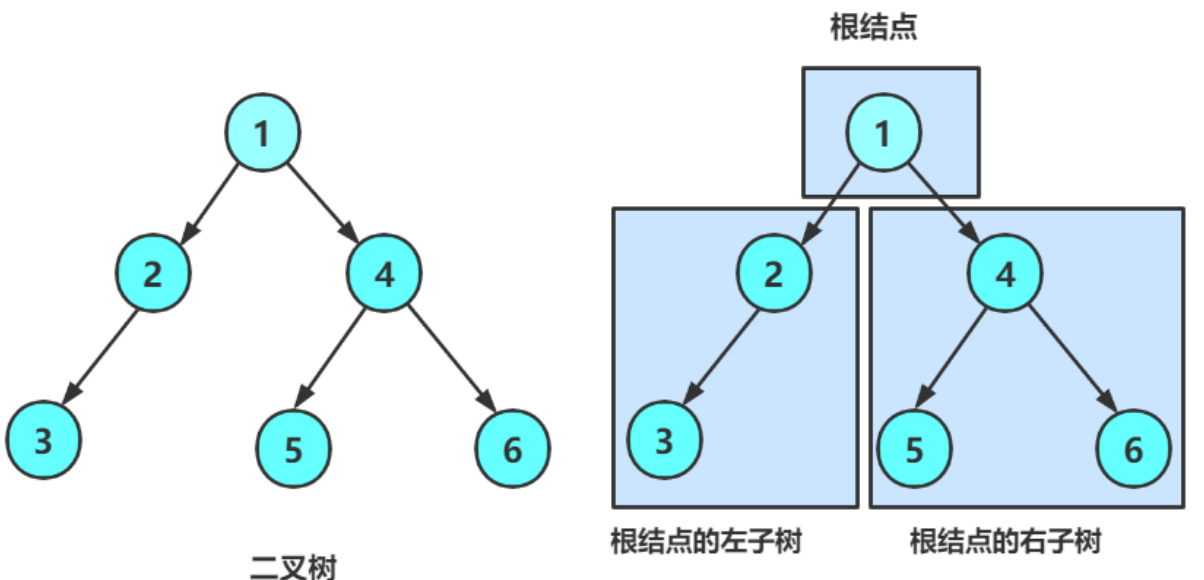
从上图可以看出:
1. 二叉树不存在度大于 2 的结点
2. 二叉树的子树有左右之分,次序不能颠倒,因此二叉树是有序树
注意:对于任意的二叉树都是由以下几种情况复合而成的

2.2现实中的二叉树:
2.3 特殊的二叉树:
1. 满二叉树:一个二叉树,如果每一个层的结点数都达到最大值,则这个二叉树就是满二叉树。也就是 说如果一个二叉树的层数为 K,且结点总数是2^k-1则它就是满二叉树。
2. 完全二叉树 :完全二叉树是效率很高的数据结构,完全二叉树是由满二叉树而引出来的。对于深度为 K
的,有 n 个结点的二叉树,当且仅当其每一个结点都与深度为 K 的满二叉树中编号从 1 至 n 的结点一一对
应时称之为完全二叉树。 要注意的是满二叉树是一种特殊的完全二叉树。

2.4 二叉树的性质
1. 若规定根节点的层数为 1 ,则一棵非空二叉树的 第 i 层上最多有2^(i-1)个节点
2.若规定根节点的层数为1,则深度为h的二叉树的最大结点数是2^h-1
3. 对任何一棵二叉树, 如果度为0其叶结点个数为n0,度为2的分支结点个数为 n2,则有n0=n2+1
4. 若规定根节点的层数为1,具有n个结点的满二叉树的深度,h=log2(n+1),(ps:log2(n+1)是log以2为底,n+1为对数)
5. 对于具有 n 个结点的完全二叉树,如果按照从上至下从左至右的数组顺序对所有节点从 0 开始编号,则对 于序号为i 的结点有:
1. 若 i>0 , i 位置节点的双亲序号: (i-1)/2 ; i=0 , i 为根节点编号,无双亲节点
2. 若 2i+1<n ,左孩子序号: 2i+1 , 2i+1>=n 否则无左孩子
3. 若 2i+2<n ,右孩子序号: 2i+2 , 2i+2>=n 否则无右孩子
1. 某二叉树共有 399 个结点,其中有 199 个度为 2 的结点,则该二叉树中的叶子结点数为( )A 不存在这样的二叉树B 200C 198D 1992. 下列数据结构中,不适合采用顺序存储结构的是( )A 非完全二叉树B 堆C 队列D 栈3. 在具有 2n 个结点的完全二叉树中,叶子结点个数为( )A nB n+1C n-1D n/24. 一棵完全二叉树的节点数位为 531 个,那么这棵树的高度为( )A 11B 10C 8D 125. 一个具有 767 个节点的完全二叉树,其叶子节点个数为()A 383B 384C 385D 386答案:1.B2.A3.A4.B5.B
2.5 二叉树的存储结构
二叉树一般可以使用两种结构存储,一种顺序结构,一种链式结构。
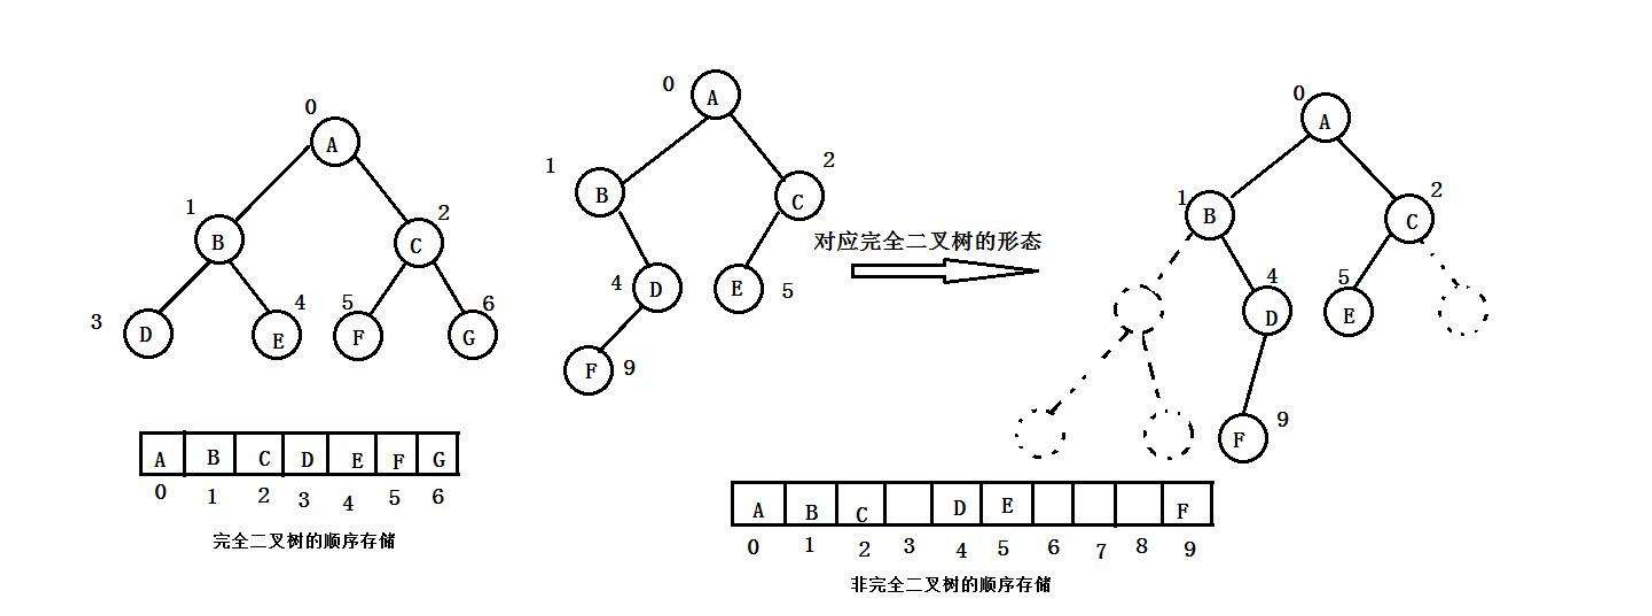
1. 顺序存储
顺序结构存储就是使用 数组来存储 ,一般使用数组 只适合表示完全二叉树 ,因为不是完全二叉树会有空
间的浪费。而现实中使用中只有堆才会使用数组来存储,关于堆我们后面的章节会专门讲解。 二叉树顺
序存储在物理上是一个数组,在逻辑上是一颗二叉树。
2. 链式存储
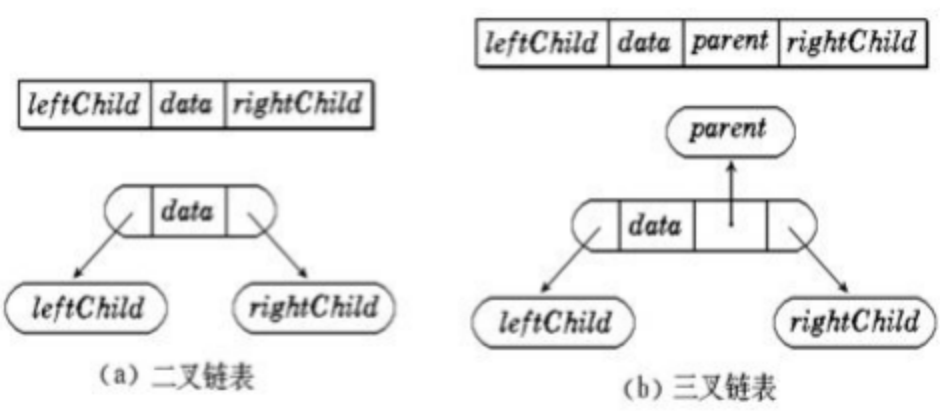
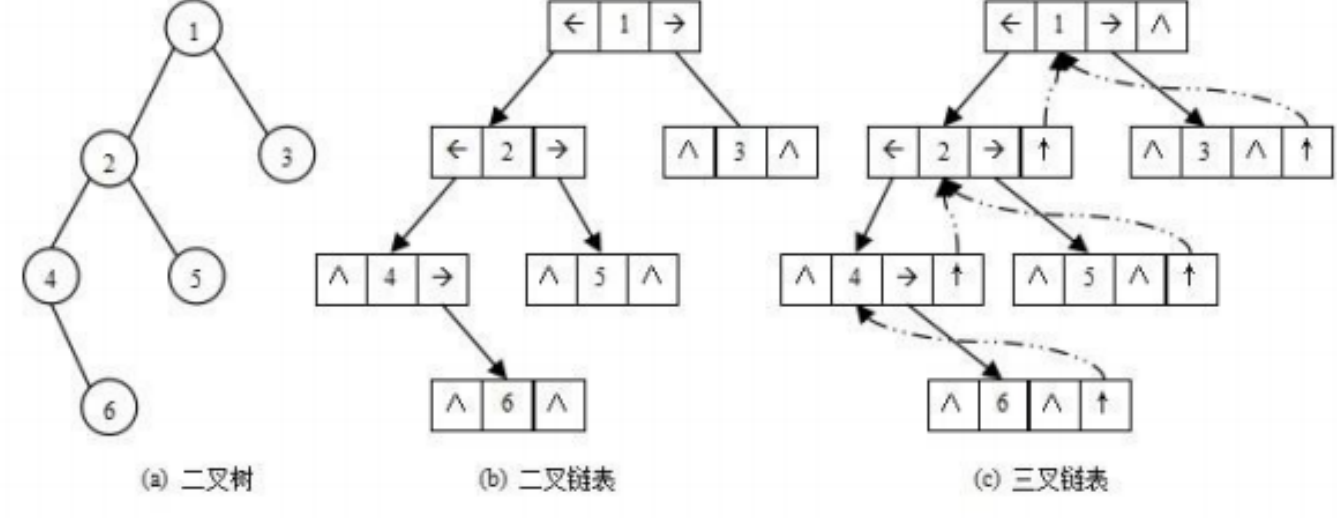
二叉树的链式存储结构是指,用链表来表示一棵二叉树,即用链来指示元素的逻辑关系。 通常的方法是
链表中每个结点由三个域组成,数据域和左右指针域,左右指针分别用来给出该结点左孩子和右孩子所
在的链结点的存储地址 。链式结构又分为二叉链和三叉链,当前我们学习中一般都是二叉链,后面课程
学到高阶数据结构如红黑树等会用到三叉链。
typedef int BTDataType;
// 二叉链
struct BinaryTreeNode
{struct BinTreeNode* _pLeft; // 指向当前节点左孩子struct BinTreeNode* _pRight; // 指向当前节点右孩子BTDataType _data; // 当前节点值域
}
// 三叉链
struct BinaryTreeNode
{struct BinTreeNode* _pParent; // 指向当前节点的双亲struct BinTreeNode* _pLeft; // 指向当前节点左孩子struct BinTreeNode* _pRight; // 指向当前节点右孩子BTDataType _data; // 当前节点值域
};3.二叉树的顺序结构及实现
3.1 二叉树的顺序结构
普通的二叉树是不适合用数组来存储的,因为可能会存在大量的空间浪费。而完全二叉树更适合使用顺序结 构存储。
现实中我们通常把堆 ( 一种二叉树 ) 使用顺序结构的数组来存储,需要注意的是这里的堆和操作系统
虚拟进程地址空间中的堆是两回事,一个是数据结构,一个是操作系统中管理内存的一块区域分段。
3.2 堆的概念及结构
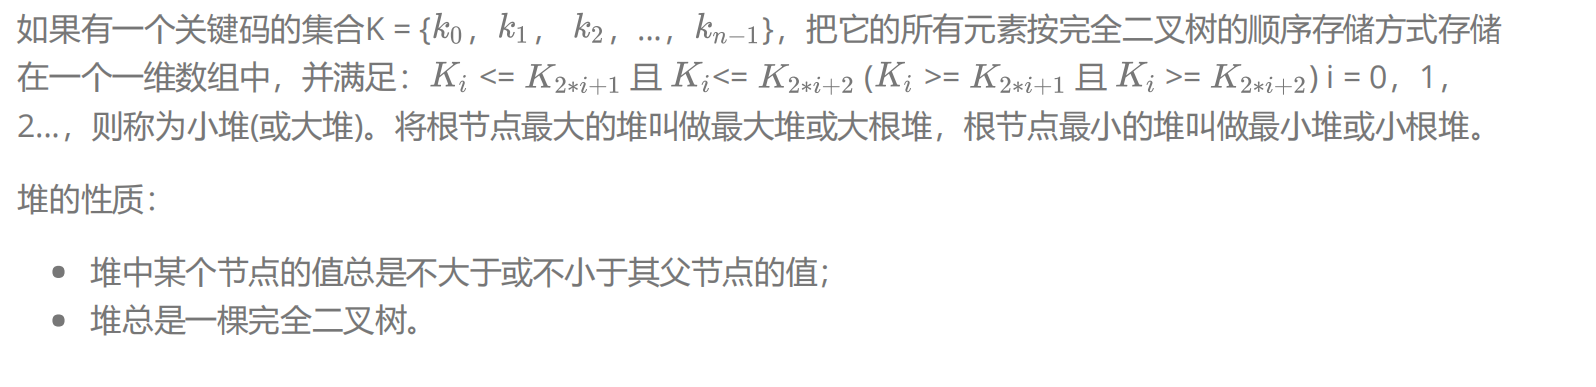
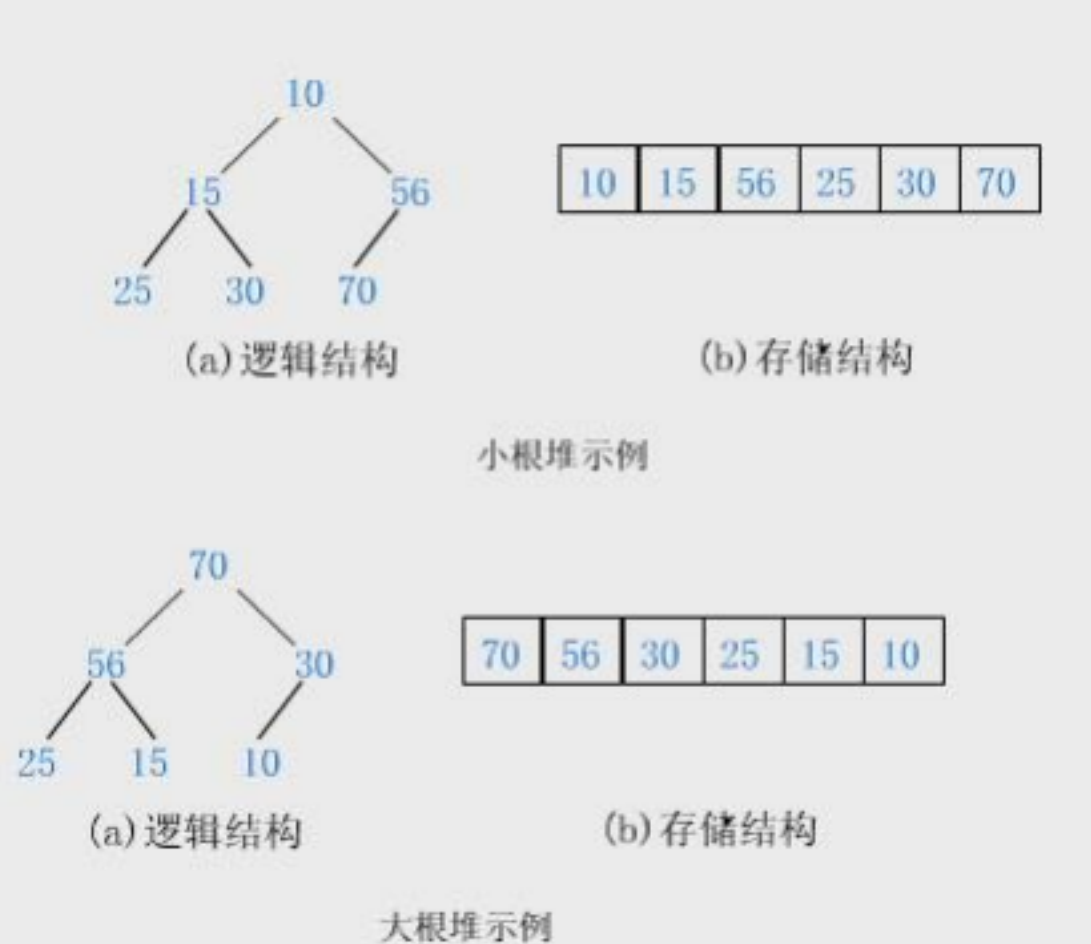
选择题
1. 下列关键字序列为堆的是:()A 100 , 60 , 70 , 50 , 32 , 65B 60 , 70 , 65 , 50 , 32 , 100C 65 , 100 , 70 , 32 , 50 , 60D 70 , 65 , 100 , 32 , 50 , 60E 32 , 50 , 100 , 70 , 65 , 60F 50 , 100 , 70 , 65 , 60 , 322. 已知小根堆为 8 , 15 , 10 , 21 , 34 , 16 , 12 ,删除关键字 8 之后需重建堆,在此过程中,关键字之间的比较次 数是()。A 1B 2C 3D 43. 一组记录排序码为 ( 5 11 7 2 3 17 ), 则利用堆排序方法建立的初始堆为A ( 11 5 7 2 3 17 )B ( 11 5 7 2 17 3 )C ( 17 11 7 2 3 5 )D ( 17 11 7 5 3 2 )E ( 17 7 11 3 5 2 )F ( 17 7 11 3 2 5 )4. 最小堆 [ 0 , 3 , 2 , 5 , 7 , 4 , 6 , 8 ], 在删除堆顶元素 0 之后,其结果是()A [ 3 , 2 , 5 , 7 , 4 , 6 , 8 ]B [ 2 , 3 , 5 , 7 , 4 , 6 , 8 ]C [ 2 , 3 , 4 , 5 , 7 , 8 , 6 ]D [ 2 , 3 , 4 , 5 , 6 , 7 , 8 ]
选择题答案
1. A2. C3. C4. C
3.3 堆的实现
3.2.1 堆向下调整算法
现在我们给出一个数组,逻辑上看做一颗完全二叉树。我们通过从根节点开始的向下调整算法可以把它调整 成一个小堆。向下调整算法有一个前提:左右子树必须是一个堆,才能调整。
int array [] = { 27 , 15 , 19 , 18 , 28 , 34 , 65 , 49 , 25 , 37 };

代码:
void AdjustDown(HeapDatatype* arr, int size, int parent)//向下调整肯定是父亲找儿子
{int child = parent * 2 + 1;//通过父亲找到儿子下标的位置while (child < size){if (child+1<size && arr[child + 1] <arr[child])//这里是小堆的例子,用的是假设法,找到最小的那个孩子{child++;}if (arr[child] < arr[parent]){Swap(&arr[child], &arr[parent]);parent = child;child = child * 2 + 1;}else{break;}}}3.2.2堆的创建
下面我们给出一个数组,这个数组逻辑上可以看做一颗完全二叉树,但是还不是一个堆,现在我们通过算 法,把它构建成一个堆。根节点左右子树不是堆,我们怎么调整呢?这里我们从倒数的第一个非叶子节点的 子树开始调整,一直调整到根节点的树,就可以调整成堆。
int a[] = {1,5,3,8,7,6}; 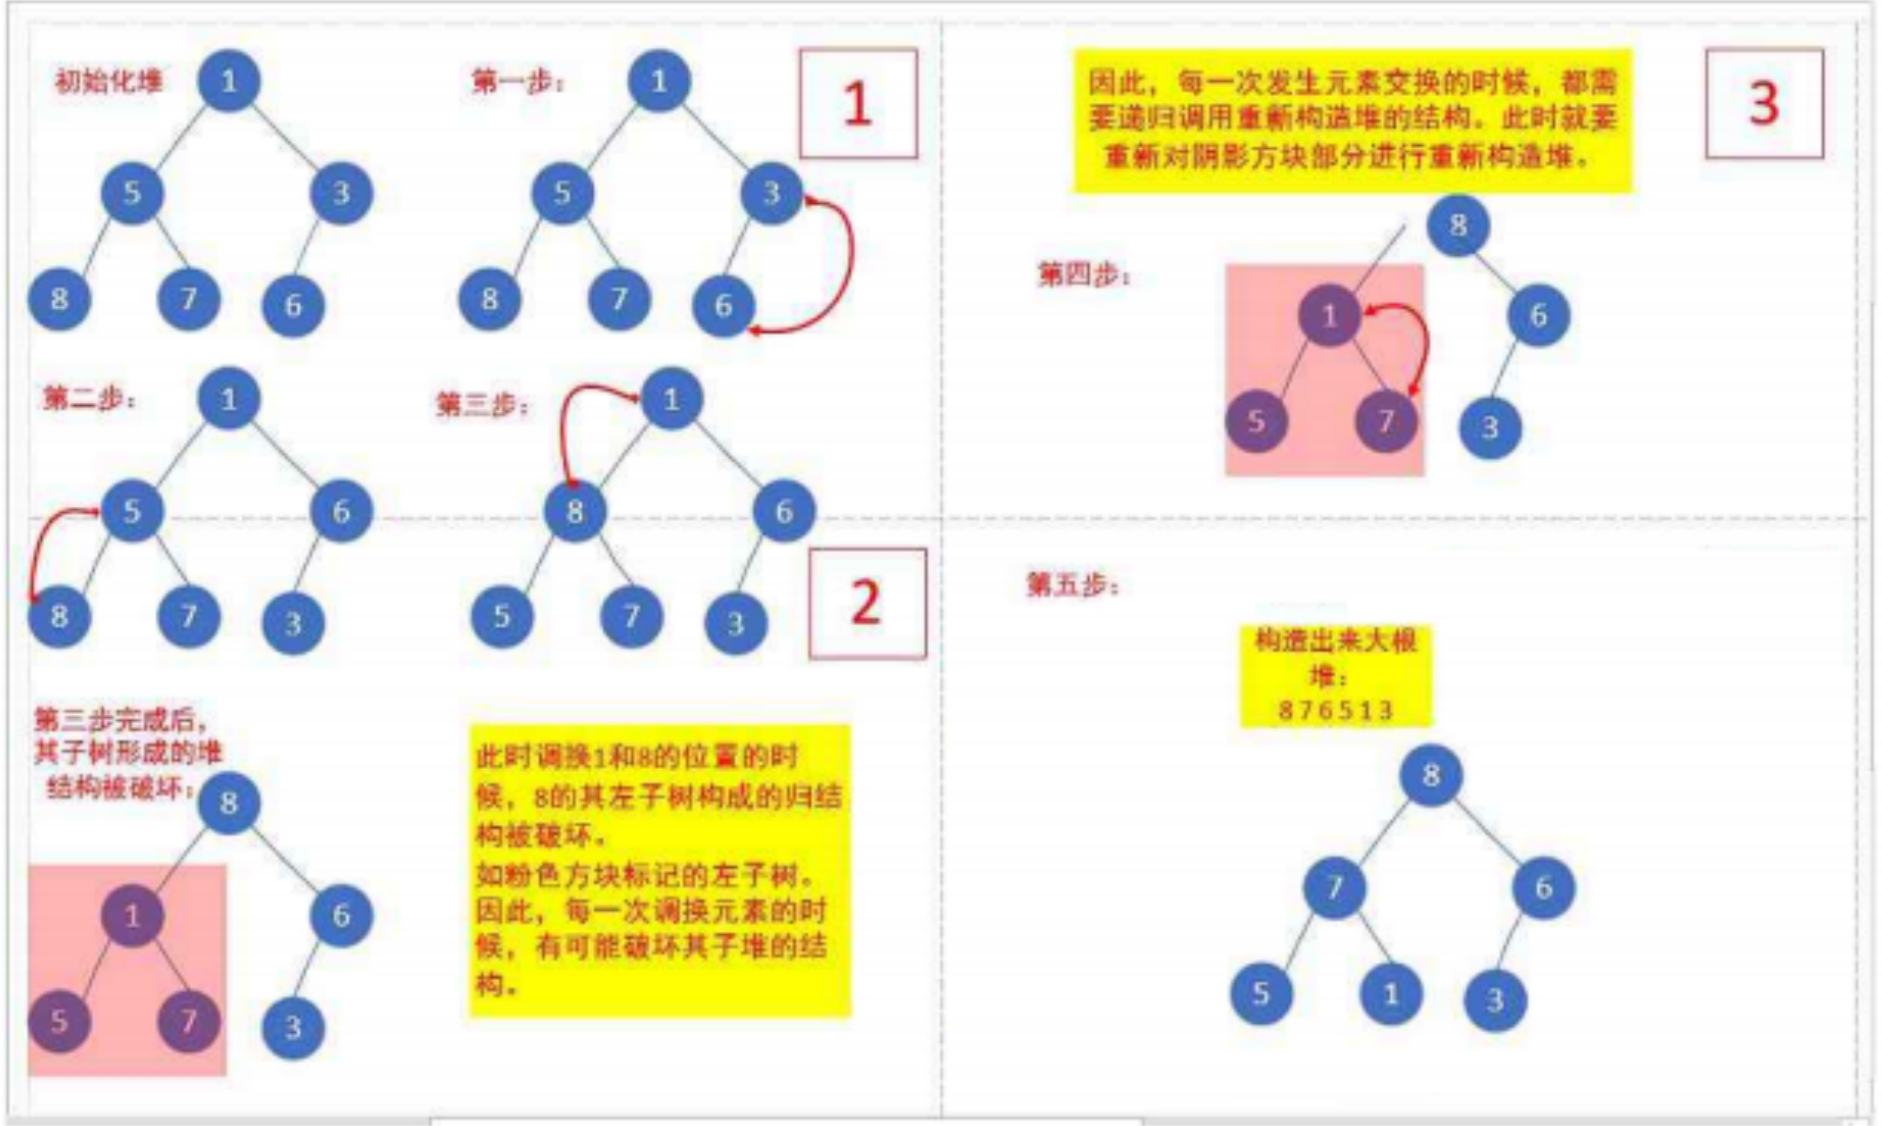 3.2.3 建堆时间复杂度
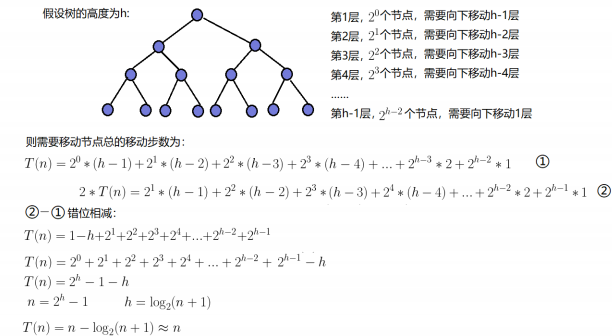
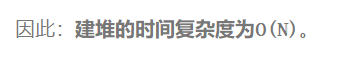
因为堆是完全二叉树,而满二叉树也是完全二叉树,此处为了简化使用满二叉树来证明 ( 时间复杂度本来看的 就是近似值,多几个节点不影响最终结果) :
3.2.4 堆的插入
先插入一个10到数组的尾上,再进行向上调整算法,直到满足堆。
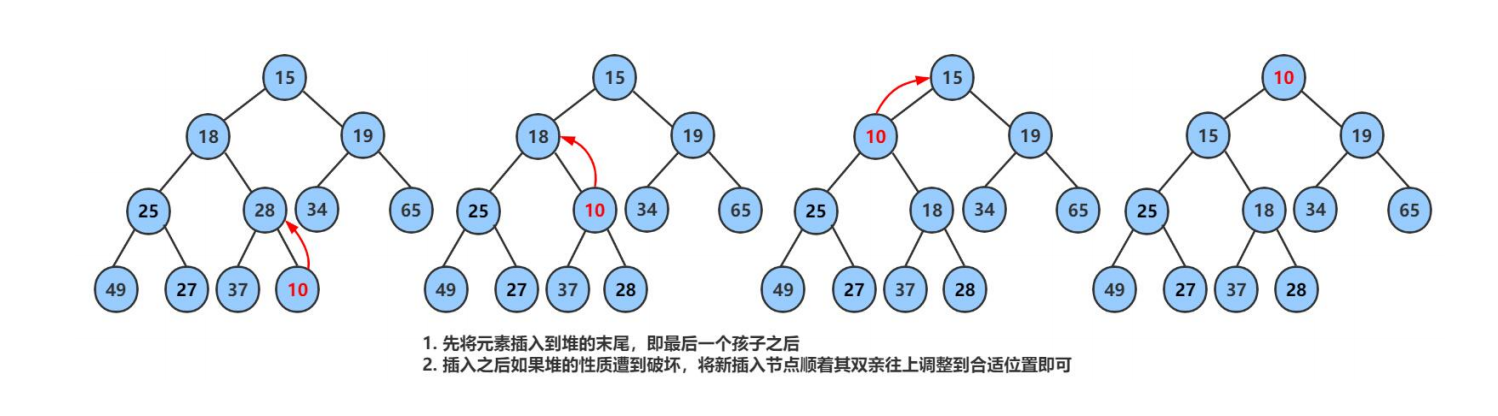
void AdjustUp(HeapDatatype* arr, int child)
{int parent = (child - 1) / 2;while (child>0){if (arr[child] > arr[parent]){Swap(&arr[parent], &arr[child]);child = parent;parent = (parent - 1) / 2;}else{break;}}
}
3.2.5 堆的删除
删除堆是删除堆顶的数据,将堆顶的数据根最后一个数据一换,然后删除数组最后一个数据,再进行向下调 整算法。
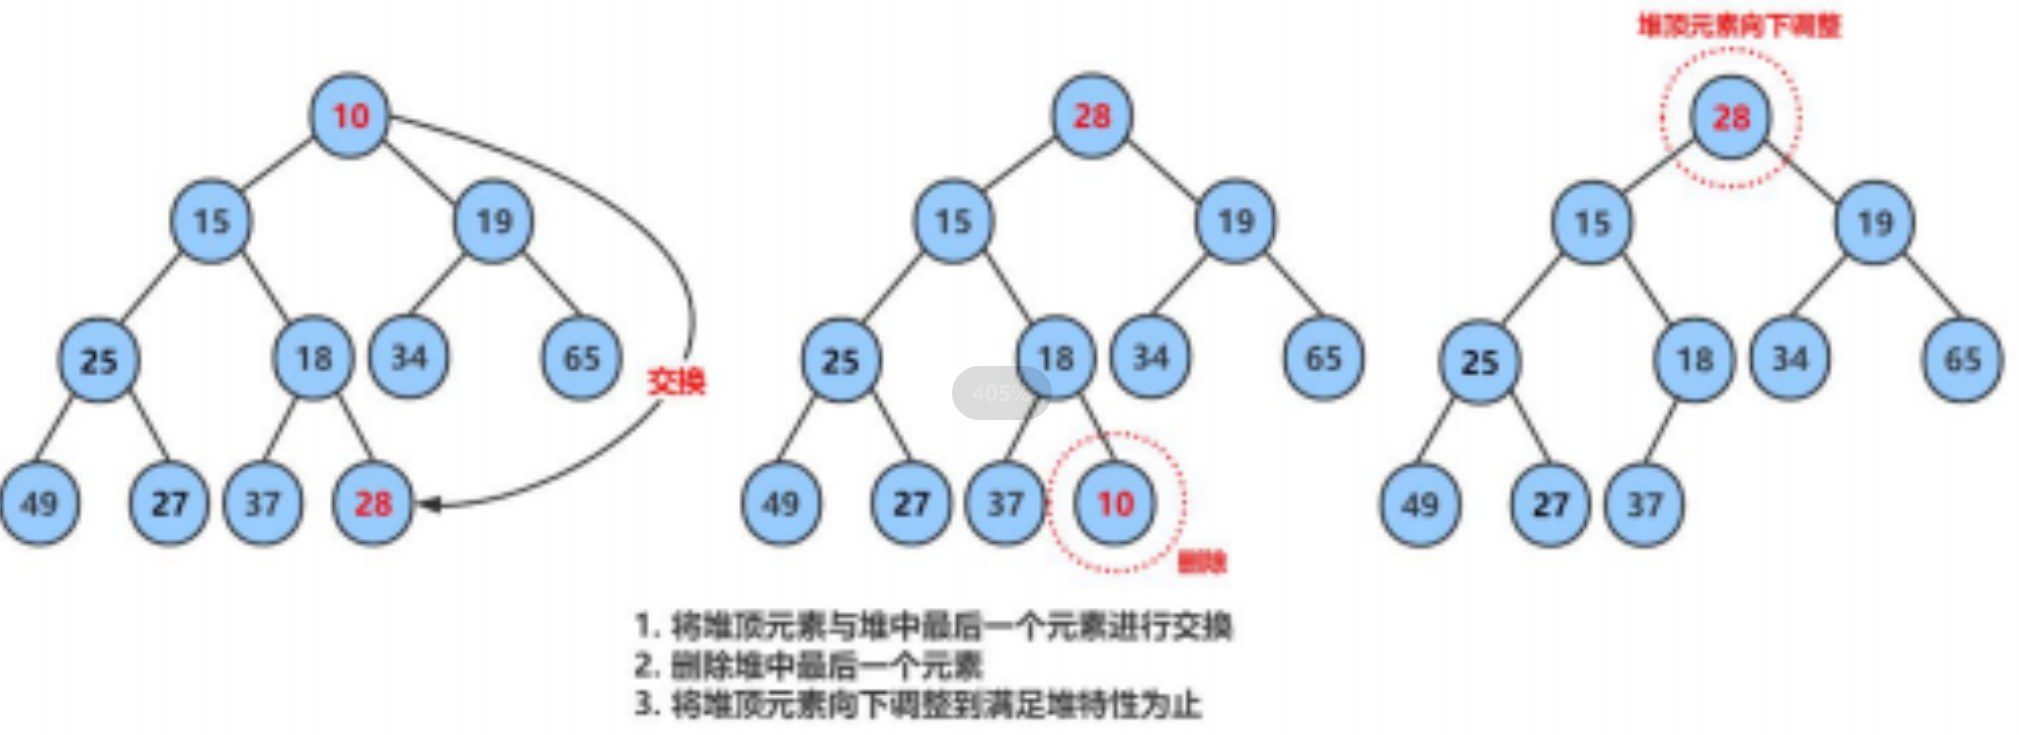
void HPPop(HP* php)
{assert(php);assert(php->size>0);Swap(&php->arr[0], &php->arr[php->size - 1]);//交换php->size--;//删除最后一个数据AdjustDown(php->arr, php->size, 0);//向下调整
}
3.2.6 堆的代码实现
框架
typedef int HPDataType;
typedef struct Heap
{HPDataType* _a;int _size;int _capacity;
}Heap;// 堆的构建
void HeapCreate(Heap* hp, HPDataType* a, int n);
// 堆的销毁
void HeapDestory(Heap* hp);
// 堆的插入
void HeapPush(Heap* hp, HPDataType x);
// 堆的删除
void HeapPop(Heap* hp);
// 取堆顶的数据
HPDataType HeapTop(Heap* hp);
// 堆的数据个数
int HeapSize(Heap* hp);
// 堆的判空
int HeapEmpty(Heap* hp);
头文件
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<assert.h>
#include<stdbool.h>
#include<string.h>
typedef int HeapDatatype;
struct Heap //堆的底层就是顺序表
{HeapDatatype* arr;int size;int capacity;
};
typedef struct Heap HP;void HPInit(HP* php);
void HPInitArray(HP* php,HeapDatatype* arr, int size);
void HPDestroy(HP* php);
void HPPush(HP* php, HeapDatatype x);
HeapDatatype HPTop(HP* php);
void HPPop(HP* php);
bool HPEmpty(HP* php);
void AdjustUp(HeapDatatype* arr, int child);
void AdjustDown(HeapDatatype* arr, int size, int parent);
void Swap(HeapDatatype* x, HeapDatatype* y);
#define _CRT_SECURE_NO_WARNINGS 1
#include"Heap.h"
void HPInit(HP* php)
{assert(php);php->arr = NULL;php->size = 0;php->capacity = 0;
}
void HPInitArray(HP* php, HeapDatatype* arr, int size)
{assert(php);php->arr = (HeapDatatype*)malloc(sizeof(HeapDatatype) * size);if ( php->arr==NULL){perror("malloc fail!");exit(1);}memcpy(php->arr, arr, sizeof(HeapDatatype) * size);php->capacity = php->size = size;//不好用的比较少//for (int i = 1; i < size; i++)//{// AdjustUp(php->arr, i);//}//向下调整建堆for (int i = (php->size-1-1)/2; i >= 0; i--){AdjustDown(php->arr, php->size, i);}
}
void HPDestroy(HP* php)
{assert(php);free(php->arr);php->arr = NULL;php->size = 0;php->capacity = 0;}
void Swap(HeapDatatype* x, HeapDatatype* y)
{HeapDatatype temp;temp= *x;*x = *y;*y = temp;
}
void AdjustUp(HeapDatatype* arr, int child)
{int parent = (child - 1) / 2;while (child>0){if (arr[child] > arr[parent]){Swap(&arr[parent], &arr[child]);child = parent;parent = (parent - 1) / 2;}else{break;}}
}
void HPPush(HP* php, HeapDatatype x)
{assert(php);size_t newcapacity;if (php->size == php->capacity){if (php->capacity == 0){newcapacity = 4;}else{newcapacity = php->capacity * 2;}HeapDatatype* temp = realloc(php->arr, sizeof(HeapDatatype) * newcapacity);if (temp == NULL){perror("realloc fail!");exit(1);}php->arr = temp;php->capacity = newcapacity;}php->arr[php->size] = x;php->size++;AdjustUp(php->arr, php->size-1);}
HeapDatatype HPTop(HP* php)
{assert(php);return php->arr[0];
}
void AdjustDown(HeapDatatype* arr, int size, int parent)
{int child = parent * 2 + 1;while (child < size){if (child+1<size && arr[child + 1] <arr[child]){child++;}if (arr[child] < arr[parent]){Swap(&arr[child], &arr[parent]);parent = child;child = child * 2 + 1;}else{break;}}}void HPPop(HP* php)
{assert(php);assert(php->size>0);Swap(&php->arr[0], &php->arr[php->size - 1]);php->size--;AdjustDown(php->arr, php->size, 0);
}
bool HPEmpty(HP* php)
{assert(php);return php->size == 0;
}
3.4 堆的应用
3.4.1 堆排序
堆排序即利用堆的思想来进行排序,总共分为两个步骤:
1. 建堆
升序(小->大):建大堆
降序(大->小):建小堆
2. 利用堆删除思想来进行排序
建堆和堆删除中都用到了向下调整,因此掌握了向下调整,就可以完成堆排序
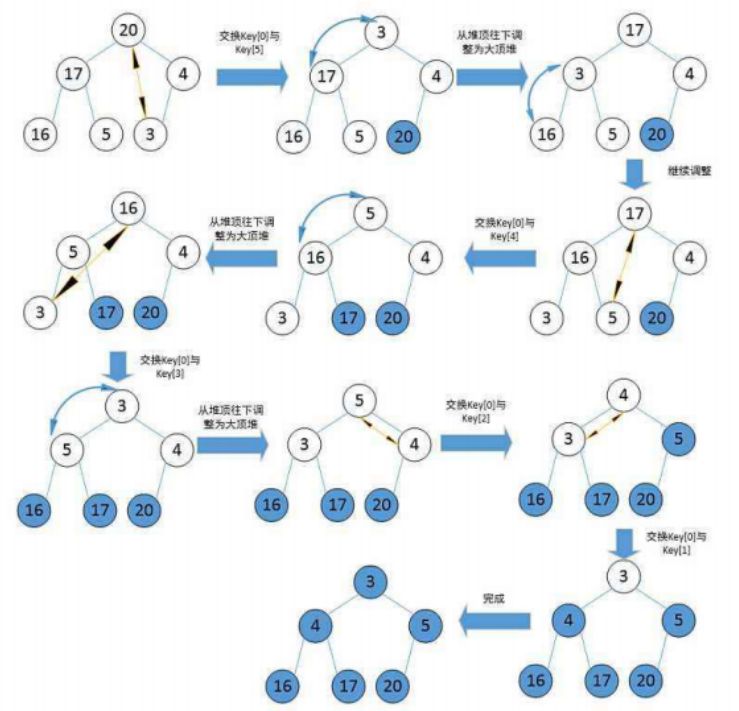
void HeapSort(int* a, int n)
{for (int i = (n-1-1)/2; i >=0; i--)//向下调整建堆{AdjustDown(a, n, i);}int end = n - 1;//最后一个数while (end > 0){Swap(&a[0], &a[end]); //a[0]就是最小的,最小的放在最后AdjustDown(a, end, 0);end--;}
}
3.24.2 TOP-K问题
TOP-K 问题:即求数据结合中前 K 个最大的元素或者最小的元素,一般情况下数据量都比较大 。
比如:专业前 10 名、世界 500 强、富豪榜、游戏中前 100 的活跃玩家等。
对于 Top-K 问题,能想到的最简单直接的方式就是排序,但是:如果数据量非常大,排序就不太可取了 ( 可能
数据都不能一下子全部加载到内存中 ) 。最佳的方式就是用堆来解决,基本思路如下:
1. 用数据集合中前 K 个元素来建堆
前 k 个最大的元素,则建小堆
前 k 个最小的元素,则建大堆
2. 用剩余的 N-K 个元素依次与堆顶元素来比较,不满足则替换堆顶元素
比特就业课 将剩余 N-K 个元素依次与堆顶元素比完之后,堆中剩余的 K 个元素就是所求的前 K 个最小或者最大的元素。
void PrintTopK(int* a, int n, int k)
{// 1. 建堆--用a中前k个元素建堆// 2. 将剩余n-k个元素依次与堆顶元素交换,不满则则替换
}
void TestTopk()
{int n = 10000;int* a = (int*)malloc(sizeof(int)*n);srand(time(0));for (size_t i = 0; i < n; ++i){a[i] = rand() % 1000000;}a[5] = 1000000 + 1;a[1231] = 1000000 + 2;a[531] = 1000000 + 3;a[5121] = 1000000 + 4;a[115] = 1000000 + 5;a[2335] = 1000000 + 6;a[9999] = 1000000 + 7;a[76] = 1000000 + 8;a[423] = 1000000 + 9;a[3144] = 1000000 + 10;PrintTopK(a, n, 10);
}4.二叉树链式结构的实现
4.1 前置说明
在学习二叉树的基本操作前,需先要创建一棵二叉树,然后才能学习其相关的基本操作。由于现在大家对二 叉树结构掌握还不够深入,为了降低大家学习成本,此处手动快速创建一棵简单的二叉树,快速进入二叉树
操作学习,等二叉树结构了解的差不多时,我们反过头再来研究二叉树真正的创建方式。
typedef int BTDataType;
typedef struct BinaryTreeNode
{BTDataType _data;struct BinaryTreeNode* _left;struct BinaryTreeNode* _right;
}BTNode;
BTNode* CreatBinaryTree()
{BTNode* node1 = BuyNode(1);BTNode* node2 = BuyNode(2);BTNode* node3 = BuyNode(3);
BTNode* node4 = BuyNode(4);BTNode* node5 = BuyNode(5);BTNode* node6 = BuyNode(6);node1->_left = node2;node1->_right = node4;node2->_left = node3;node4->_left = node5;node4->_right = node6;return node1;
}
注意:上述代码并不是创建二叉树的方式,真正创建二叉树方式后序详解重点讲解。
再看二叉树基本操作前,再回顾下二叉树的概念, 二叉树是:
1. 空树
2. 非空:根节点,根节点的左子树、根节点的右子树组成的
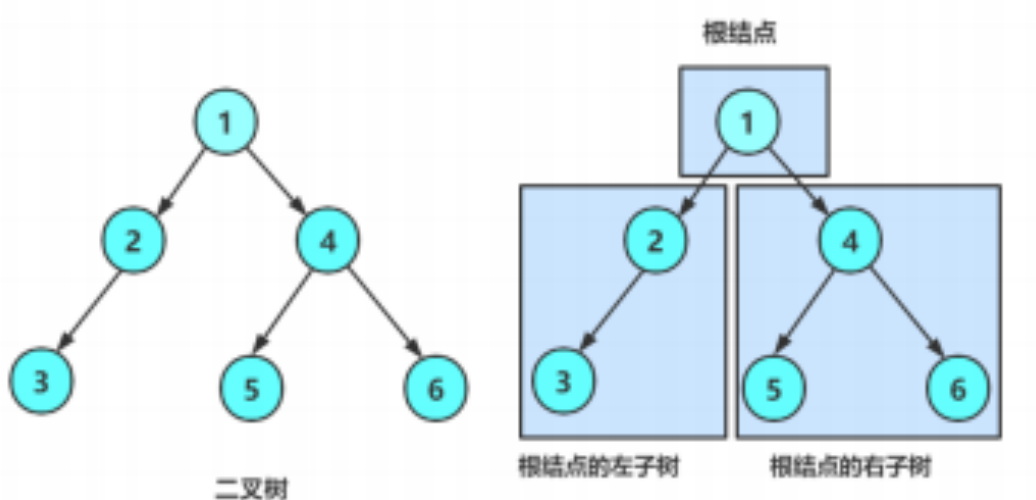
从概念中可以看出,二叉树定义是递归式的,因此后序基本操作中基本都是按照该概念实现的
4.2二叉树的遍历
4.2.1 前序、中序以及后序遍历
学习二叉树结构,最简单的方式就是遍历。所谓 二叉树遍历 (Traversal) 是按照某种特定的规则,依次对二叉 树中的节点进行相应的操作,并且每个节点只操作一次 。访问结点所做的操作依赖于具体的应用问题。 遍历 是二叉树上最重要的运算之一,也是二叉树上进行其它运算的基础。
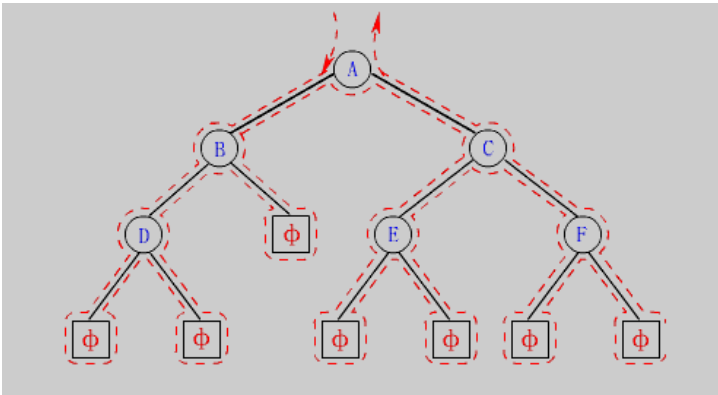
按照规则,二叉树的遍历有: 前序 / 中序 / 后序的递归结构遍历 :
1. 前序遍历 (Preorder Traversal 亦称先序遍历 )—— 访问根结点的操作发生在遍历其左右子树之前。
2. 中序遍历 (Inorder Traversal)—— 访问根结点的操作发生在遍历其左右子树之中(间)。
3. 后序遍历 (Postorder Traversal)—— 访问根结点的操作发生在遍历其左右子树之后。
由于被访问的结点必是某子树的根, 所以 N(Node )、 L(Left subtree )和 R(Right subtree )又可解释为
根、根的左子树和根的右子树 。 NLR 、 LNR 和 LRN 分别又称为先根遍历、中根遍历和后根遍历。
// 二叉树前序遍历
void PreOrder(BTNode* root);
// 二叉树中序遍历
void InOrder(BTNode* root);
// 二叉树后序遍历
void PostOrder(BTNode* root);
void PreOrder(BTNode* root)
{if (root == NULL){printf("NULL ");return ;}printf("%d ", root->val);PreOrder(root->left);PreOrder(root->right);
}
void InOrder(BTNode* root)
{if (root == NULL){printf("NULL ");return;}InOrder(root->left);printf("%d ", root->val);InOrder(root->right);
}
void PostOrder(BTNode* root)
{if (root == NULL){printf("NULL ");return;}PostOrder(root->left);PostOrder(root->right);printf("%d ", root->val);
} 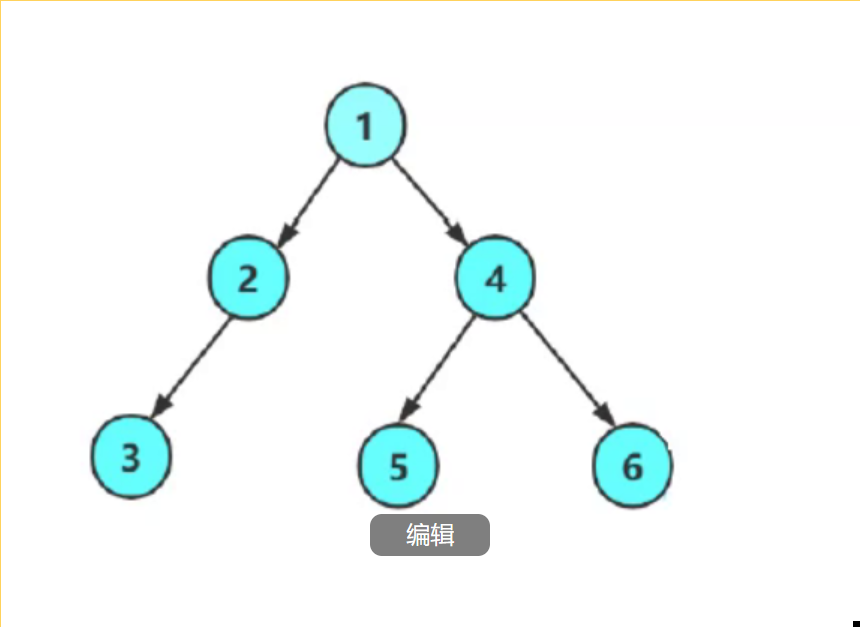
以这棵树为例
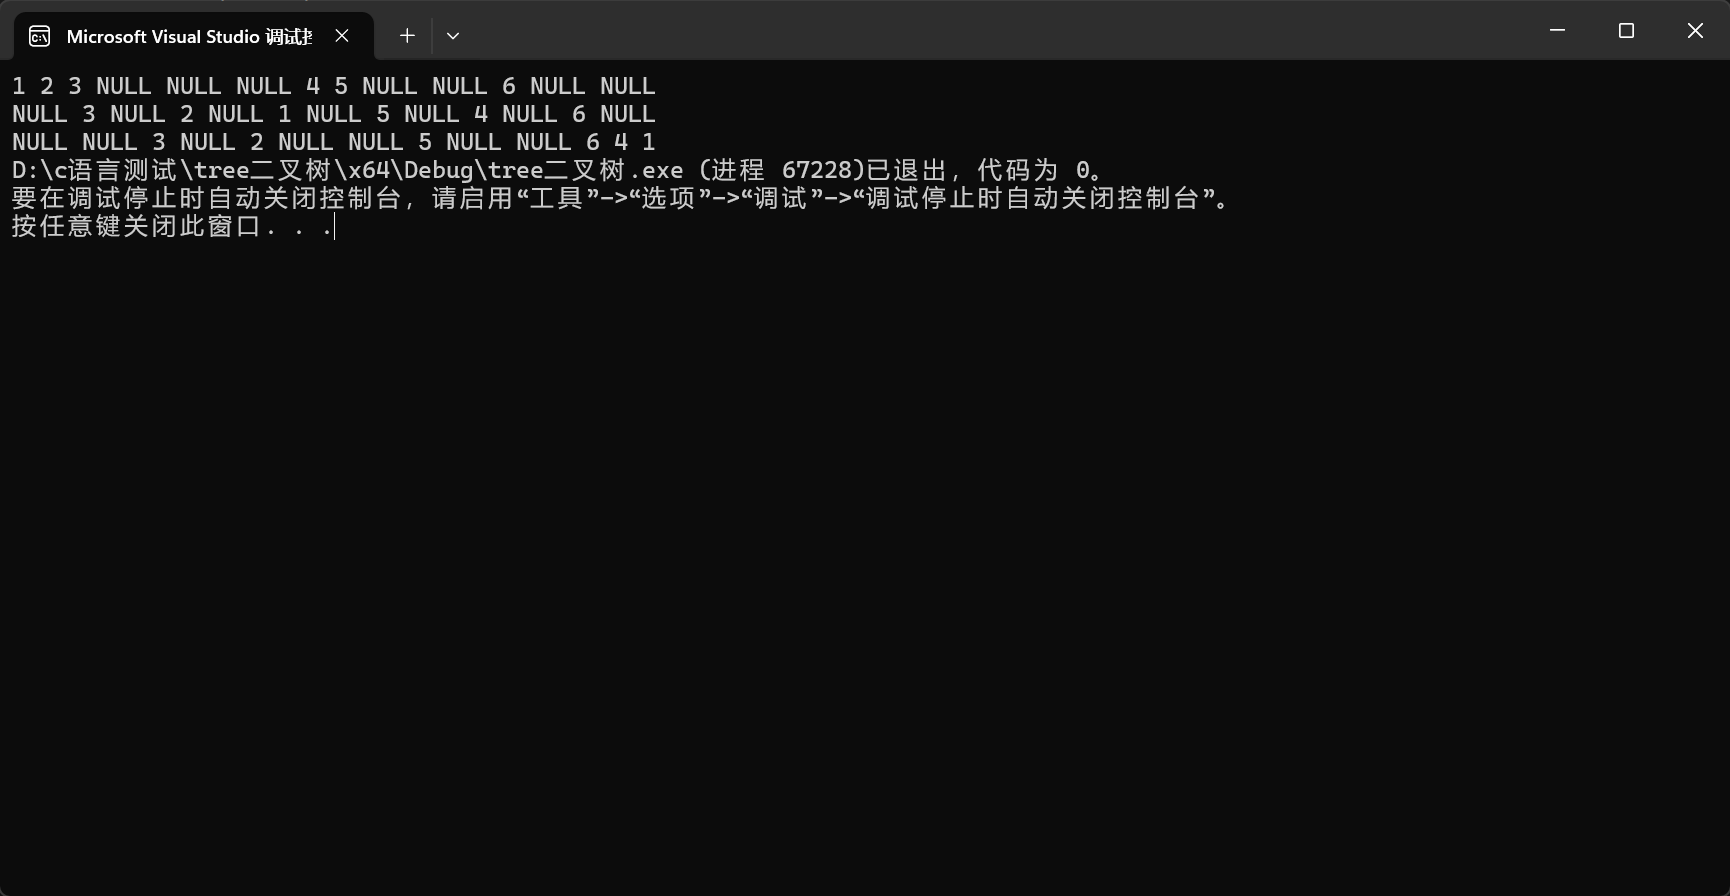
下面主要分析前序递归遍历,中序与后序图解类似
前序遍历递归图解:
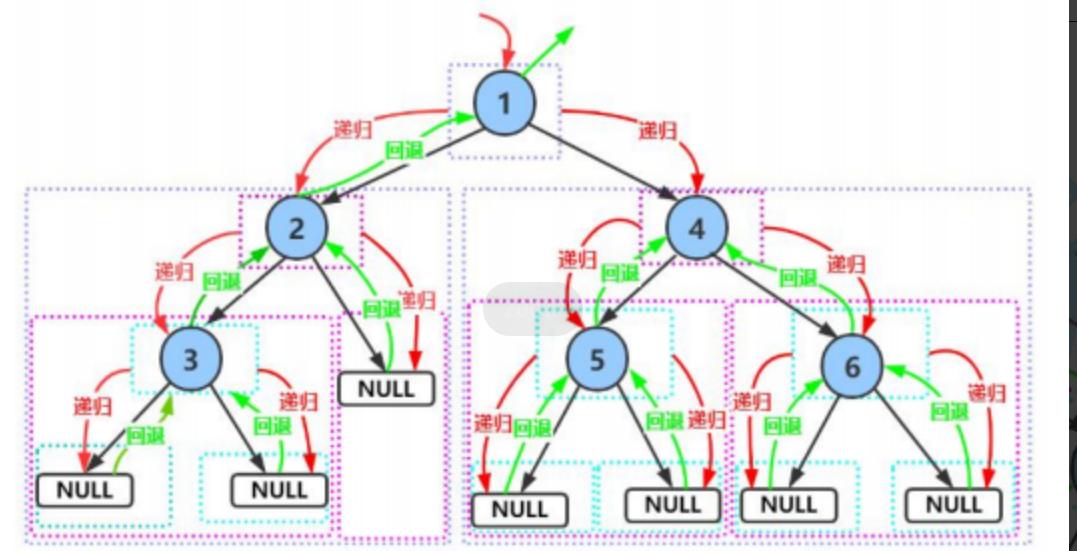
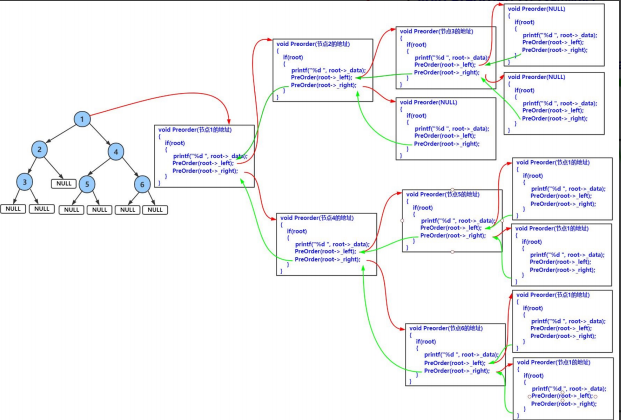
前序遍历结果: 1 2 3 4 5 6
中序遍历结果: 3 2 1 5 4 6
后序遍历结果: 3 2 5 6 4 1
4.2.2 层序遍历
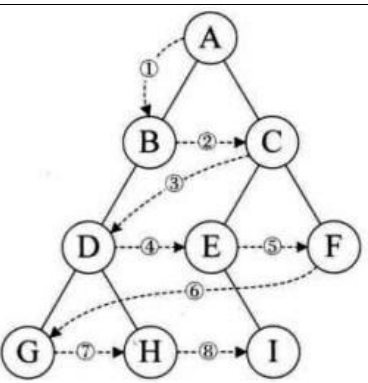
层序遍历 :除了先序遍历、中序遍历、后序遍历外,还可以对二叉树进行层序遍历。设二叉树的根节点所在
层数为 1 ,层序遍历就是从所在二叉树的根节点出发,首先访问第一层的树根节点,然后从左到右访问第 2 层
上的节点,接着是第三层的节点,以此类推,自上而下,自左至右逐层访问树的结点的过程就是层序遍历。
选择题
1. 某完全二叉树按层次输出(同一层从左到右)的序列为 ABCDEFGH 。该完全二叉树的前序序列为( )A ABDHECFGB ABCDEFGHC HDBEAFCGD HDEBFGCA2. 二叉树的先序遍历和中序遍历如下:先序遍历: EFHIGJK; 中序遍历: HFIEJKG. 则二叉树根结点为()A EB FC GD H3. 设一课二叉树的中序遍历序列: badce ,后序遍历序列: bdeca ,则二叉树前序遍历序列为 ____ 。A adbceB decabC debacD abcde4. 某二叉树的后序遍历序列与中序遍历序列相同,均为 ABCDEF ,则按层次输出(同一层从左到右)的序列为A FEDCBAB CBAFEDC DEFCBAD ABCDEF
4.3 节点个数以及高度等
// 二叉树节点个数
int BinaryTreeSize(BTNode* root);
// 二叉树叶子节点个数
int BinaryTreeLeafSize(BTNode* root);
// 二叉树第k层节点个数
int BinaryTreeLevelKSize(BTNode* root, int k);
// 二叉树查找值为x的节点
BTNode* BinaryTreeFind(BTNode* root, BTDataType x);
int TreeSize(BTNode* root)
{if (root == NULL){return 0;}else{return TreeSize(root->left) + TreeSize(root->right)+1;}}int BinaryTreeLeafSize(BTNode* root)
{if (root == NULL){return 0;}if (BinaryTreeLeafSize(root->left) == NULL && BinaryTreeLeafSize(root->right) == NULL){return 1; }return BinaryTreeLeafSize(root->left) + BinaryTreeLeafSize(root->right);
}
int TreeLevel(BTNode* root, int k)
{assert(k > 0);if (root == NULL){return 0;}if (k == 1){return 1;}return TreeLevel(root->left, k - 1) + TreeLevel(root->right, k - 1);
int TreeLevel(BTNode* root, int k)
{assert(k > 0);if (root == NULL){return 0;}if (k == 1){return 1;}return TreeLevel(root->left, k - 1) + TreeLevel(root->right, k - 1);4.4 二叉树基础oj练习
1. 单值二叉树。965. 单值二叉树 - 力扣(LeetCode)
2.检查两颗树是否相同。100. 相同的树 - 力扣(LeetCode)
3. 对称二叉树。 101. 对称二叉树 - 力扣(LeetCode)
4. 二叉树的前序遍历。 144. 二叉树的前序遍历 - 力扣(LeetCode)
5. 二叉树中序遍历 。 94. 二叉树的中序遍历 - 力扣(LeetCode)
6. 二叉树的后序遍历 。 145. 二叉树的后序遍历 - 力扣(LeetCode)
7. 另一颗树的子树。 572. 另一棵树的子树 - 力扣(LeetCode)
后续回更新怎么做
4.5 二叉树的创建和销毁
二叉树的构建及遍历。二叉树遍历_牛客题霸_牛客网 (nowcoder.com)
// 通过前序遍历的数组"ABD##E#H##CF##G##"构建二叉树
BTNode* BinaryTreeCreate(BTDataType* a, int n, int* pi);
// 二叉树销毁
void BinaryTreeDestory(BTNode** root);
// 判断二叉树是否是完全二叉树
int BinaryTreeComplete(BTNode* root);


