5.1 实验介绍
实验背景
在这个项目中,您将使用1994年美国人口普查收集的数据,选用几个监督学习算法以准确地建模被调查者的收入。然后,您将根据初步结果从中选择出最佳的候选算法,并进一步优化该算法以最好地建模这些数据。你的目标是建立一个能够准确地预测被调查者年收入是否超过50000美元的模型。这种类型的任务会出现在那些依赖于捐款而存在的非营利性组织。了解人群的收入情况可以帮助一个非营利性的机构更好地了解他们要多大的捐赠,或是否他们应该接触这些人。虽然我们很难直接从公开的资源中推断出一个人的一般收入阶层,但是我们可以(也正是我们将要做的)从其他的一些公开的可获得的资源中获得一些特征从而推断出该值。
这个项目的数据集来自UCI机器学习知识库。这个数据集是由Ron Kohavi和Barry Becker在发表文章"Scale Up the Accuracy of Naive-Bayes Classifiers: A Decision-Tree Hybrid"之后捐赠的,你可以在Ron Kohavi提供的在线版本中找到这个文章。我们在这里探索的数据集相比于原有的数据集有一些小小的改变,比如说移除了特征 以及一些遗失的或者是格式不正确的记录。'fnlwgt'
5.2 数据探索
导入数据
运行下面的代码单元以载入需要的Python库并导入人口普查数据。
注意数据集的最后一列 将是我们需要预测的列(表示被调查者的年收入会大于或者是最多50,000美元),人口普查数据中的每一列都将是关于被调查者的特征。'income'
# 引入此项目需要的库import numpy as npimport pandas as pdfrom time import timeimport matplotlib as mpl# 使用 display() 显示 DataFramefrom IPython.display import display # 引入可视化代码 visuals.pyimport visuals as vs# 让可视化更方便更美观%matplotlib inline%config InlineBackend.figure_format = 'retina'# 设置matplotlib中文显示mpl.rcParams['font.family'] = 'SimHei'mpl.rcParams['axes.unicode_minus'] = False# 载入人口普查数据try: data = pd.read_csv('census.csv') print('数据集有 {} 个样本,每个样本有 {} 个特征。'.format( *data.shape)) display(data.head())except: print('数据集无法加载,数据集丢失了吗?')数据集有 45222 个样本,每个样本有 14 个特征
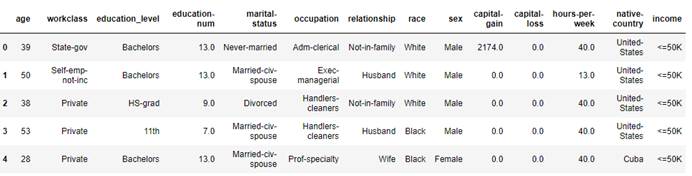
特征
- age: 一个整数,表示被调查者的年龄。
- workclass: 一个类别变量表示被调查者的通常劳动类型,允许的值有 {Private, Self-emp-not-inc, Self-emp-inc, Federal-gov, Local-gov, State-gov, Without-pay, Never-work}
- education_level: 一个类别变量表示教育程度,允许的值有 {Bachelors, Some-college, 11th, HS-grad, Prof-school, Assoc-acdm, Assoc-voc, 9th, 7th-8th, 12th, Masters, 1st-4th, 10th, Doctorate, 5th-6th, Preschool}
- education-num: 一个整数表示在学校学习了多少年
- 婚姻状态: 一个类别变量,允许的值有 {已婚-公民-配偶, 离婚, 从未结婚, 分居, 寡居, 已婚-配偶-缺席, 已婚-AF-配偶}
- 职业: 一个类别变量表示一般的职业领域,允许的值有 {Tech-support, Craft-repair, Other-service, Sales, Exec-Managemential, Prof-specialty, Handlers-cleaners, Machine-op-inspct, Adm-clerical, Farming-fishing , Transport-move, Priv-house-serv, Protective-serv, Armed Forces}
- relationship: 一个类别变量表示家庭情况,允许的值有
- race: 一个类别变量表示人种,允许的值有 {White, Asia-Pac-Islander, Amer-Indian-Eskimo, Other, Black}
- :一个类别变量表示性别,允许的值有 { Female , Male }
- 资本收益:连续值。
- 资本损失: 连续值。
- 小时/周: 连续值。
- native-country: 一个类别变量表示原始的国家,允许的值有 {美国, 柬埔寨, 英国, 波多黎各, 加拿大, 德国, Outlying-US(关岛-USVI-etc), 印度, 日本, 希腊, 南部, 中国, 古巴, 伊朗, 洪都拉斯, 菲律宾, 意大利, 波兰, 牙买加, 越南, 墨西哥, 葡萄牙, 爱尔兰, 法国, 多米尼加共和国, 老挝, 厄瓜多尔, 台湾, 海地, 哥伦比亚, 匈牙利, 危地马拉, 尼加拉瓜, 苏格兰, 泰国, 南斯拉夫, 萨尔瓦多, 特里纳达德和多巴哥, 秘鲁, 洪, 荷兰荷兰}
数据探索
首先我们对数据集进行一个粗略的探索,我们将看看每一个类别里会有多少被调查者?并且告诉我们这些里面多大比例是年收入大于 50,000 美元的。在下面的代码单元中,你将需要计算以下量:
- 总的记录数量,
'n_records' - 年收入大于50,000美元的人数,.
'n_greater_50k' - 年收入最多为50,000美元的人数 .
'n_at_most_50k' - 年收入大于50,000美元的人所占的比例, .
'greater_percent'
**提示:**您可能需要查看上面的生成的表,以了解 条目的格式是什么样的。'income'
# TODO: 总记录数n_records = len(data.index)# TODO: 个人收入超过50,000美元n_greater_50k = len(data[data['income'] != '<=50K'].index)# TODO: 个人最多可获得50,000美元n_at_most_50k = len(data[data['income'] == '<=50K'].index)# TODO: 个人收入超过5万美元的百分比greater_percent = float(n_greater_50k) / n_records * 100# 输出结果print('总记录数:{}'.format(n_records))print('个人收入超过50,000美元:{}'.format(n_greater_50k))print('个人最多可获得50,000美元:{}'.format(n_at_most_50k))print('个人收入超过5万美元的百分比:{:.2f}%'.format(greater_percent))总记录数:45222
个人收入超过50,000美元:11208
个人最多可获得50,000美元:34014
个人收入超过5万美元的百分比:24.78%
5.3 数据预处理
准备数据
在数据能够被作为输入提供给机器学习算法之前,它经常需要被清洗、格式化和重新组织 - 这通常被叫做预处理。
幸运的是,对于这个数据集,没有我们必须处理的无效或丢失的条目,然而,由于某一些特征存在的特性我们必须进行一定的调整。这个预处理都可以极大地帮助我们提升几乎所有的学习算法的结果和预测能力。
display(data.dtypes)
data.describe()
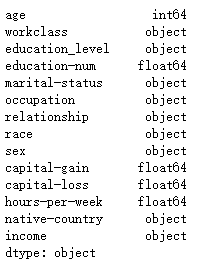
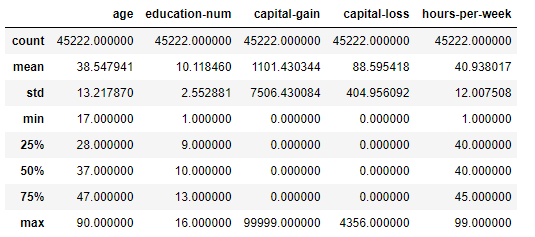
import seaborn as sns
display(data.select_dtypes(include=['int64','float64']).columns)
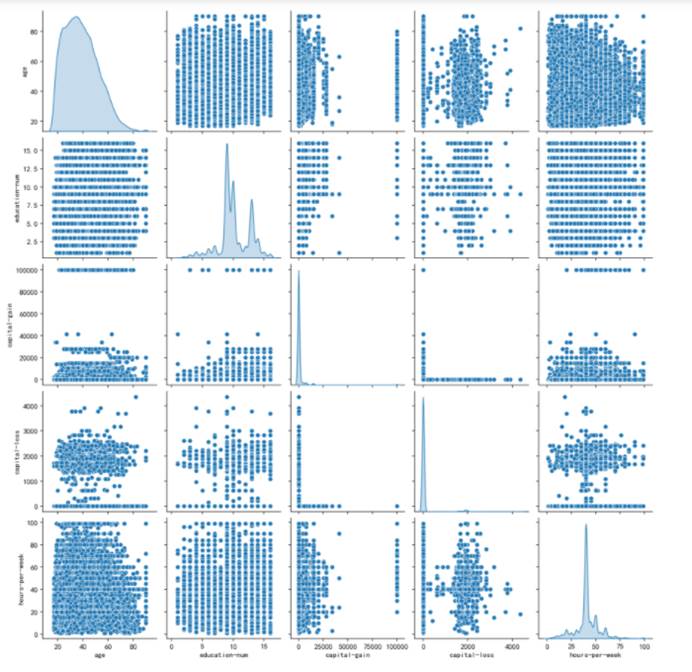
sns.pairplot(data.select_dtypes(include=['int64','float64']),diag_kind='kde')
转换倾斜的连续特征
一个数据集有时可能包含至少一个靠近某个数字的特征,但有时也会有一些相对来说存在极大值或者极小值的不平凡分布的的特征。算法对这种分布的数据会十分敏感,并且如果这种数据没有能够很好地归一化处理会使得算法表现不佳。
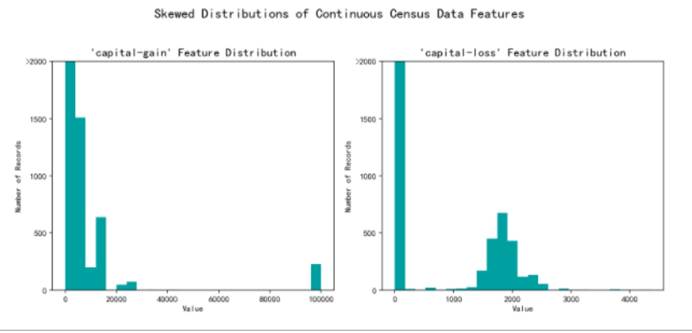
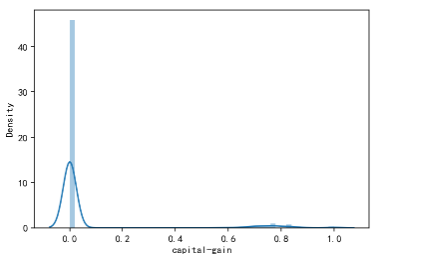
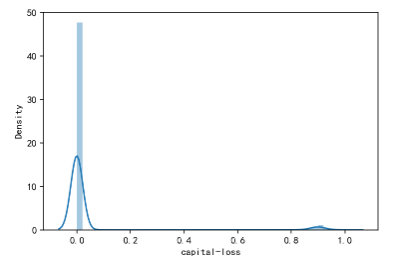
在人口普查数据集的两个特征符合这个描述: 和 。'capital-gain''capital-loss'
运行下面的代码单元以创建一个关于这两个特征的条形图。请注意当前的值的范围和它们是如何分布的。
# 将数据切分成特征和对应的标签
income_raw = data['income']
features_raw = data.drop('income', axis = 1)
# 可视化原来数据的倾斜的连续特征
vs.distribution(data)
# TODO: 用 MatplotLib 和 Seaborn 实现可视化
import matplotlib.pyplot as plt
import seaborn as sns
plt.figure(figsize=(10,5))
plt.subplot(121)
sns.distplot(data['capital-gain'])
plt.subplot(122)
sns.distplot(data['capital-loss'])
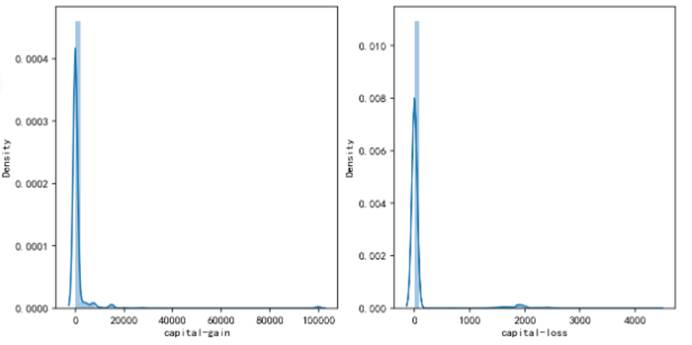
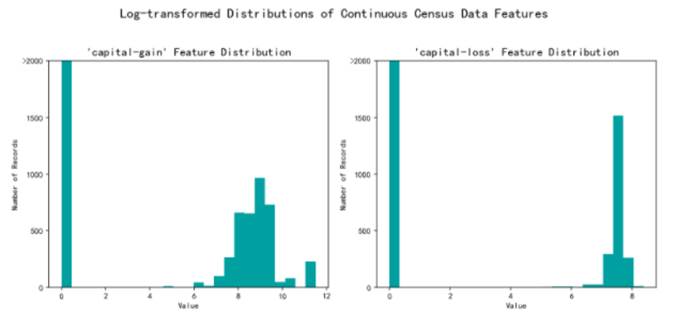
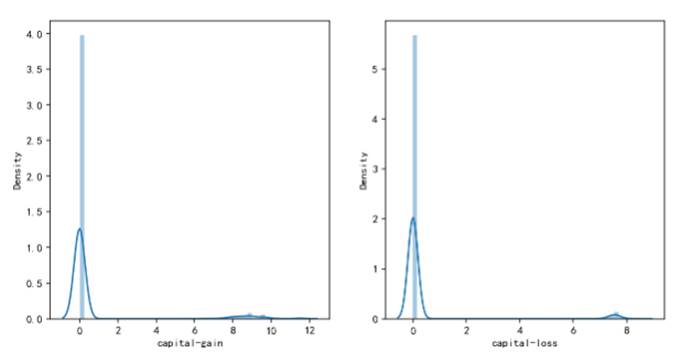
对于高度倾斜分布的特征如和,常见的做法是对数据施加一个对数转换,将数据转换成对数,这样非常大和非常小的值不会对学习算法产生负面的影响。并且使用对数变换显著降低了由于异常值所造成的数据范围异常。'capital-gain''capital-loss'
但是在应用这个变换时必须小心:因为0的对数是没有定义的,所以我们必须先将数据处理成一个比0稍微大一点的数以成功完成对数转换。
运行下面的代码单元来执行数据的转换和可视化结果。再次,注意值的范围和它们是如何分布的。
# 对于倾斜的数据使用 np.log() 函数转换
skewed = ['capital-gain', 'capital-loss']
features_log_transformed = pd.DataFrame(data = features_raw)
features_log_transformed[skewed] = features_raw[skewed].apply(lambda x: np.log(x + 1))
# 可视化对数转换后的数据分布
vs.distribution(features_log_transformed, transformed=True)
plt.figure(figsize=(10,5))
plt.subplot(121)
sns.distplot(features_log_transformed['capital-gain'])
plt.subplot(122)
sns.distplot(features_log_transformed['capital-loss'])
归一化数字特征
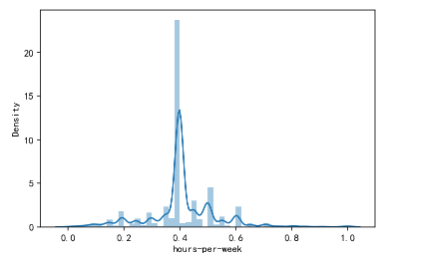
除了对于高度倾斜的特征施加转换,对数值特征施加一些形式的缩放通常会是一个好的习惯。
在数据上面施加一个缩放并不会改变数据分布的形式(比如上面说的 或 );但是归一化保证了每一个特征在使用监督学习器的时候能够被平等的对待。'capital-gain''capital-loss'
注意一旦使用了缩放,观察数据的原始形式不再具有它本来的意义了,就像下面的例子展示的。
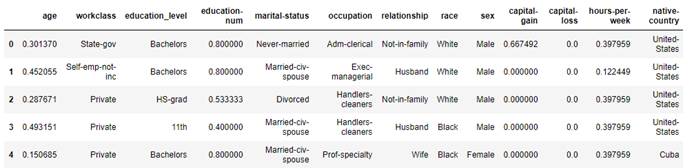
运行下面的代码单元来规一化每一个数字特征。我们将使用sklearn.preprocessing.MinMaxScaler来完成这个任务。
# 引入 sklearn.preprocessing 的 MinMaxScaler
from sklearn.preprocessing import MinMaxScaler
# 初始化一个 scaler,然后将其应用于特征
scaler = MinMaxScaler()
numerical = ['age', 'education-num', 'capital-gain', 'capital-loss', 'hours-per-week']
features_log_minmax_transform = pd.DataFrame(data = features_log_transformed)
features_log_minmax_transform[numerical] = scaler.fit_transform(features_log_transformed[numerical])
# 显示应用了 scaler 的样本示例
display(features_log_minmax_transform.head(n = 5))
for key in numerical:
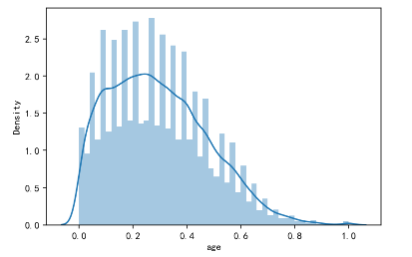
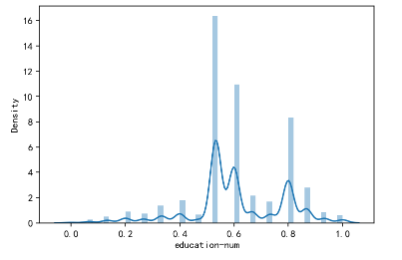
sns.distplot(features_log_transformed[key])
plt.show()
数据预处理
从上面的数据探索中的表中,我们可以看到有几个属性的每一条记录都是非数字的。通常情况下,学习算法期望输入是数字的,这要求非数字的特征(称为类别变量)被转换。转换类别变量的一种流行的方法是使用独热编码 (One-Hot编码)方案。
独热编码为每一个非数字特征的每一个可能的类别创建一个"虚拟"变量。例如,假设 有三个可能的取值 , 或者 。我们将把这个特征编码成 , 和 。someFeatureABCsomeFeature_AsomeFeature_BsomeFeature_C
| 特征 | 特征_A | 特征_B | 特征_C | ||
| 0 | B | 0 | 1 | 0 | |
| 1 | C | –>一热编码 --> | 0 | 0 | 1 |
| 2 | 一个 | 1 | 0 | 0 |
此外,对于非数字的特征,我们需要将非数字的标签 转换成数值以保证学习算法能够正常工作。因为这个标签只有两种可能的类别("<=50K" 和 ">50K"),我们不必要使用独热编码,可以直接将他们编码分别成两个类 和 ,在下面的代码单元中你将实现以下功能:'income'01
- 使用pandas.get_dummies()对 数据进行独热编码'features_raw'
- 将目标标签 转换成数字'income_raw'
-
- 将 "<=50K" 转换成0
- 将 ">50K" 转换成1
# TODO: 使用 pandas.get_dummies() 对 'features_log_minmax_transform' 数据进行独热编码
feature_object = features_log_minmax_transform.select_dtypes(include=['object'])
features_log_minmax_transform[feature_object.columns] = feature_object.apply(
lambda x: x.str.strip())
features_final = pd.get_dummies(features_log_minmax_transform)
# TODO: 将 'income_raw' 编码成为数字
income = (income_raw == '>50K').astype(np.uint8)
# 输出经过独热编码之后的特征数量
encoded = list(features_final.columns)
print('独热编码之后共有 {} 个全部特征'.format(len(encoded)))
# 移除下面一行的注释以观察编码后的特征名称
print(encoded)
独热编码之后共有 103 个
全部特征 ['age', 'education-num', 'capital-gain', 'capital-loss', '每周小时数', 'workclass_Federal-gov', 'workclass_Local-gov', 'workclass_Private', 'workclass_Self-emp-inc', 'workclass_Self workclass_State-nmp-inc', 'workclass_State-gov', 'workclass_Without-pay', 'education_level_10th', 'education_level_11th', 'education_level_12th', 'education_level_1st-4th', 'education_level_5th-6th', 'education_level_7th-8th', 'education_level_9th', 'education_level_Assoc-acdm', 'education_level_Assoc-voc', 'education_level_Bachelors', 'education_level_Doctorate', 'education_level_HS-grad', 'education_level_Masters', 'education_level_Preschool', 'education_level_Prof-school', 'education_level_Some-College', 'marital-status_Divorced', 'marital-status_Married-AF-配偶', '婚姻-status_Married-civ-配偶', '婚姻-status_Married-配偶-缺席', '婚姻-status_Never-已婚', '婚姻-status_Separated', '婚姻-status_丧偶"、"occupation_Adm文职人员"、"occupation_Armed部队"、"occupation_Craft修理"、"occupation_Exec管理"、"occupation_Farming捕鱼"、"occupation_Handlers清洁工"、"occupation_Machine行动者"、"occupation_Other服务"、"occupation_Priv服务"、"occupation_Prof专业"、"occupation_Protective服务"、"occupation_Sales"、"occupation_Tech支持"、"occupation_Transport移动"、"relationship_Husband"、"家庭relationship_Not"、"家庭relationship_Not"、""relationship _ Other 亲戚、 relationship _ Own 儿童、 relationship _ Unmarried 、 relationship _ Wife 、 race _ Amer - 印度 - 爱斯基摩人、 race _ Asian - 太平洋岛民、 race _ Black 、 race _ Other 、 race _ White 、 _ Female 、 _ Male 、本土 country _ Cambodia 、本土 country _ Canada 、本土 country _ China 、本土 country _ Columbia 、本土 country _ Cuba 、本土 country _ Dominican 共和国、本土 country _ Ecuador 、本土 country _ El 萨尔瓦多、本土 country _ England 、"本地-country_France"、"本地-country_Germany"、"本地-country_Greece"、"本地-country_Guatemala"、"本地-country_Haiti"、"本地-country_Holand-荷兰"、"本地-country_Honduras"、"本地-country_Hong"、"本地-country_Hungary"、"本地-country_India"、"本地-country_Iran"、"本地-country_Ireland"、"本地-country_Italy"、"本地-country_Jamaica"、"本地-country_Japan"、"本地-country_Laos"、"本地-country_Mexico"、"本地-country_Nicaragua', "本地country_Outlying-美国(关岛-USVI-等)"、"本地country_Peru"、"本地country_Philippines"、"本地country_Poland"、"本地country_Portugal"、"本地country_Puerto-Rico"、"本地country_Scotland"、"本地country_South"、"本地country_Taiwan"、"本地country_Thailand"、"本地country_Trinadad和多巴哥"、"本地country_United国"、"本地国家_越南"、"本地country_Yugoslavia"]
混洗和切分数据
现在所有的类别变量已被转换成数值特征,而且所有的数值特征已被规一化。和我们一般情况下做的一样,我们现在将数据(包括特征和它们的标签)切分成训练和测试集。其中 80% 的数据将用于训练和 20% 的数据用于测试。
运行下面的代码单元来完成切分。
# 引入 sklearn.model_selection 的 train_test_split
from sklearn.model_selection import train_test_split
# 将 'features' 和 'income' 数据切分成训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(
features_final,income,test_size=0.2,random_state=0)
# 显示切分的结果
print('训练集有 {} 个样本。'.format(X_train.shape[0]))
print('测试集有 {} 个样本。'.format(X_test.shape[0]))
训练集有 36177 个样本。
测试集有 9045 个样本。
5.4 评价模型性能
在这一部分中,我们将尝试四种不同的算法,并确定哪一个能够最好地建模数据。
这里面的三个将是你选择的监督学习器,而第四种算法被称为一个朴素的预测器。
评价方法和朴素的预测器
UdacityML通过他们的研究人员知道被调查者的年收入大于 $50,000 最有可能向他们捐款。因为这个原因UdacityML对于准确预测谁能够获得 $50,000 以上收入尤其有兴趣。这样看起来使用准确率作为评价模型的标准是合适的。
另外,把没有收入大于 $50,000 的人识别成年收入大于 $50,000 对于UdacityML来说是有害的,因为他想要找到的是有意愿捐款的用户。
这样,我们期望的模型具有准确预测那些能够年收入大于 $50,000 的能力比模型去召回这些被调查者更重要。我们能够使用F-beta score作为评价指标,这样能够同时考虑准确率和召回率:
F_{\beta}=(1+\beta^2)\cdot\frac{precision\ \cdot\ recall}{\left(\beta^2\ \cdot\ precision\right)+recall}Fβ=(1+β2)⋅(β2 ⋅precision )+recallprecision⋅recall
尤其是,当\beta =0.5β=0.5 个的时候跟多的强调准确率,这叫做F_{0.5}0.5 个得分(或者为了简单叫做 F-score)。
通过查看不同类别的数据分布(那些最多赚 $50,000 和那些能够赚更多的),我们能发现:很明显的是很多的被调查者年收入没有超过 $50,000。这点会显著地影响准确率,因为我们可以简单地预测说"这个人的收入没有超过$50,000",这样我们甚至不用看数据就能做到我们的预测在一般情况下是正确的!
做这样一个预测被称作是朴素的,因为我们没有任何信息去证实这种说法。通常考虑对你的数据使用一个朴素的预测器是十分重要的,这样能够帮助我们建立一个模型的表现是否好的基准。那有人说,使用这样一个预测是没有意义的:如果我们预测所有人的收入都低于 $50,000,那么UdacityML就不会有人捐款了。
注意: 准确、精密 和 召回 概要
准确度 (accuracy)衡量分类器进行正确预测的频率。它是正确预测数量与预测总数(测试数据点数量)的比率。
精确度 (precision)告诉我们,我们将哪些邮件归类为垃圾邮件,实际上是垃圾邮件。这是一个真正的肯定比例(被分类为垃圾邮件,实际上是垃圾邮件)与所有正面比率(所有被归类为垃圾邮件,无论这是否正确的分类)。
换句话说:[ 真实肯定 / ( 真实肯定 + 错误肯定) ]
召回度(敏感度) (recall)告诉我们实际上垃圾邮件的比例是由我们分类为垃圾邮件。这是真正的肯定比例(被分类为垃圾邮件,实际上是垃圾邮件)与所有实际上是垃圾邮件的比率。
换句话说:[ 真正肯定 / (真正肯定 + 错误否定)]
对于像我们这样的分类分布有偏差的分类问题,例如,如果我们有100条短信,只有2条是垃圾信息,其余98条不是,则准确度本身并不是一个很好的指标。
我们可以将90封邮件归类为非垃圾邮件(包括2封垃圾邮件,但我们将其归类为非垃圾邮件,因此它们将是错误的否定信息),10封为垃圾邮件(全部10个误报),仍然得到相当好的准确性分数。
对于这种情况,精确度和召回率非常方便。这两个指标可以合并得到F_1F1分数,这是精度和召回分数的加权平均值(调和平均值)。这个分数可以从0到1,其中1是最好的F_1F1分数(当我们处理比率时,我们采用调和平均值)。
朴素预测器的性能
如果我们选择一个无论什么情况都预测被调查者年收入大于 $50,000 的模型,那么这个模型在这个数据集上的准确率和F-score是多少?
**注意:**你必须使用下面的代码单元将你的计算结果赋值给 和 ,这些值会在后面被使用,请注意这里不能使用scikit-learn,你需要根据公式自己实现相关计算。'accuracy''fscore'
# TODO: 计算准确率accuracy = income.mean()# TODO: 使用上面的公式,并设置 `beta=0.5` 计算 F-scoreprediction = np.ones(len(income))beta2 = 0.5 ** 2recall = 1precision = accuracyfscore = (1 + beta2) * precision * recall / (beta2 * precision + recall)# 输出结果print('朴素预测器得分:[ 准确度: {:.4f},F-score: {:.4f}]'.format( accuracy, fscore))朴素预测器得分:[ 准确度: 0.2478,F-score: 0.2917]5.5 监督学习模型
下面的监督学习模型是现在在scikit-learn中你能够选择的模型
- 朴素贝叶斯 (GaussianNB)
- 决策树
- 集成方法 (Bagging, AdaBoost, Random Forest, Gradient Boosting)
- K近邻 (KNeighbors)
- 随机梯度下降分类器 (SGDC)
- 支撑向量机 (SVM)
- 物流回归
创建一个训练和预测的管道
为了正确评估你选择的每一个模型的性能,创建一个能够帮助你快速有效地使用不同大小的训练集并在测试集上做预测的训练和测试的流水线是十分重要的。
你在这里实现的功能将会在接下来的部分中被用到。在下面的代码单元中,你将实现以下功能:
- 从sklearn.metrics中导入 和fbeta_scoreaccuracy_score
- 用样例训练集拟合学习器,并记录训练时间
- 用学习器来对训练集进行预测并记录预测时间
- 在最前面的 500 个训练数据上做预测
- 计算训练数据和测试数据的准确率
- 计算训练数据和测试数据的 F-score
# TODO: 从 sklearn.metrics 中导入 fbeta_score 和 accuracy_score
from sklearn.metrics import fbeta_score, accuracy_score
def train_predict(learner, sample_size, X_train, y_train, X_test, y_test):
'''
输入:
- learner: 要训练和预测的机器学习算法
- sample_size: 从训练集中抽取的样本(数量)的大小
- X_train: 特征训练集
- y_train: 目标培训集
- X_test: 特征测试集
- y_test: 目标测试集
'''
results = {}
# TODO: 使用 sample_size 大小的训练数据来拟合 learner
start = time() # 获取开始时间
learn = learner.fit(X_train[:sample_size], y_train[:sample_size])
end = time() # 获取结束时间
# TODO: 计算训练时间
results['train_time'] = end - start
# TODO: 获得测试集 (X_test) 的预测结果,
# 然后使用 .predict() 获得前300个训练样本 (X_train) 的预测值。
start = time() # 获取开始时间
predictions_test = learner.predict(X_test)
predictions_train = learner.predict(X_train[:300])
end = time() # 获取结束时间
# TODO: 计算预测用时
results['pred_time'] = end - start
# TODO: 计算前300个训练样本的准确率
results['acc_train'] = accuracy_score(y_train[:300], predictions_train)
# TODO: 计算测试集的准确率
results['acc_test'] = accuracy_score(y_test, predictions_test)
# TODO: 计算前300个训练样本的准确率
results['f_train'] = fbeta_score(y_train[:300], predictions_train, 0.5)
# TODO: 计算测试集的F-score
results['f_test'] = fbeta_score(y_test, predictions_test, 0.5)
# 成功
print(' {} 对 {} 个样本进行了训练。'.format(
learner.__class__.__name__, sample_size))
# 返回结果
return results
初始模型的评估
在下面的代码单元中,您将需要实现以下功能:
- 导入你在前面的讨论的三个监督学习模型。
- 初始化三模型并存储在 , 和 中。'clf_A''clf_B''clf_C'
-
- 如果可能对每一个模型都设置一个 。random_state
- **注意:**这里先使用每一个模型的默认参数,在接下来的部分中你将需要对某一个模型的参数进行调整。
- 计算记录的数目等于 1%,10% 和 100% 的训练数据,并将这些值存储在 中'samples'
**注意:**取决于你选择的算法,下面实现的代码可能需要一些时间来运行!
# TODO: 从 sklearn 中导入三个监督学习模型
# 下面是所有算法的示例
# 1. 朴素贝叶斯 (GaussianNB)
# 2. 决策树
# 3. 集成方法 (AdaBoost)
# 4. 集成方法 (Random Forest)
# 5. 集成方法 (Gradient Boosting)
# 6. K近邻 (KNeighbors)
# 7. 随机梯度下降分类器 (SGDC)
# 8. 支撑向量机 (SVM)
# 9. Logistic回归
# 10. XGBClassifier
from sklearn.naive_bayes import GaussianNB
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import AdaBoostClassifier
from sklearn.ensemble import RandomForestClassifier
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.linear_model import SGDClassifier
from sklearn.svm import SVC
from sklearn.linear_model import LogisticRegression
# TODO: 初始化三个模型
clf_A = GaussianNB()
clf_B = DecisionTreeClassifier(random_state=42)
clf_C = AdaBoostClassifier(random_state=42)
clf_D = RandomForestClassifier(random_state=42)
clf_E = GradientBoostingClassifier(random_state=42)
clf_F = KNeighborsClassifier()
clf_G = SGDClassifier(max_iter=1000, tol=1e-3,random_state=42)
clf_H = SVC(random_state=42)
clf_I = LogisticRegression(random_state=42)
# TODO: 计算 1%,10%,100% 的训练数据分别对应多少个数据点
samples_1 = int(0.01*len(X_train))
samples_10 = int(0.1*len(X_train))
samples_100 = len(X_train)
# 收集学习器的结果
results = {}
for clf in [clf_D, clf_C, clf_E]: #[clf_A, clf_B, clf_C, clf_D, clf_E, clf_F, clf_G, clf_H, clf_I, clf_J]:
clf_name = clf.__class__.__name__
results[clf_name] = {}
for i, samples in enumerate([samples_1, samples_10, samples_100]):
results[clf_name][i] = train_predict(
clf, samples, X_train, y_train, X_test, y_test)
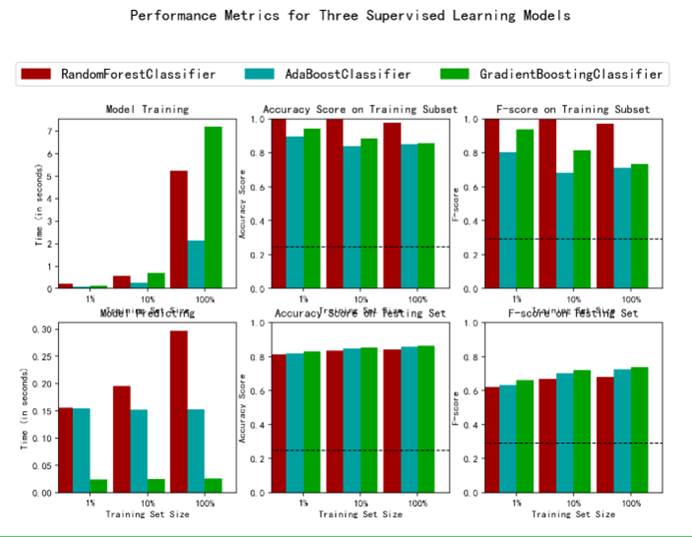
# 对选择的三个模型得到的评价结果进行可视化
vs.evaluate(results, accuracy, fscore)
RandomForestClassifier 对 361 个样本进行了训练。
RandomForestClassifier 对 3617 个样本进行了训练。
RandomForestClassifier 对 36177 个样本进行了训练。
AdaBoostClassifier 对 361 个样本进行了训练。
AdaBoostClassifier 对 3617 个样本进行了训练。
AdaBoostClassifier 对 36177 个样本进行了训练。
GradientBoostingClassifier 对 361 个样本进行了训练。
GradientBoostingClassifier 对 3617 个样本进行了训练。
GradientBoostingClassifier 对 36177 个样本进行了训练。
提高效果
在这最后一节中,您将从三个有监督的学习模型中选择 最好的模型来使用数据。
你将在整个训练集( 和 )上通过使用网格搜索优化至少调节一个参数以获得一个比没有调节之前更好的 F-score。X_trainy_train
模型调优
调节选择的模型的参数。使用网格搜索 来至少调整模型的重要参数(至少调整一个),这个参数至少需给出并尝试3个不同的值。你要使用整个训练集来完成这个过程。在接下来的代码单元中,你需要实现以下功能:'GridSearchCV'
- 导入sklearn.grid_search.gridSearchCV和sklearn.metrics.make_scorer
- 初始化你选择的分类器,并将其存储在 中。clf
-
- 如果能够设置的话,设置random_state
- 创建一个对于这个模型你希望调整参数的字典。
-
- 例如: 。parameters = {'parameter' : [list of values]}
- **注意:**如果你的学习器(学习者)有 参数,请不要调节它!max_features
- 使用 来创建一个 评分对象(设置make_scorerfbeta_score\beta =0.5β=0.5 个)。
- 在分类器 上用 作为评价函数运行网格搜索,并将结果存储在 中。clf'scorer'grid_obj
- 用训练集(, )训练 ,并将结果存储在 中。X_trainy_traingrid_objgrid_fit
**注意:**取决于你选择的参数列表,下面实现的代码可能需要花一些时间运行!
# TODO: 导入 GridSearchCV, make_scorer
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import AdaBoostClassifier
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.metrics import accuracy_score
from sklearn.metrics import fbeta_score
from sklearn.metrics import make_scorer
# TODO: 初始化分类器
clf_lr = LogisticRegression(random_state=42)
clf_ada = AdaBoostClassifier(random_state=42)
clf_gb = GradientBoostingClassifier(random_state=42)
# TODO: 创建您希望调优的参数列表
# LogisticRegression 参数列表
solver_lr = 'newton-cg liblinear'.split()
c_lr = np.logspace(-2,1,4)
param_grid_lr = dict(
solver=solver_lr,
C=c_lr
)
# AdaBoostClassifier 参数列表
n_estimators_ada = range(150,180,10)
learning_rate_ada = [x/10 for x in range(13,16)]
param_grid_ada = dict(
n_estimators=n_estimators_ada,
learning_rate=learning_rate_ada
)
# GradientBoostingClassifier 参数列表
max_depth_gb = range(5,8)
learning_rate_gb = np.logspace(-2,0,3)
n_estimators_gb = range(120,150,10)
param_grid_gb = dict(
n_estimators=n_estimators_gb,
learning_rate=learning_rate_gb,
max_depth=max_depth_gb
)
# TODO: 创建一个 fbeta_score 打分对象
scorer = make_scorer(fbeta_score)
# TODO: 在分类上使用网格搜索,使用 scorer 作为评价函数
# 使用 LogisticRegression 分类器
# grid_obj = GridSearchCV(clf_lr,param_grid_lr)
# 未优化的模型
# ------
# 测试数据的准确性评分:0.8630
# 测试数据的F得分:0.7395
# 使用 AdaBoostClassifier 分类器
grid_obj = GridSearchCV(clf_ada,param_grid_ada)
# 优化模型
# ------
# 测试数据的最终准确度分数:0.8649
# 测试数据的最终F得分:0.7398
# 使用 GradientBoostingClassifier 分类器
# grid_obj = GridSearchCV(clf_gb,param_grid_gb)
# 优化模型
# ------
# 测试数据的最终准确度分数:0.8706
# 测试数据的最终F得分:0.7511
# TODO: 用训练数据拟合网格搜索对象并找出最佳参数
grid_fit = grid_obj.fit(X_train, y_train)
# 得到最佳参数
best_clf = grid_fit.best_estimator_
# 使用没有调优的模型进行预测
predictions = (clf.fit(X_train, y_train)).predict(X_test)
best_predictions = best_clf.predict(X_test)
print('未优化的模型\n------')
print('测试数据的准确性评分:{:.4f}'.format(
accuracy_score(y_test, predictions)))
print('测试数据的F得分:{:.4f}'.format(
fbeta_score(y_test, predictions, beta=0.5)))
print('\n优化模型\n------')
print('测试数据的最终准确度分数:{:.4f}'.format(
accuracy_score(y_test, best_predictions)))
print('测试数据的最终F得分:{:.4f}'.format(
fbeta_score(y_test, best_predictions, beta=0.5)))
print('\n调优后的参数\n------')
print(grid_fit.best_params_)
print(best_clf.get_params())
未优化的模型
测试数据的准确性评分:0.8630
测试数据的F得分:0.7395
优化模型
测试数据的最终准确度分数:0.8649
测试数据的最终F得分:0.7398
调优后的参数
{'learning_rate': 1.4, 'n_estimators': 160}
{'algorithm': 'SAMME.R', 'base_estimator': None, 'learning_rate': 1.4, 'n_estimators': 160, 'random_state': 42}
5.6 最终模型评估
结果
| 评价指标 | 朴素预测器 | 未优化模型 | 优化后模型 |
| 准确率 | 0.2478 | 0.8630 | 0.8649 |
| F得分 | 0.2917 | 0.7395 | 0.7398 |
特征的重要性
在数据上(比如我们这里使用的人口普查的数据)使用监督学习算法的一个重要的任务是决定哪些特征能够提供最强的预测能力。
通过专注于一些少量的有效特征和标签之间的关系,我们能够更加简单地理解这些现象,这在很多情况下都是十分有用的。在这个项目的情境下这表示我们希望选择一小部分特征,这些特征能够在预测被调查者是否年收入大于 $50,000 这个问题上有很强的预测能力。
选择一个有 属性(这是一个根据这个选择的分类器来对特征的重要性进行排序的函数)的scikit学习分类器(例如,AdaBoost,随机森林)。在下一个Python代码单元中用这个分类器拟合训练集数据并使用这个属性来决定这个人口普查数据中最重要的5个特征。feature_importance_
提取特征重要性
选择一个 中有 属性的监督学习分类器分类器,这个属性是一个在做预测的时候根据所选择的算法来对特征重要性进行排序的功能。scikit-learnfeature_importance_
在下面的代码单元中,你将要实现以下功能:
- 如果这个模型和你前面使用的三个模型不一样的话从 sklearn 中导入一个监督学习模型。
- 在整个训练集上训练一个监督学习模型。
- 使用模型中的 提取特征的重要性。.feature_importances_
# TODO: 导入一个拥有 'feature_importances_' 的监督学习模型
from xgboost import XGBClassifier
# TODO: 在训练集上建立一个监督学习模型
model = XGBClassifier()
model.fit(X_train, y_train)
# TODO: 提取特征重要性
importances = model.feature_importances_
# 绘制特征重要性
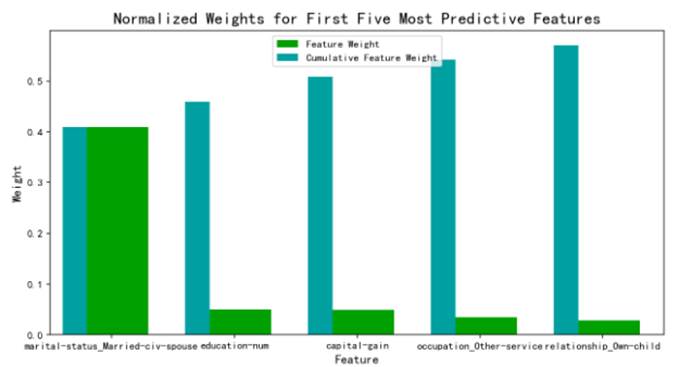
vs.feature_plot(importances, X_train, y_train)
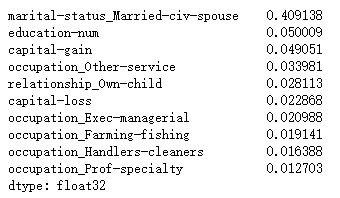
pd.Series(importances,index=X_train.columns).sort_values(ascending=False)[:10]
特征选择
如果我们只是用可用特征的一个子集的话模型表现会怎么样?
通过使用更少的特征来训练,在评价指标的角度来看我们的期望是训练和预测的时间会更少。
从上面的可视化来看,我们可以看到前五个最重要的特征贡献了数据中所有特征中超过一半的重要性。
这提示我们可以尝试去减小特征空间,并简化模型需要学习的信息。下面代码单元将使用你前面发现的优化模型,并只使用五个最重要的特征在相同的训练集上训练模型。
np.argsort(importances)[::-1][:5]
array([2, 0, 3, 1, 4])
# 导入模型克隆功能
from sklearn.base import clone
# 减小特征空间
X_train_reduced = X_train[X_train.columns.values[(np.argsort(importances)[::-1])[:5]]]
X_test_reduced = X_test[X_test.columns.values[(np.argsort(importances)[::-1])[:5]]]
# 克隆之前得到的最优模型继续训练
clf = (clone(best_clf)).fit(X_train_reduced, y_train)
# 做出一个新的预测
reduced_predictions = clf.predict(X_test_reduced)
# 输出每一个版本的数据应用最终模型的分数
print('最终模型接受完整数据的训练\n------')
print('测试数据的准确性:{:.4f}'.format(
accuracy_score(y_test,best_predictions)))
print('测试数据的F分数:{:.4f}'.format(
fbeta_score(y_test,reduced_predictions,0.5)))
print('\n最终模型接受压缩数据的训练\n------')
print('测试数据的准确性:{:.4f}'.format(
accuracy_score(y_test,best_predictions)))
print('测试数据的F分数:{:.4f}'.format(
fbeta_score(y_test,reduced_predictions,0.5)))
最终模型接受完整数据的训练
测试数据的准确性:0.8649
测试数据的F分数:0.6855
最终模型接受压缩数据的训练
测试数据的准确性:0.8649
测试数据的F分数:0.6855


 day_02)


