尚硅谷大数据项目【电商数仓6.0】企业数据仓库项目_bilibili
数据流转过程
用户➡️业务服务器➡️数据库存储➡️数仓统计分析➡️数据可视化
· 数据仓库处理流程:数据源➡️加工数据➡️统计筛选数据➡️分析数据
数据库不是为了数据仓库服务的,需要给数仓单独构建一个数据源(行式列式存储不对应、数据库海量数据不满足、对mysql性能造成影响)
数据源周期性(一天、一周)从mysql数据库同步过来,这就叫采集
HDFS承前启后
数据存储file➡️ Flume采集 ➡️HDFS➡️Hive数仓数据源
数据 mysql➡️DataX/Maxwell➡️HDFS➡️Hive数仓数据源
数仓开发需要用sql,需要用结构化数据
一些概念
数据仓库的输入数据通常包括:业务数据、用户行为数据和爬虫数据等
业务数据:就是各行业在处理事务过程中产生的数据。比如用户在电商网站中登录、下单、支付等过程中,需要和网站后台数据库进行增删改查交互,产生的数据就是业务数据。业务数据通常存储在MySQL、Oracle等数据库中。
用户行为数据:用户在使用产品过程中,通过埋点收集与客户端产品交互过程中产生的数据,并发往日志服务器进行保存。比如页面浏览、点击、停留、评论、点赞、收藏等。用户行为数据通常存储在日志文件中。
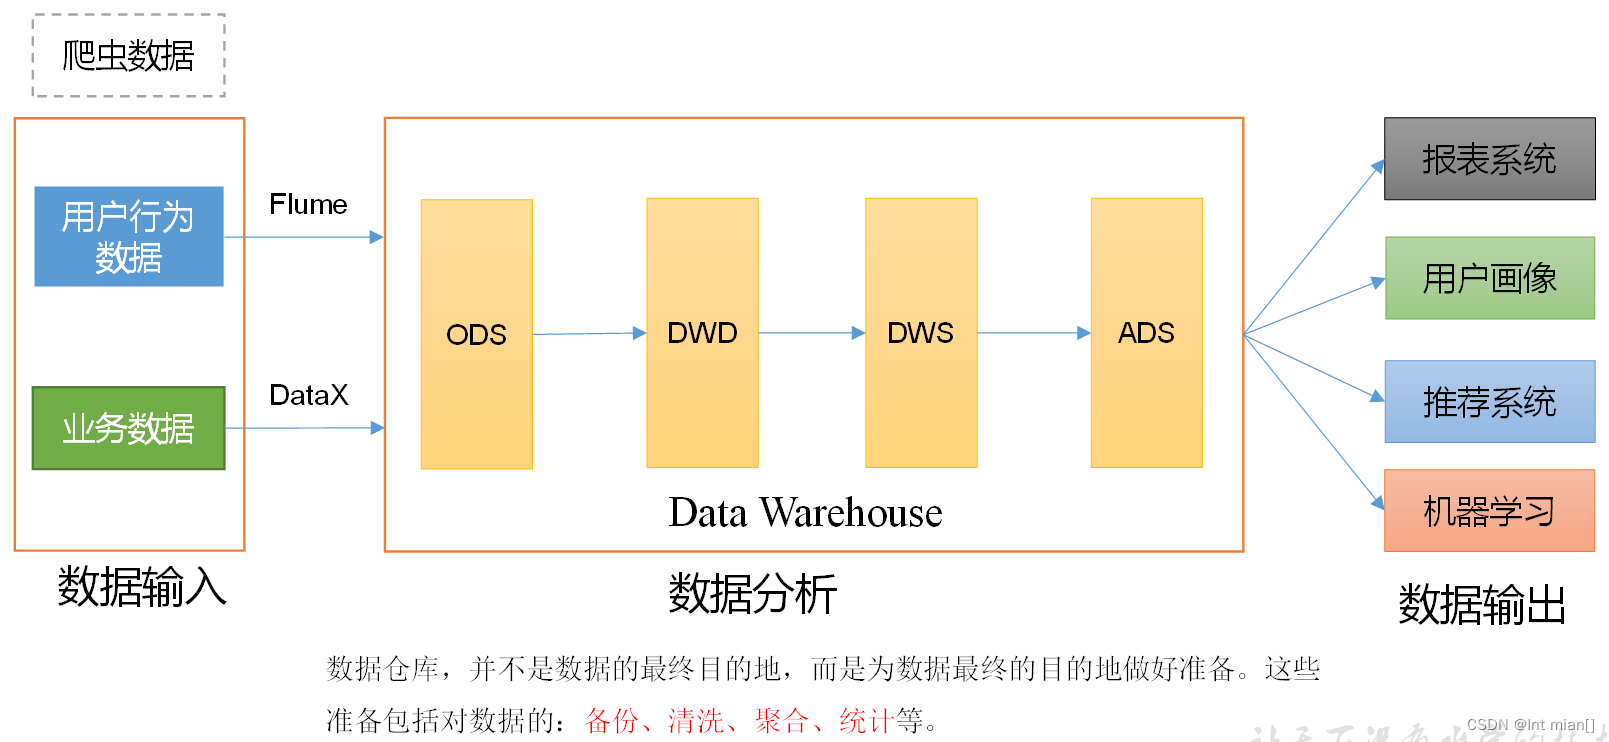
项目需求与架构设计
需求
(1)用户行为数据采集平台搭建
(2)业务数据采集平台搭建
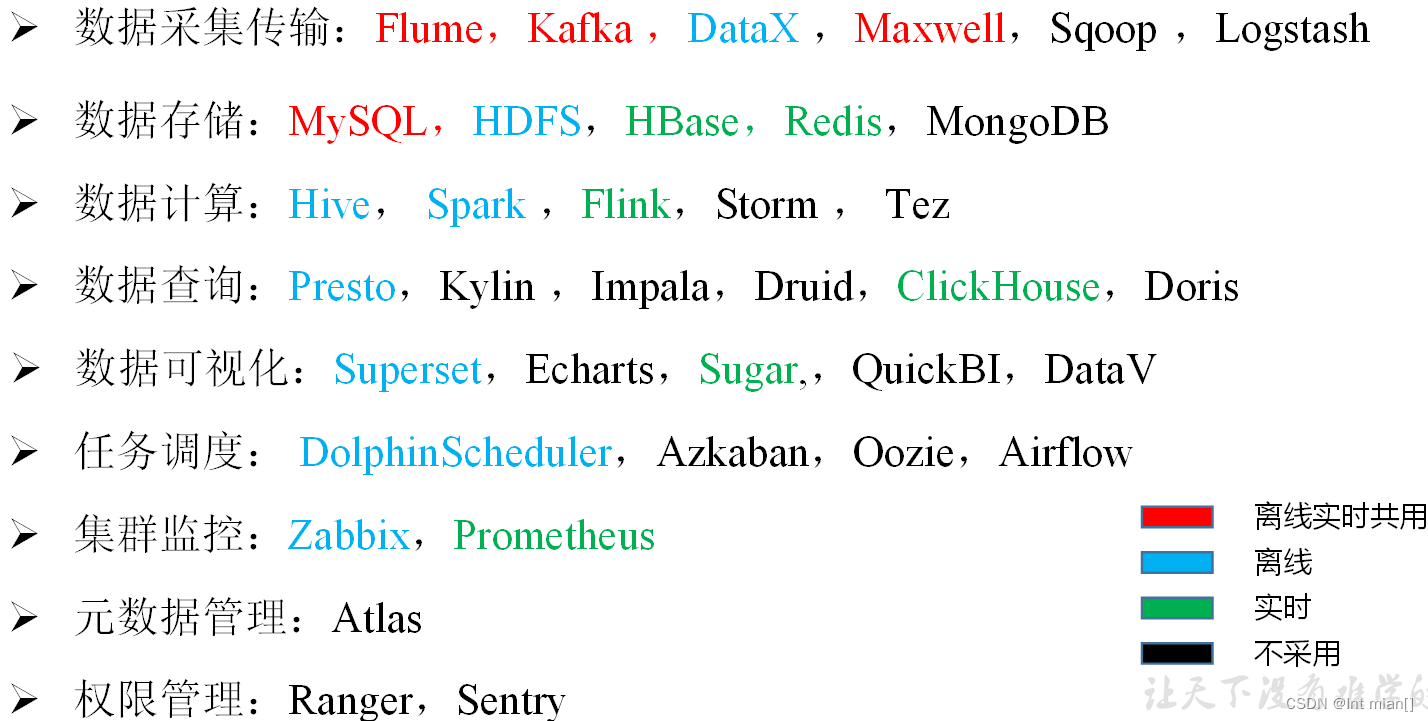
离线与实时采集需求
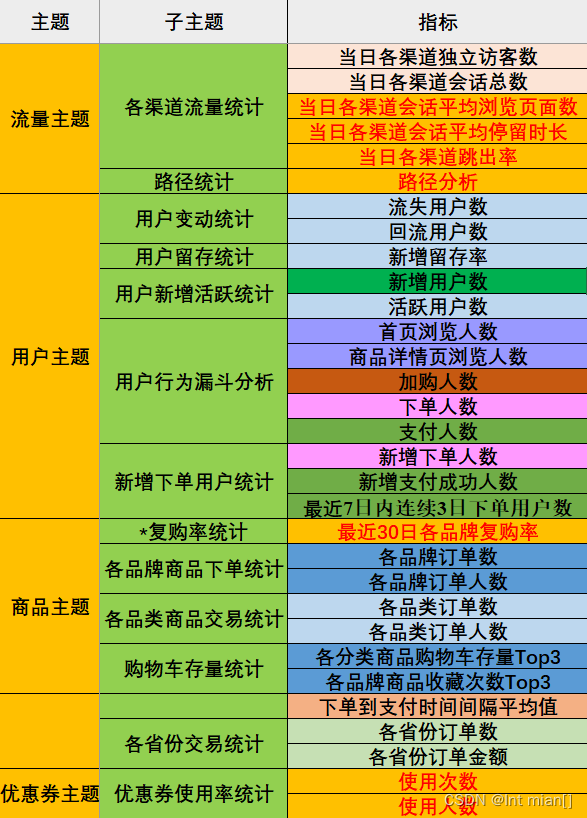
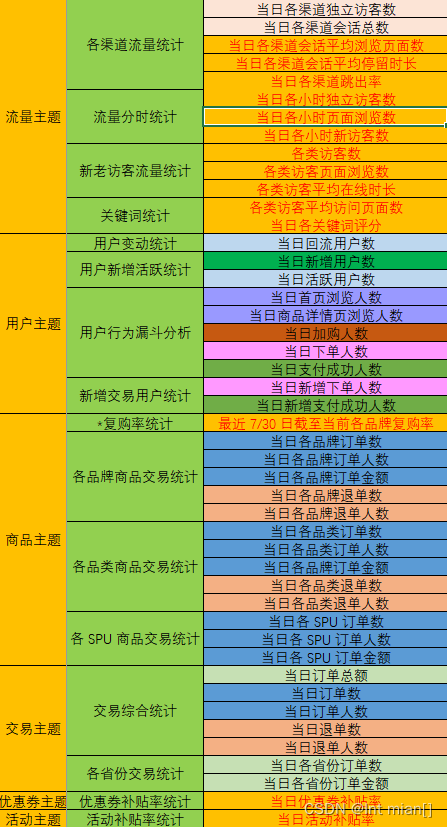
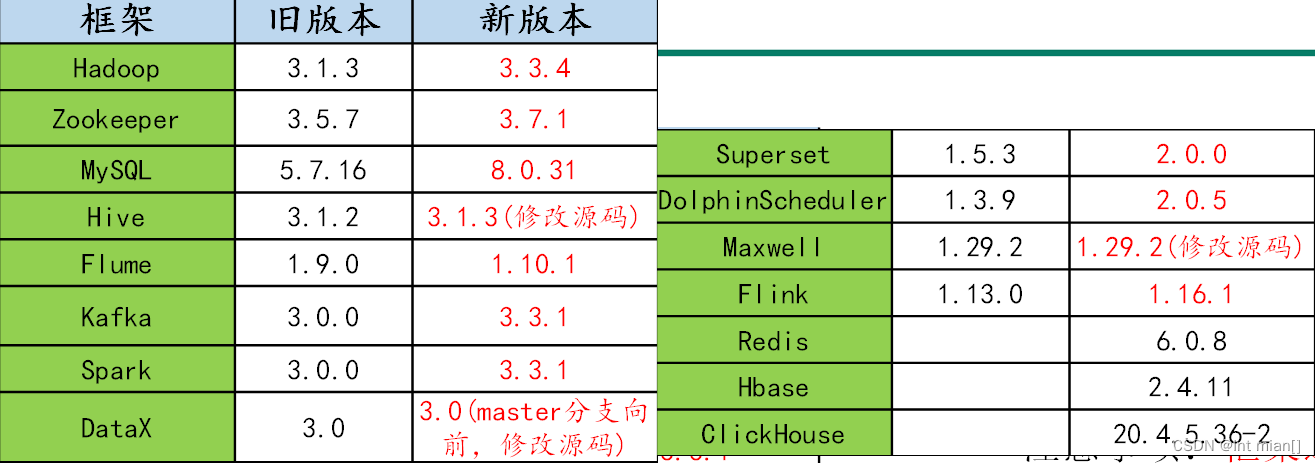
技术选型
- Master节点:管理节点,保证集群的调度正常进行;主要部署NameNode、ResourceManager、HMaster 等进程;非 HA 模式下数量为1,HA 模式下数量为2。
- Core节点:为计算及存储节点,您在 HDFS 中的数据全部存储于 core 节点中,因此为了保证数据安全,扩容 core 节点后不允许缩容;主要部署 DataNode、NodeManager、RegionServer 等进程。非 HA 模式下数量≥2,HA 模式下数量≥3。
- Common 节点:为 HA 集群 Master 节点提供数据共享同步以及高可用容错服务;主要部署分布式协调器组件,如 ZooKeeper、JournalNode 等节点。非HA模式数量为0,HA 模式下数量≥3。
| 服务名称 | 子服务 | 服务器 hadoop102 | 服务器 hadoop103 | 服务器 hadoop104 |
| HDFS | NameNode | √ | ||
| DataNode | √ | √ | √ | |
| SecondaryNameNode | √ | |||
| Yarn | NodeManager | √ | √ | √ |
| Resourcemanager | √ | |||
| Zookeeper | Zookeeper Server | √ | √ | √ |
| Flume(采集日志) | Flume | √ | √ | |
| Kafka | Kafka | √ | √ | √ |
| Flume (消费Kafka日志) | Flume | √ | ||
| Flume (消费Kafka业务) | Flume | √ | ||
| Hive | √ | √ | √ | |
| MySQL | MySQL | √ | ||
| DataX | √ | √ | √ | |
| Spark | √ | √ | √ | |
| DolphinScheduler | ApiApplicationServer | √ | ||
| AlertServer | √ | |||
| MasterServer | √ | |||
| WorkerServer | √ | √ | √ | |
| LoggerServer | √ | √ | √ | |
| Superset | Superset | √ | ||
| Flink | √ | |||
| ClickHouse | √ | |||
| Redis | √ | |||
| Hbase | √ | |||
| 服务数总计 | 20 | 11 | 12 |
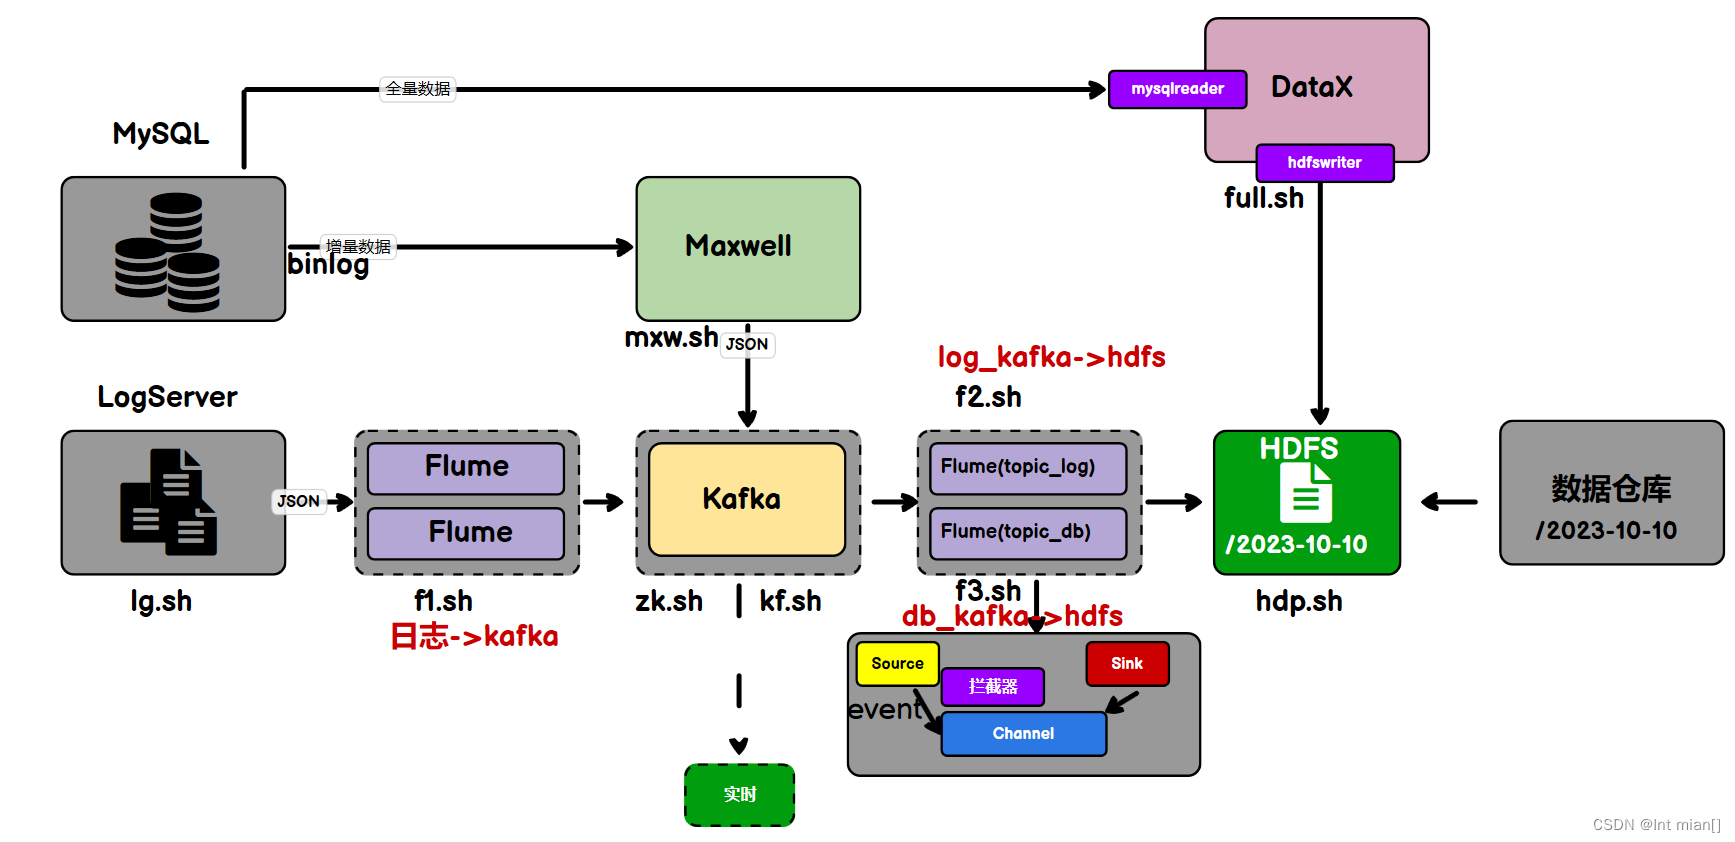
架构
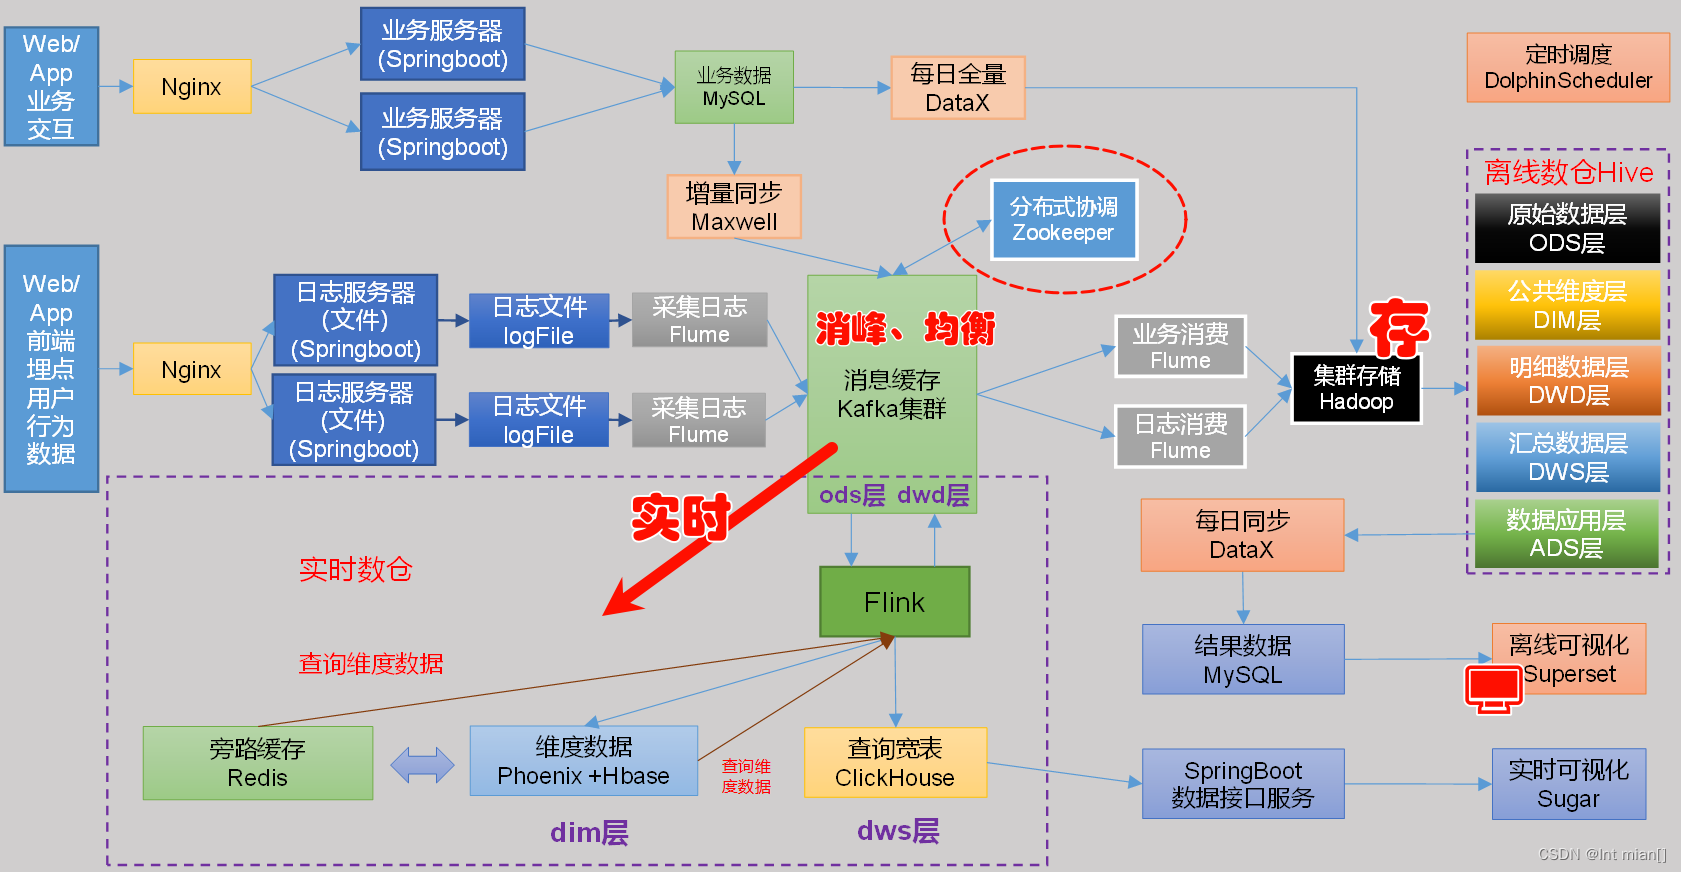
--- 回头看整个采集大流程 ---
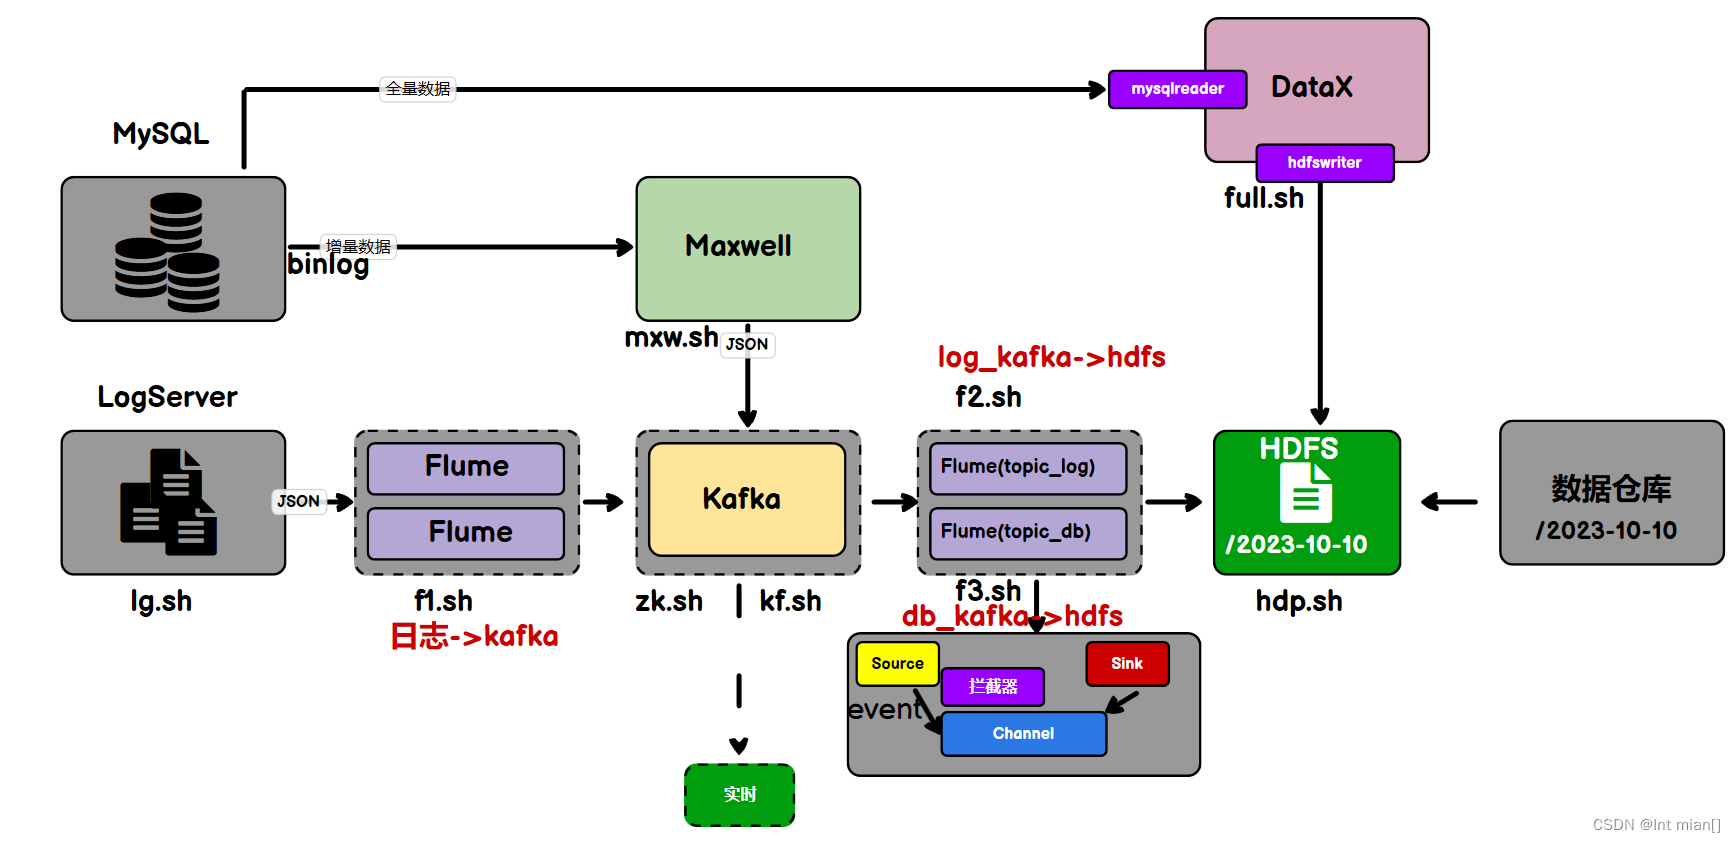
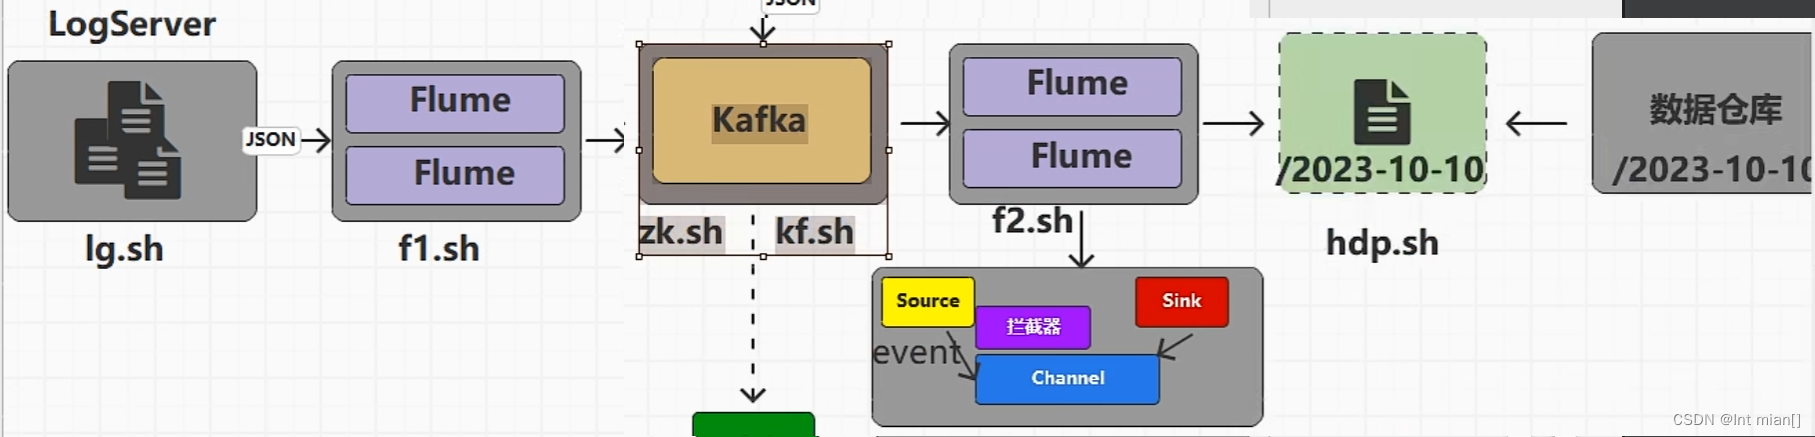
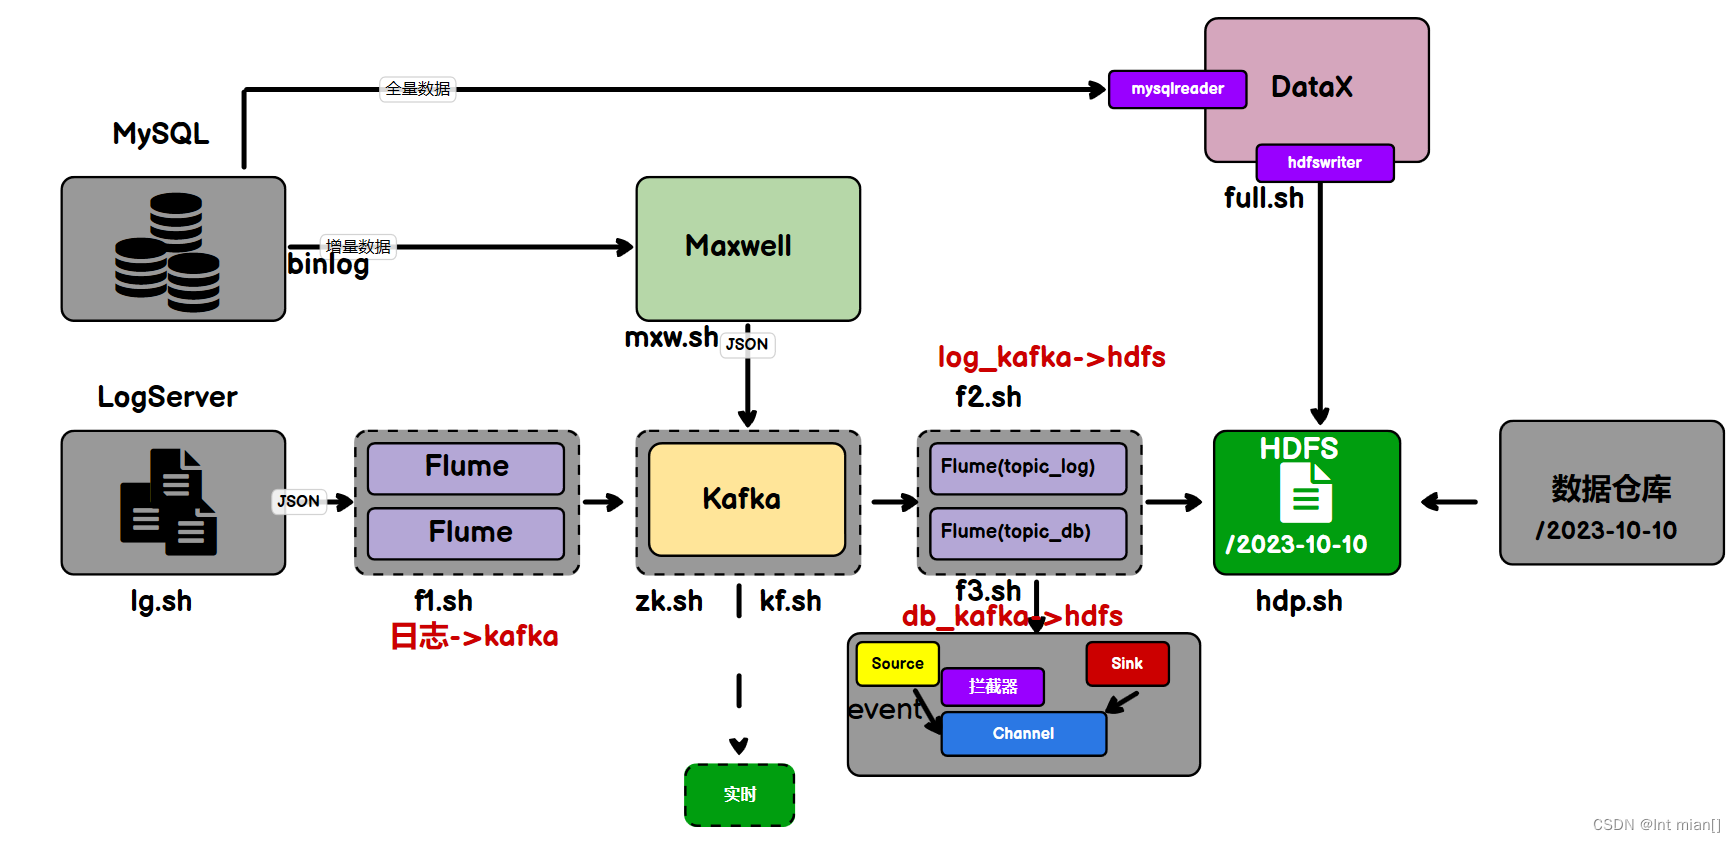
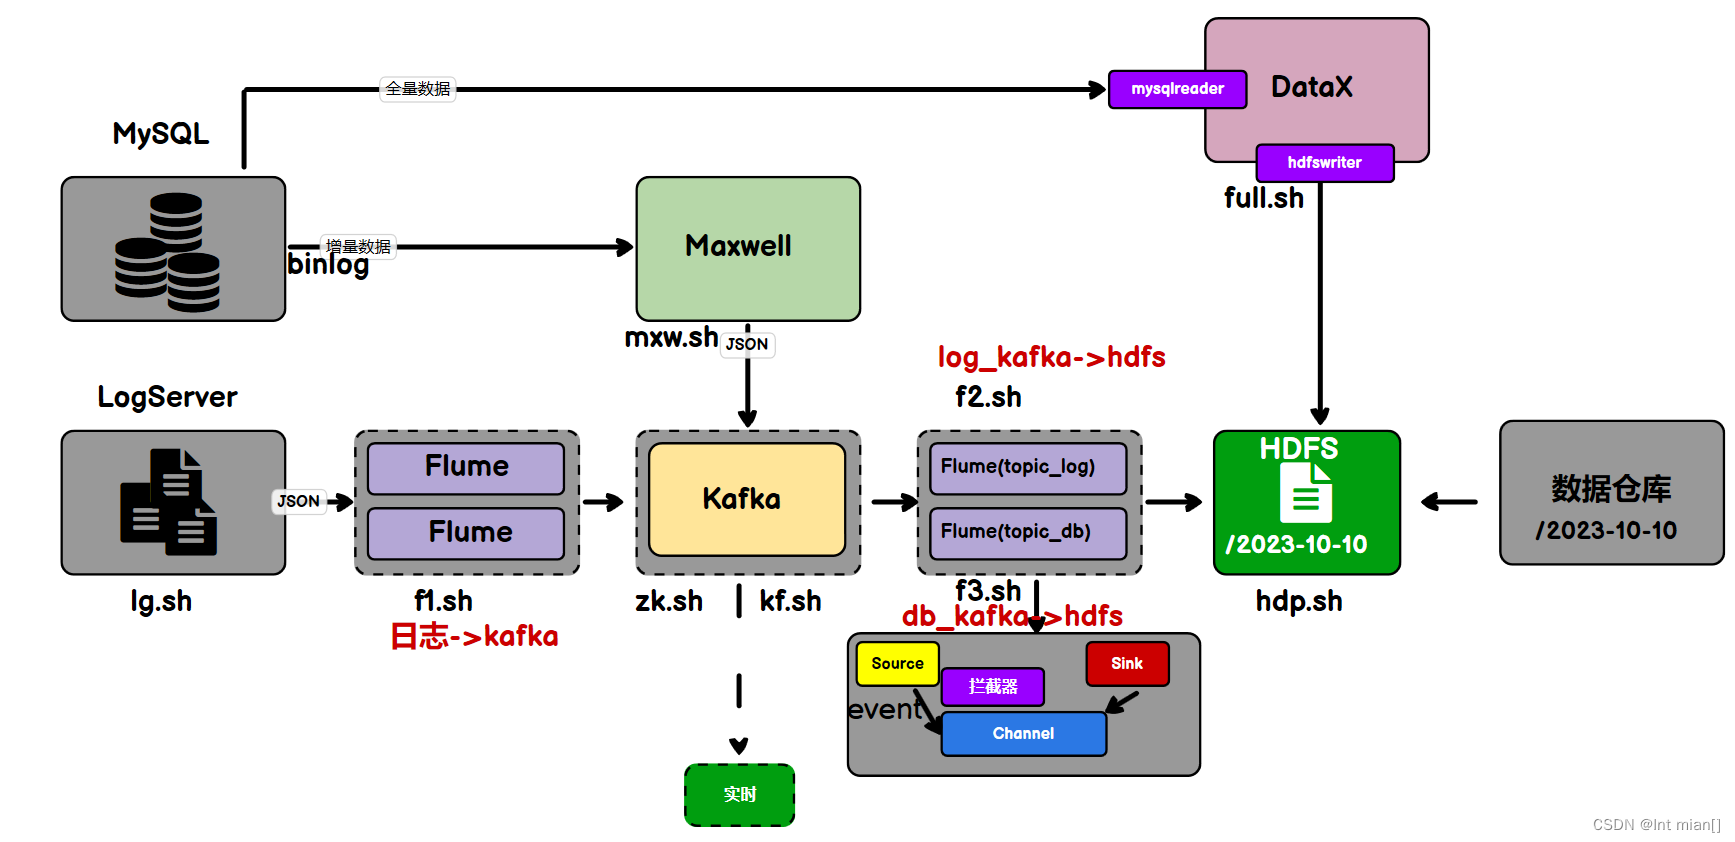
fl脚本将log采集到kafka,max将db增量采集到kafka,f2将log同步到dhfs,datax将db全量采集到hdfs,f3将db从kafka采集到hdfs
日志数据采集2Kafka
Logs(模拟生成)➡️Flume➡️Kafka⬇️➡️HDFS
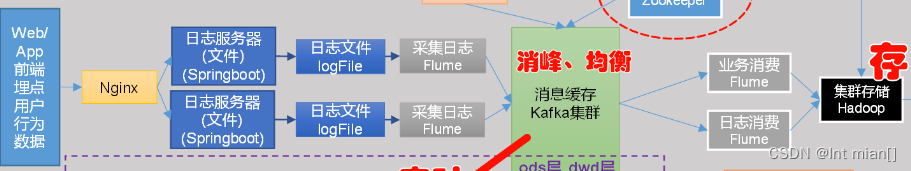
全套配置:
数仓项目6.0配置大全(hadoop/Flume/zk/kafka/mysql配置)-CSDN博客
业务数据sql采集2Kafka
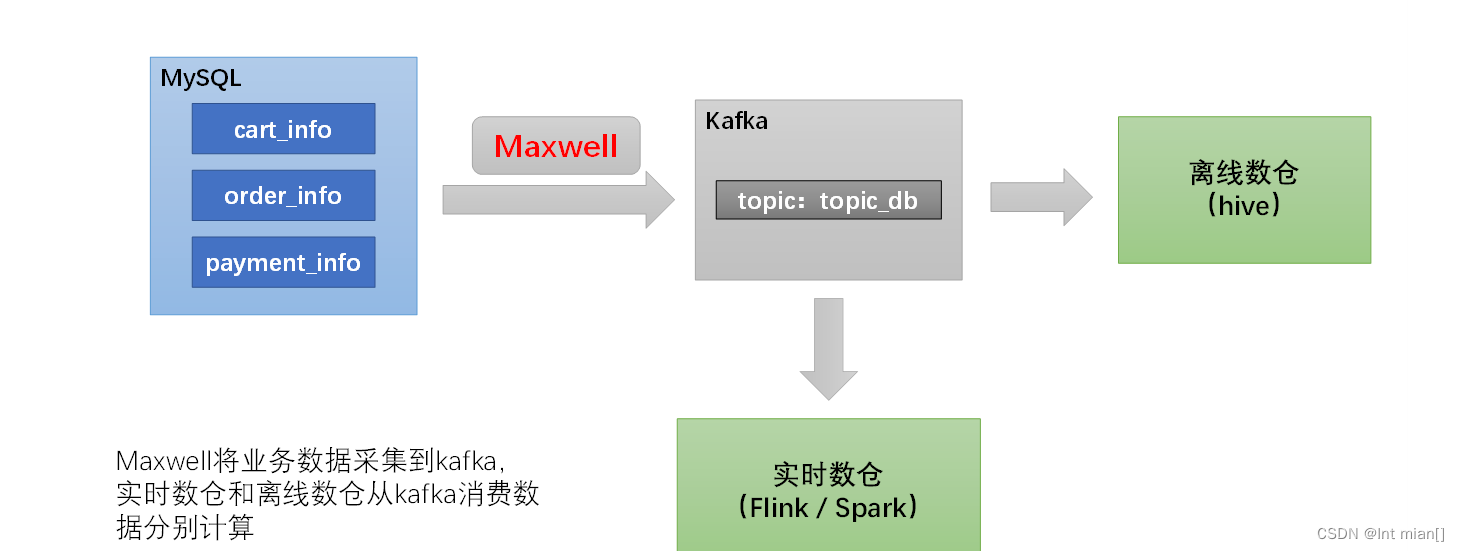
安装maxwell增量采集工具
Maxwell 是由美国Zendesk公司开源,用Java编写的MySQL变更数据抓取软件。它会实时监控MySQL数据库的数据变更操作(包括insert、update、delete),并将变更数据以 JSON 格式发送给 Kafka、Kinesi等流数据处理平台
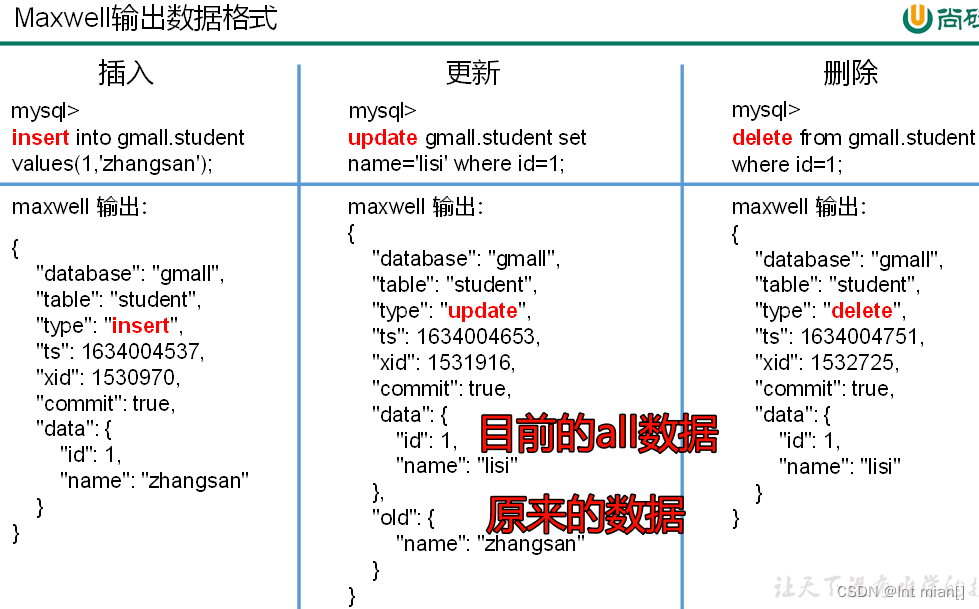
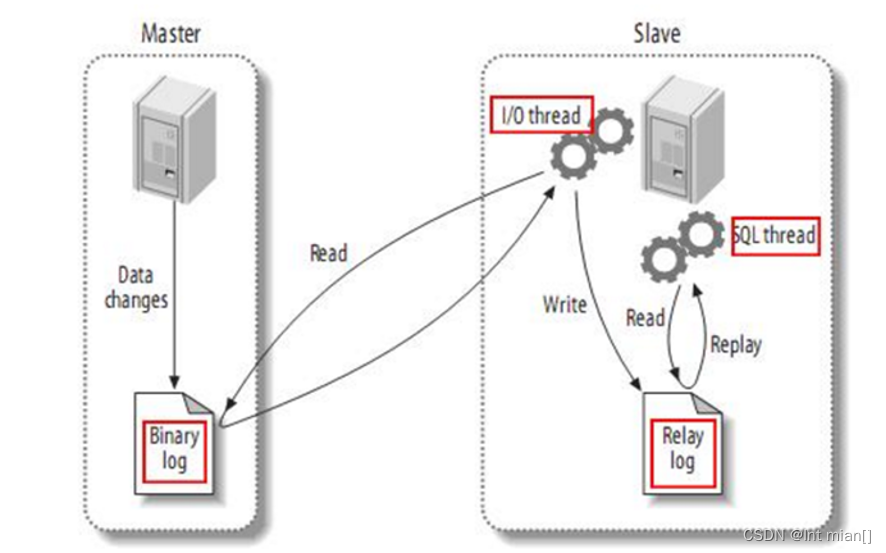
Maxwell的工作原理是实时读取MySQL数据库的二进制日志(Binlog),从中获取变更数据,再将变更数据以JSON格式发送至Kafka等流处理平台。
二进制日志(Binlog)是MySQL服务端非常重要的一种日志,它会保存MySQL数据库的所有数据变更记录。Binlog的主要作用包括主从复制和数据恢复。
Maxwell的工作原理和主从复制密切相关。
MySQL的主从复制,就是用来建立一个和主数据库完全一样的数据库环境,这个数据库称为从数据库。做数据库的热备、读写分离,在读多写少场景下,可以提高数据库工作效率。
maxwell就是将自己伪装成slave,并遵循MySQL主从复制的协议,从master同步数据。
https://github.com/zendesk/maxwell/releases/download/v1.29.2/maxwell-1.29.2.tar.gz
将安装包解压至/opt/module
MySQL服务器的Binlog默认是未开启的,如需进行同步,需要先进行开启
vim /etc/my.cnf
#数据库id
server-id = 1
#启动binlog,该参数的值会作为binlog的文件名
log-bin=mysql-bin
#binlog类型,maxwell要求为row类型
binlog_format=row
#启用binlog的数据库,需根据实际情况作出修改
binlog-do-db=gmall
重启MySQL服务systemctl restart mysqld
Maxwell需要在MySQL中存储其运行过程中的所需的一些数据,包括binlog同步的断点位置(Maxwell支持断点续传)等等,故需要在MySQL为Maxwell创建数据库及用户。
CREATE DATABASE maxwell;CREATE USER 'maxwell'@'%' IDENTIFIED BY 'maxwell';
GRANT ALL ON maxwell.* TO 'maxwell'@'%';
GRANT SELECT, REPLICATION CLIENT, REPLICATION SLAVE ON *.* TO 'maxwell'@'%';修改Maxwell配置文件名称
cd /opt/module/maxwell
cp config.properties.example config.properties
vim config.properties
#Maxwell数据发送目的地,可选配置有stdout|file|kafka|kinesis|pubsub|sqs|rabbitmq|redis
producer=kafka
# 目标Kafka集群地址
kafka.bootstrap.servers=hadoop102:9092,hadoop103:9092,hadoop104:9092
#目标Kafka topic,可静态配置,例如:maxwell,也可动态配置,例如:%{database}_%{table}
kafka_topic=topic_db
# MySQL相关配置
host=hadoop102
user=maxwell
password=maxwell
jdbc_options=useSSL=false&serverTimezone=Asia/Shanghai&allowPublicKeyRetrieval=true
# 过滤gmall中的z_log表数据,该表是日志数据的备份,无须采集
filter=exclude:gmall.z_log
# 指定数据按照主键分组进入Kafka不同分区,避免数据倾斜
producer_partition_by=primary_key
若Maxwell发送数据的目的地为Kafka集群,则需要先确保zk、Kafka集群为启动状态。
启动脚本
#!/bin/bash
MAXWELL_HOME=/opt/module/maxwell
status_maxwell(){result=`ps -ef | grep com.zendesk.maxwell.Maxwell | grep -v grep | wc -l`return $result
}start_maxwell(){status_maxwellif [[ $? -lt 1 ]]; thenecho "启动Maxwell"$MAXWELL_HOME/bin/maxwell --config $MAXWELL_HOME/config.properties --daemonelseecho "Maxwell正在运行"fi
}stop_maxwell(){status_maxwellif [[ $? -gt 0 ]]; thenecho "停止Maxwell"ps -ef | grep com.zendesk.maxwell.Maxwell | grep -v grep | awk '{print $2}' | xargs kill -9elseecho "Maxwell未在运行"fi
}case $1 instart )start_maxwell;;stop )stop_maxwell;;restart )stop_maxwellstart_maxwell;;
esac
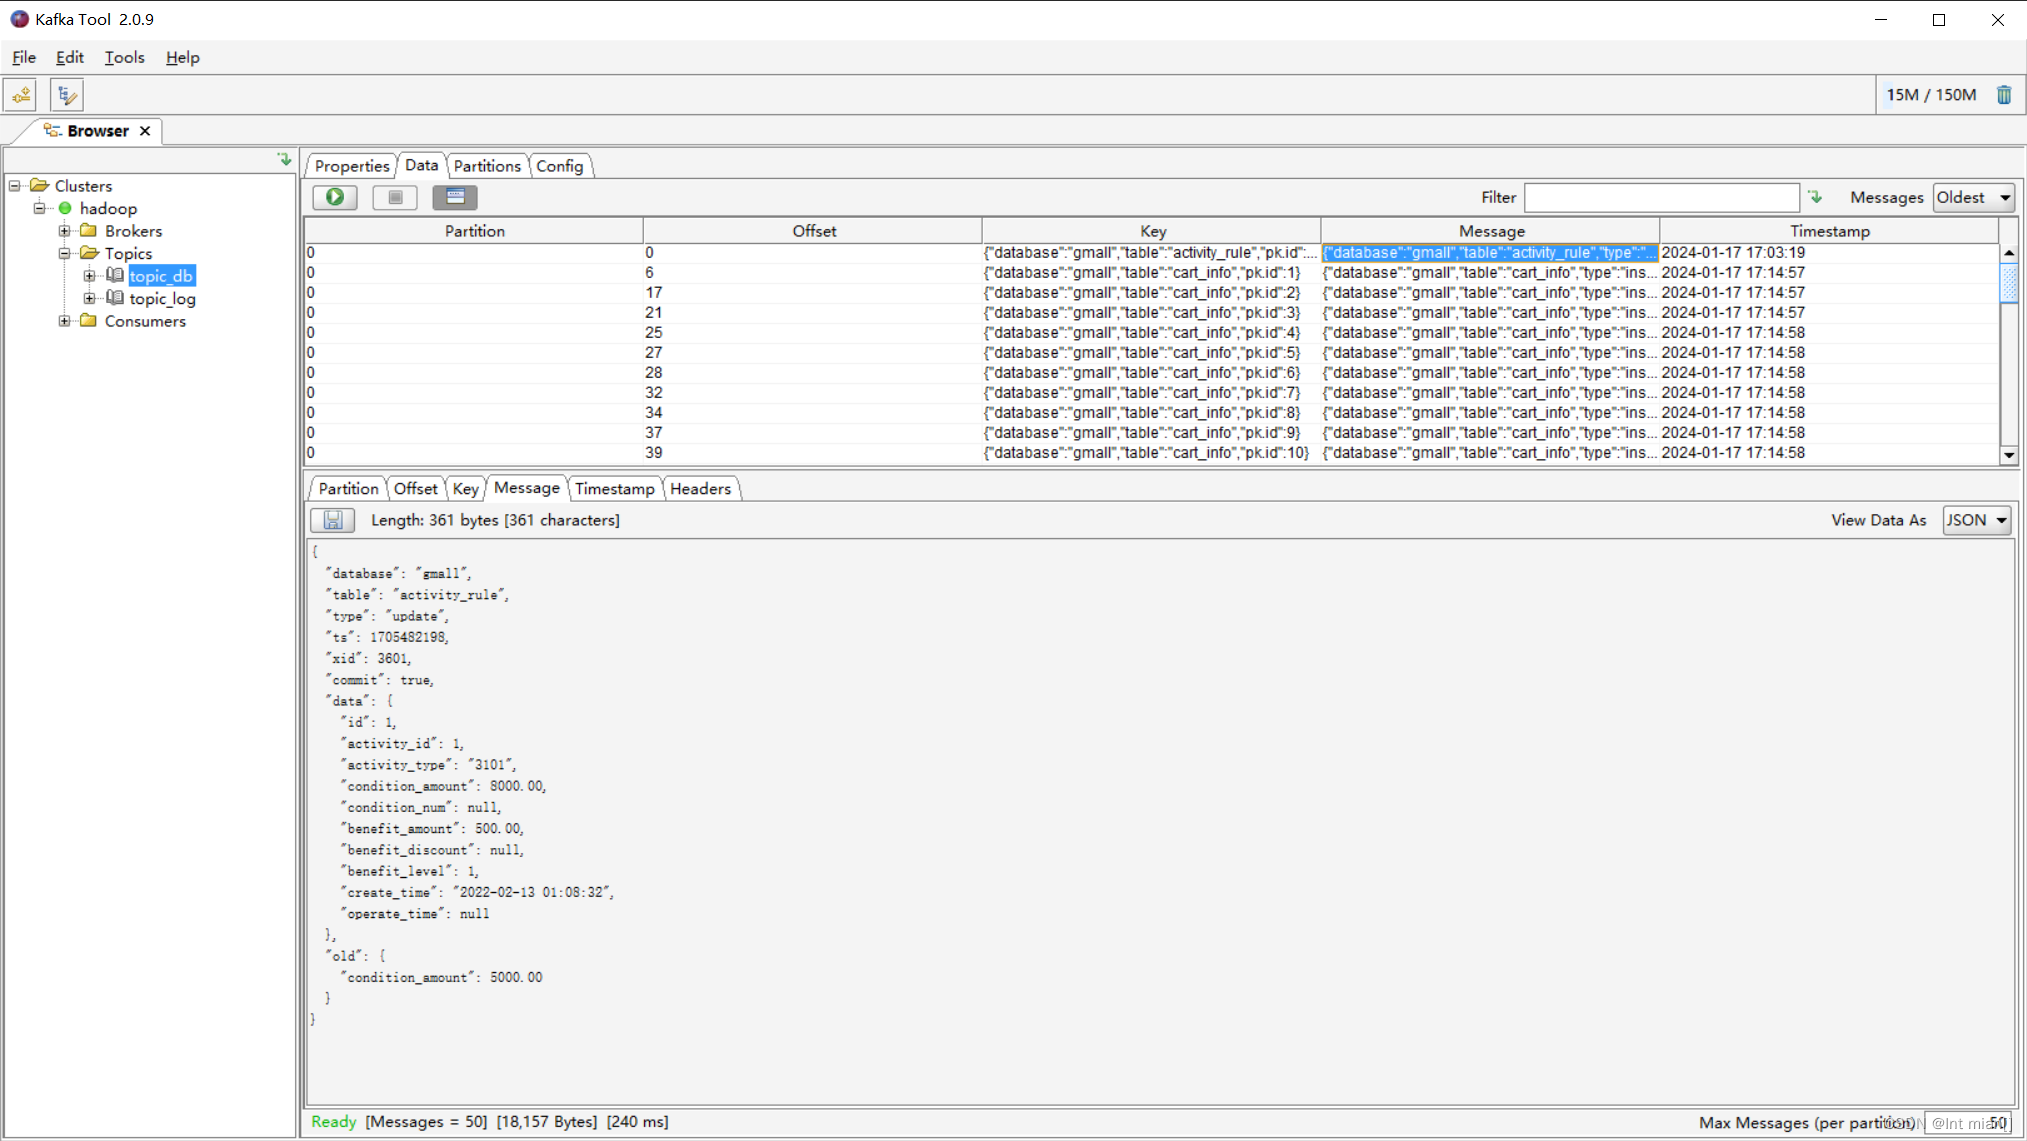
启动后,进行数据库的修改,手动改一个数、运行lg使用jar包向数据库中添加内容,都会引起maxwell写入kafka
历史数据全量同步
可能需要使用到MySQL数据库中从历史至今的一个完整的数据集。这就需要我们在进行增量同步之前,先进行一次历史数据的全量同步。这样就能保证得到一个完整的数据集。
Maxwell提供了bootstrap功能来进行历史数据的全量同步,命令如下:
/opt/module/maxwell/bin/maxwell-bootstrap
--database gmall
--table activity_info
--config /opt/module/maxwell/config.properties
采用bootstrap方式同步的输出数据格式如下,注意 "type": "bootstrap-start","type": "bootstrap-complete",
{"database": "gmall","table": "activity_info","type": "bootstrap-start","ts": 1705484093,"data": {}
}
{"database": "gmall","table": "activity_info","type": "bootstrap-insert","ts": 1705484093,"data": {"id": 4,"activity_name": "TCL全场9折","activity_type": "3103","activity_desc": "TCL全场9折","start_time": "2022-01-13 01:01:54","end_time": "2023-06-19 00:00:00","create_time": "2022-05-27 00:00:00","operate_time": null}
}
······
{"database": "gmall","table": "activity_info","type": "bootstrap-complete","ts": 1705484093,"data": {}
}
日志数据同步2HDFS
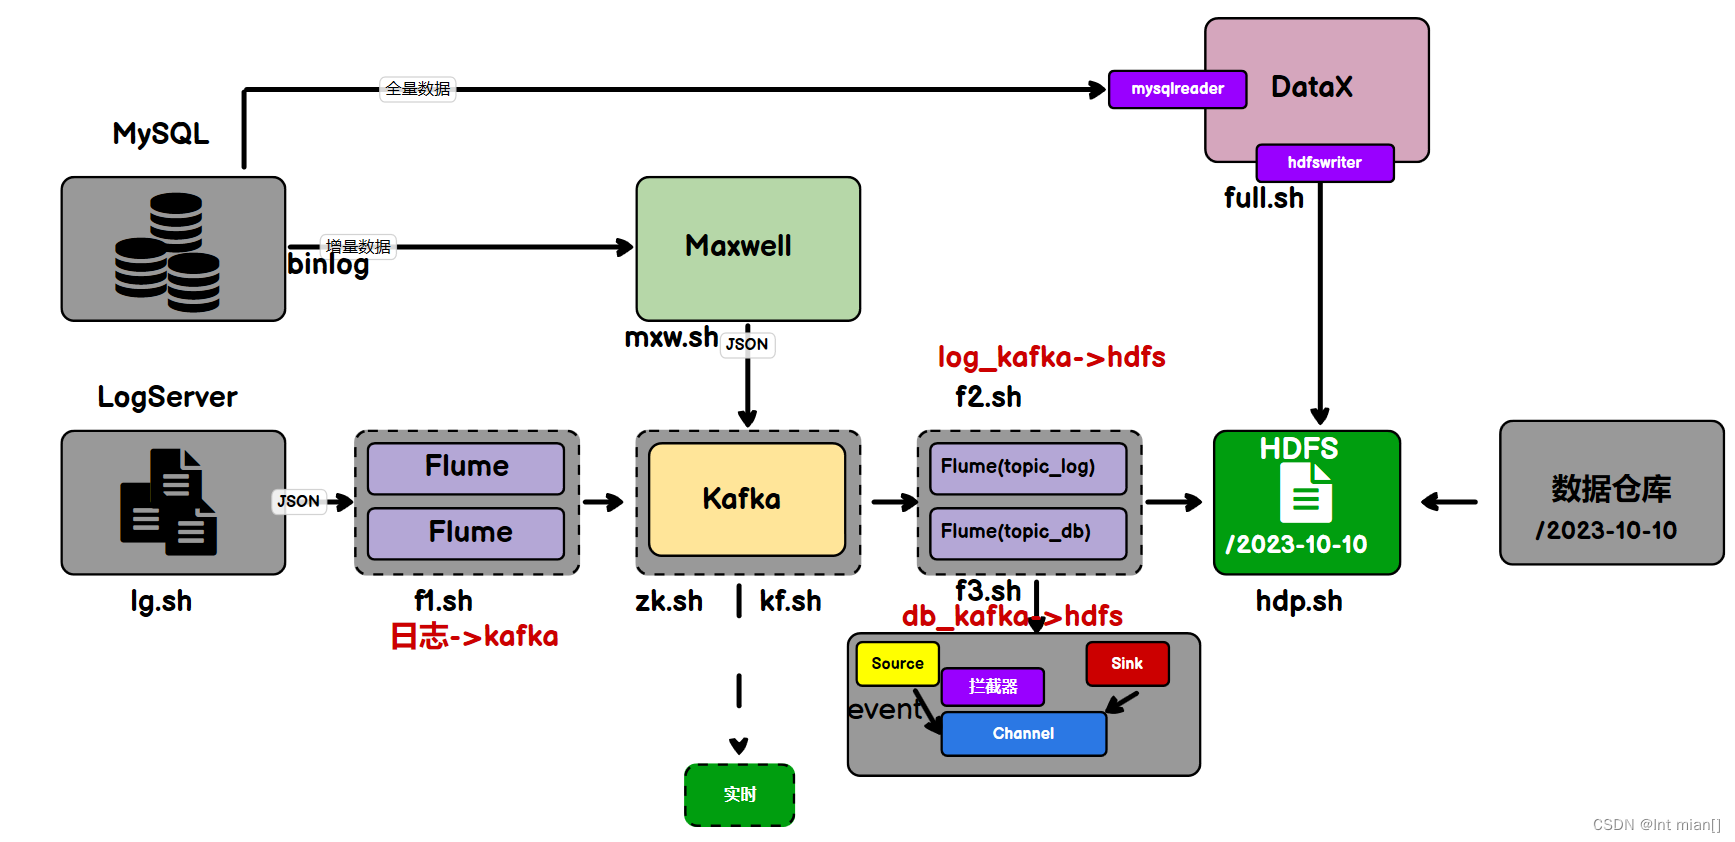
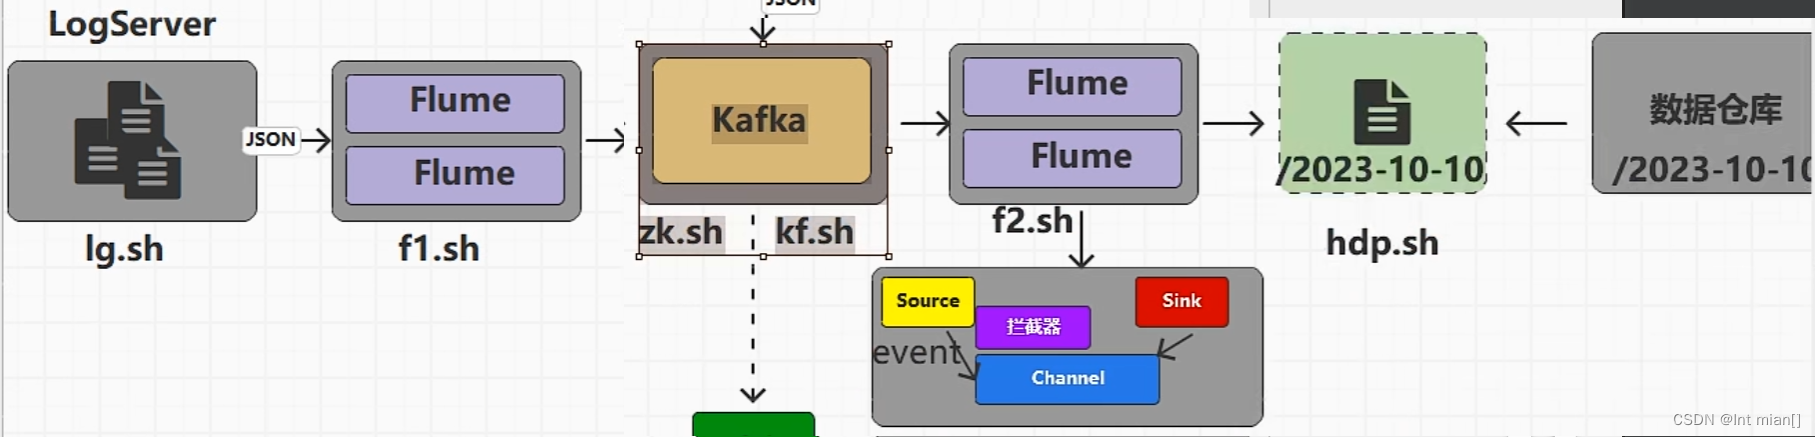
实时数仓由Flink源源不断从Kafka当中读数据计算,所以不需要手动同步数据到实时数仓。
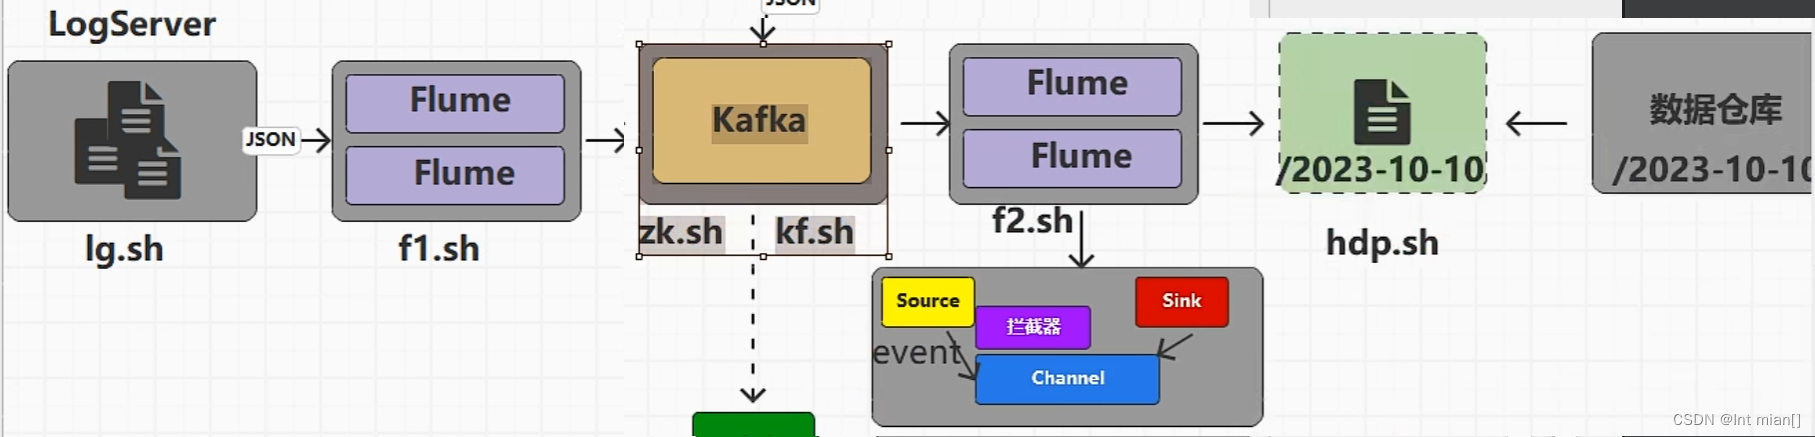
用户行为数据由Flume从Kafka直接同步到HDFS,由于离线数仓采用Hive的分区表按天统计,所以目标路径要包含一层日期。具体数据流向如下图所示。
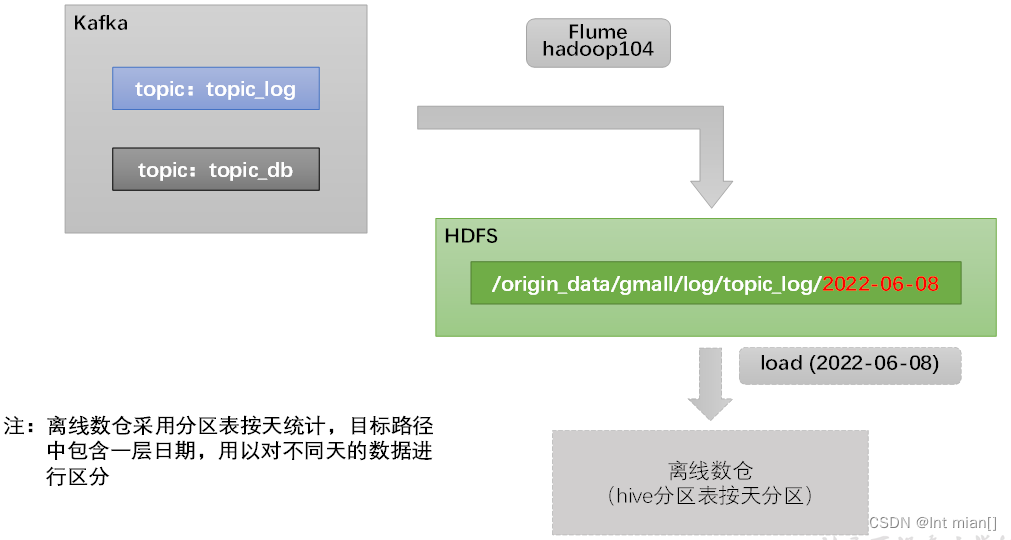
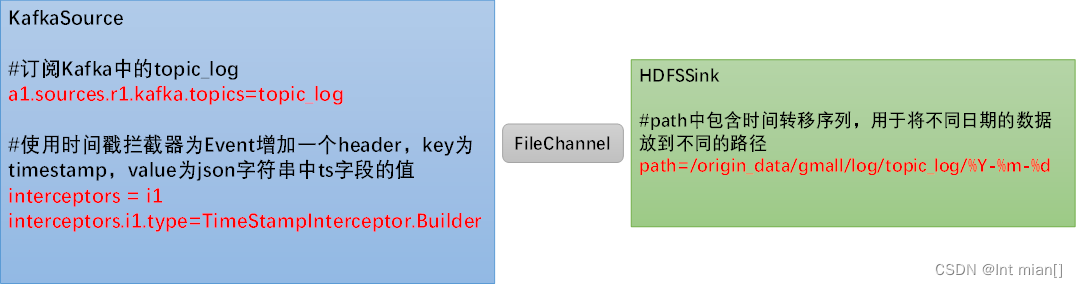
按照规划,该Flume需将Kafka中topic_log的数据发往HDFS。并且对每天产生的用户行为日志进行区分,将不同天的数据发往HDFS不同天的路径。
此处选择KafkaSource、FileChannel、HDFSSink。
#定义组件
a1.sources=r1
a1.channels=c1
a1.sinks=k1#配置source1
a1.sources.r1.type = org.apache.flume.source.kafka.KafkaSource
a1.sources.r1.batchSize = 5000
a1.sources.r1.batchDurationMillis = 2000
a1.sources.r1.kafka.bootstrap.servers = hadoop102:9092,hadoop103:9092,hadoop104:9092
a1.sources.r1.kafka.topics=topic_log
a1.sources.r1.interceptors = i1
a1.sources.r1.interceptors.i1.type = com.atguigu.gmall.flume.interceptor.TimestampInterceptor$Builder#配置channel
a1.channels.c1.type = file
a1.channels.c1.checkpointDir = /opt/module/flume/checkpoint/behavior1
a1.channels.c1.dataDirs = /opt/module/flume/data/behavior1
a1.channels.c1.maxFileSize = 2146435071
a1.channels.c1.capacity = 1000000
a1.channels.c1.keep-alive = 6#配置sink
a1.sinks.k1.type = hdfs
a1.sinks.k1.hdfs.path = /origin_data/gmall/log/topic_log/%Y-%m-%d
a1.sinks.k1.hdfs.filePrefix = log
a1.sinks.k1.hdfs.round = falsea1.sinks.k1.hdfs.rollInterval = 10
a1.sinks.k1.hdfs.rollSize = 134217728
a1.sinks.k1.hdfs.rollCount = 0#控制输出文件类型
a1.sinks.k1.hdfs.fileType = CompressedStream
a1.sinks.k1.hdfs.codeC = gzip#组装
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
零点漂移问题
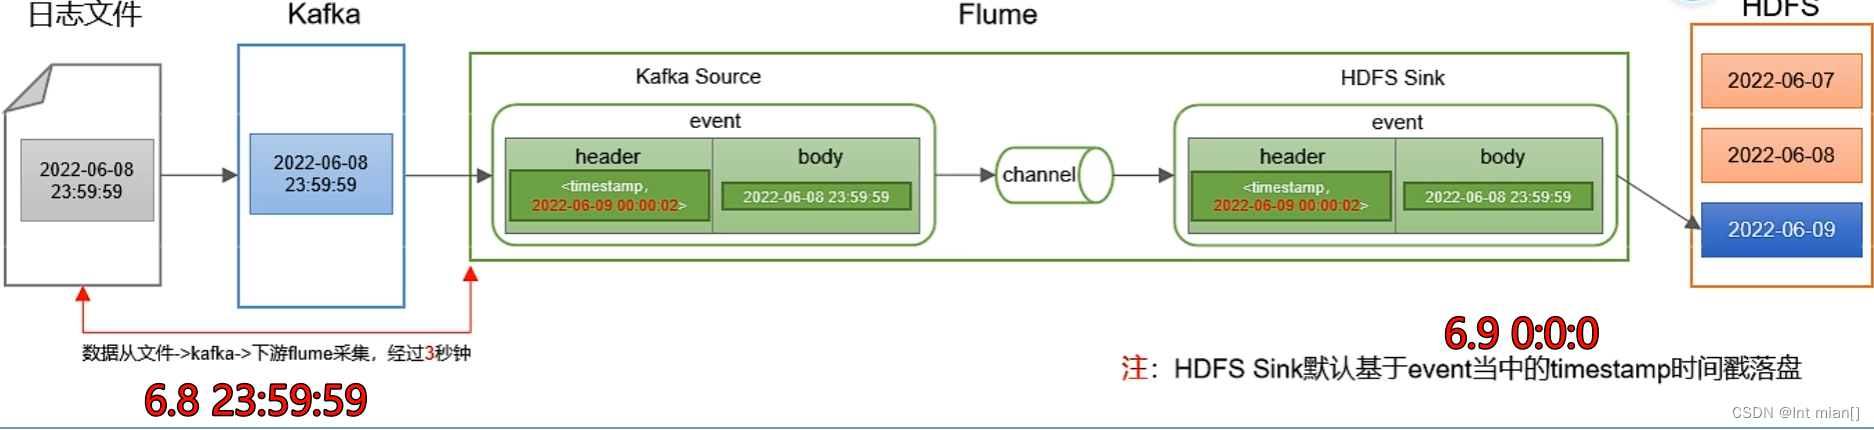
这里就是Flume配置job文件中,在源处加自定义拦截器 的 原因
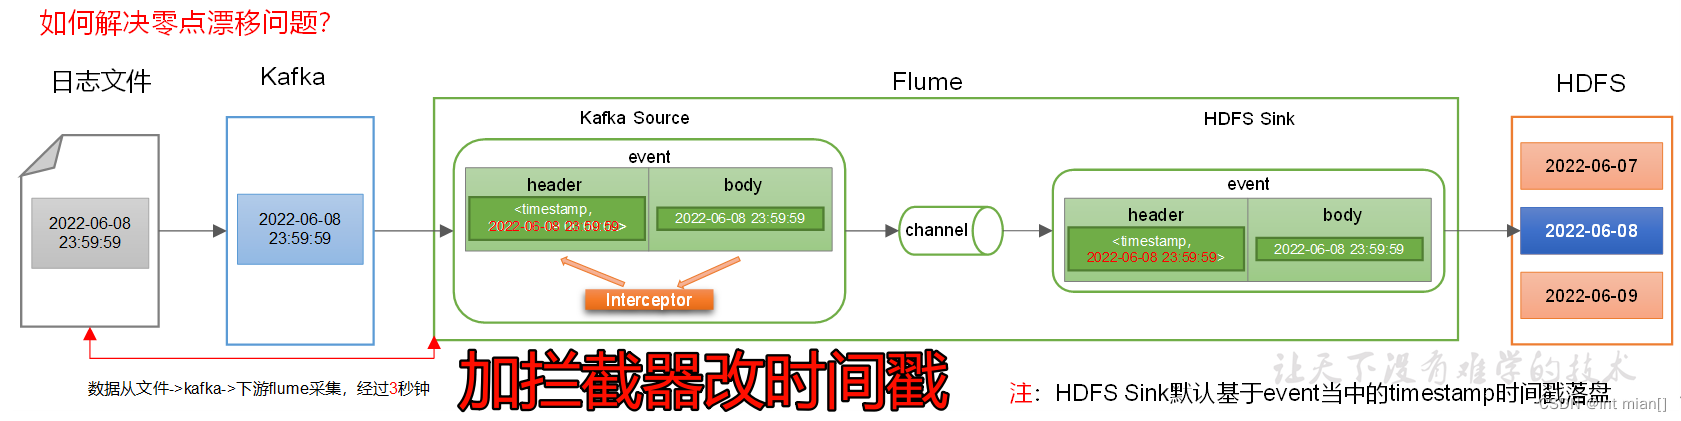
拦截器jar包
生成jar包,放到flume的lib下,jar包的java文件存放路径要和job中那个拦截器路径一致,然后沟通Kafka-flume-hdfs
package com.atguigu.gmall.flume.interceptor;import org.apache.flume.Event;
import org.apache.flume.interceptor.Interceptor;
import com.alibaba.fastjson.JSONObject;
import org.apache.flume.Context;
import java.nio.charset.StandardCharsets;
import java.util.Iterator;import java.util.List;
import java.util.Map;public class TimestampInterceptor implements Interceptor {@Overridepublic void initialize() {}@Overridepublic Event intercept(Event event) {//1、获取header和body的数据Map<String, String> headers = event.getHeaders();String log = new String(event.getBody(), StandardCharsets.UTF_8);try {//2、将body的数据类型转成jsonObject类型(方便获取数据)JSONObject jsonObject = JSONObject.parseObject(log);//3、header中timestamp时间字段替换成日志生成的时间戳(解决数据漂移问题)String ts = jsonObject.getString("ts");headers.put("timestamp", ts);return event;} catch (Exception e) {e.printStackTrace();return null;}}@Overridepublic List<Event> intercept(List<Event> list) {Iterator<Event> iterator = list.iterator();while (iterator.hasNext()) {Event event = iterator.next();if (intercept(event) == null) {iterator.remove();}}return list;}@Overridepublic void close() {}public static class Builder implements Interceptor.Builder {@Overridepublic Interceptor build() {return new TimestampInterceptor();}public void configure(Context context) {}}}
<dependencies><dependency><groupId>org.apache.flume</groupId><artifactId>flume-ng-core</artifactId><version>1.10.1</version><scope>provided</scope></dependency><dependency><groupId>com.alibaba</groupId><artifactId>fastjson</artifactId><version>1.2.62</version></dependency></dependencies><build><plugins><plugin><artifactId>maven-compiler-plugin</artifactId><version>2.3.2</version><configuration><source>1.8</source><target>1.8</target></configuration></plugin><plugin><artifactId>maven-assembly-plugin</artifactId><configuration><descriptorRefs><descriptorRef>jar-with-dependencies</descriptorRef></descriptorRefs></configuration><executions><execution><id>make-assembly</id><phase>package</phase><goals><goal>single</goal></goals></execution></executions></plugin></plugins></build>同步!
先把日志/opt/module/applog/log清空,kafka清空
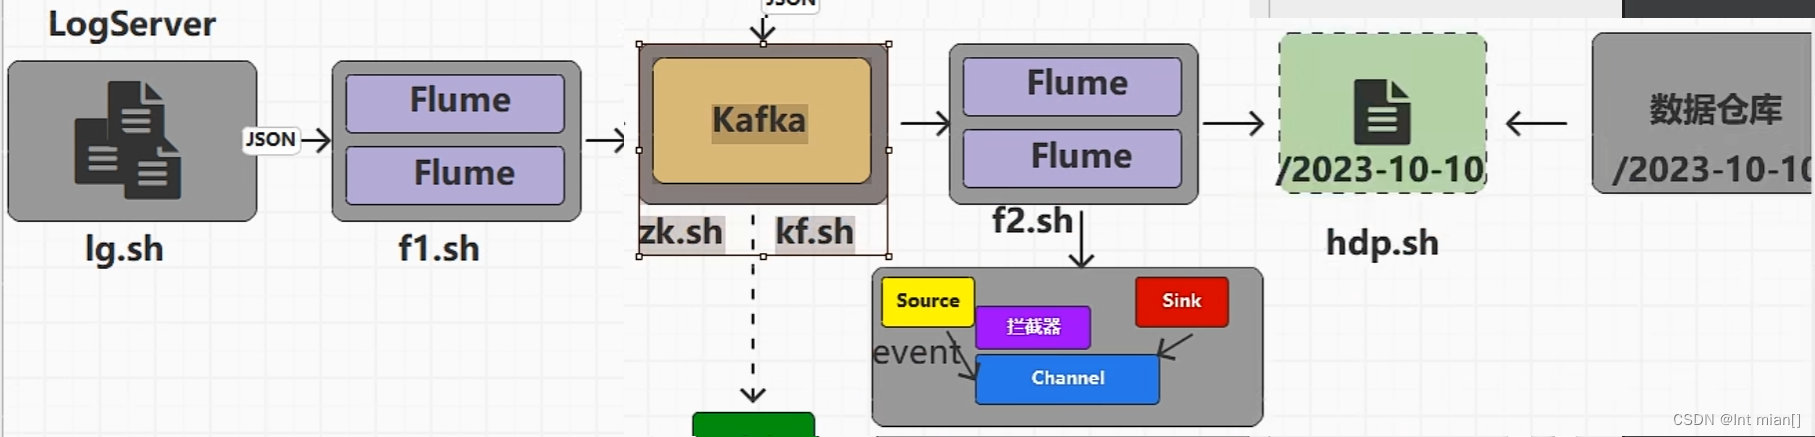
启动zk、kafka、hadoop、f1(日志到kafka)、f2(kafka到hdfs),然后生成模拟日志数据就行了
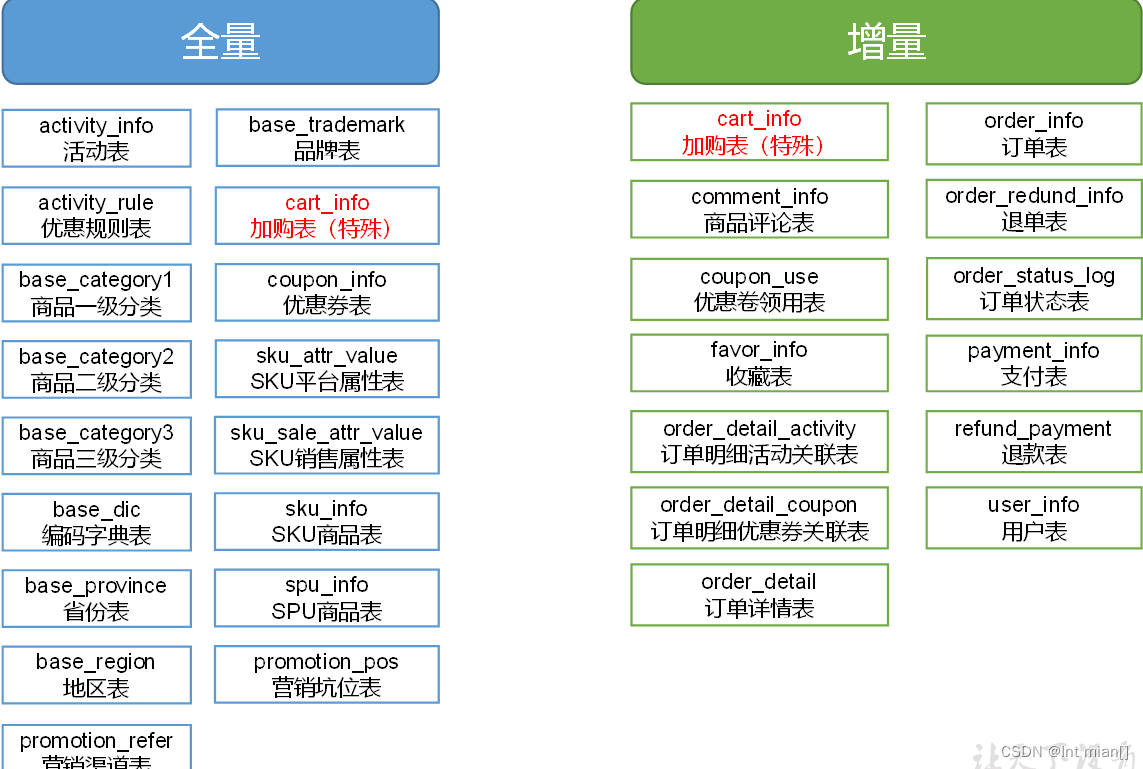
全量还是增量
通常情况,业务表数据量比较大,变动频繁,优先考虑增量,数据量比较小,不怎么变动,优先考虑全量
数据同步工具种类繁多,大致可分为两类,一类是以DataX、Sqoop为代表的基于Select查询的离线、批量同步工具,另一类是以Maxwell、Canal为代表的基于数据库数据变更日志(例如MySQL的binlog,其会实时记录所有的insert、update以及delete操作)的实时流式同步工具。
全量同步采用DataX,增量同步采用Maxwell。
安装DataX
https://github.com/alibaba/DataX?tab=readme-ov-file
DataX 是阿里巴巴开源的一个异构数据源离线同步工具,致力于实现包括关系型数据库(MySQL、Oracle等)、HDFS、Hive、ODPS、HBase、FTP等各种异构数据源之间稳定高效的数据同步功能。
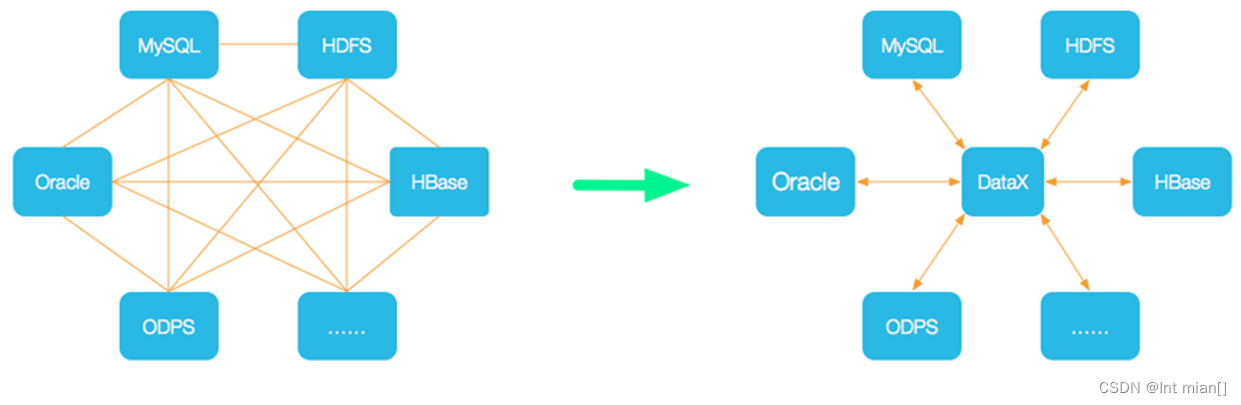
DataX的使用,用户只需根据数据的数据源和目的地选择相应的Reader和Writer,并将Reader和Writer的信息配置在一个json文件中,然后执行如下命令提交数据同步任务即可。
可以使用如下命名查看DataX配置文件模板
python bin/datax.py -r mysqlreader -w hdfswriterTableMode
同步gmall数据库中base_province表数据到HDFS的/base_province目录
要实现该功能,需选用MySQLReader和HDFSWriter,MySQLReader具有两种模式分别是TableMode和QuerySQLMode,前者使用table,column,where等属性声明需要同步的数据;后者使用一条SQL查询语句声明需要同步的数据。
vim /opt/module/datax/job/base_province.json
{"job": {"content": [{"reader": {"name": "mysqlreader","parameter": {"column": ["id","name","region_id","area_code","iso_code","iso_3166_2","create_time","operate_time"],"where": "id>=3","connection": [{"jdbcUrl": ["jdbc:mysql://hadoop102:3306/gmall?useUnicode=true&allowPublicKeyRetrieval=true&characterEncoding=utf-8"],"table": ["base_province"]}],"password": "000000","splitPk": "","username": "root"}},"writer": {"name": "hdfswriter","parameter": {"column": [{"name": "id","type": "bigint"},{"name": "name","type": "string"},{"name": "region_id","type": "string"},{"name": "area_code","type": "string"},{"name": "iso_code","type": "string"},{"name": "iso_3166_2","type": "string"},{"name": "create_time","type": "string"},{"name": "operate_time","type": "string"}],"compress": "gzip","defaultFS": "hdfs://hadoop102:8020","fieldDelimiter": "\t","fileName": "base_province","fileType": "text","path": "/base_province","writeMode": "append"}}}],"setting": {"speed": {"channel": 1}}}
}
HFDS Writer并未提供nullFormat参数:也就是用户并不能自定义null值写到HFDS文件中的存储格式。默认情况下,HFDS Writer会将null值存储为空字符串(''),而Hive默认的null值存储格式为\N。所以后期将DataX同步的文件导入Hive表就会出现问题。
创建hdfs中的目录
hadoop fs -mkdir /base_province
运行
python bin/datax.py job/base_province.json
查看gz
hadoop fs -cat /base_province/* | zca
QuerySQLMode
{"job": {"content": [{"reader": {"name": "mysqlreader","parameter": {"connection": [{"jdbcUrl": ["jdbc:mysql://hadoop102:3306/gmall?useUnicode=true&allowPublicKeyRetrieval=true&characterEncoding=utf-8"],"querySql": ["select id,name,region_id,area_code,iso_code,iso_3166_2,create_time,operate_time from base_province where id>=3"]}],"password": "000000","username": "root"}},"writer": {"name": "hdfswriter","parameter": {"column": [{"name": "id","type": "bigint"},{"name": "name","type": "string"},{"name": "region_id","type": "string"},{"name": "area_code","type": "string"},{"name": "iso_code","type": "string"},{"name": "iso_3166_2","type": "string"},{"name": "create_time","type": "string"},{"name": "operate_time","type": "string"}],"compress": "gzip","defaultFS": "hdfs://hadoop102:8020","fieldDelimiter": "\t","fileName": "base_province","fileType": "text","path": "/base_province","writeMode": "append"}}}],"setting": {"speed": {"channel": 1}}}
}
传参
DataX配置文件中HDFS Writer的path参数的值应该是动态的。为实现这一效果,就需要使用DataX传参的功能。
DataX传参的用法如下,在JSON配置文件中使用${param}引用参数,在提交任务时使用-p"-Dparam=value"传入参数值,具体示例如下。
"path": "/base_province/${dt}",
创建文件夹
hadoop fs -mkdir /base_province/2022-06-08
运行
python bin/datax.py -p"-Ddt=2022-06-08" job/base_province.json
sql2hdfs全量同步
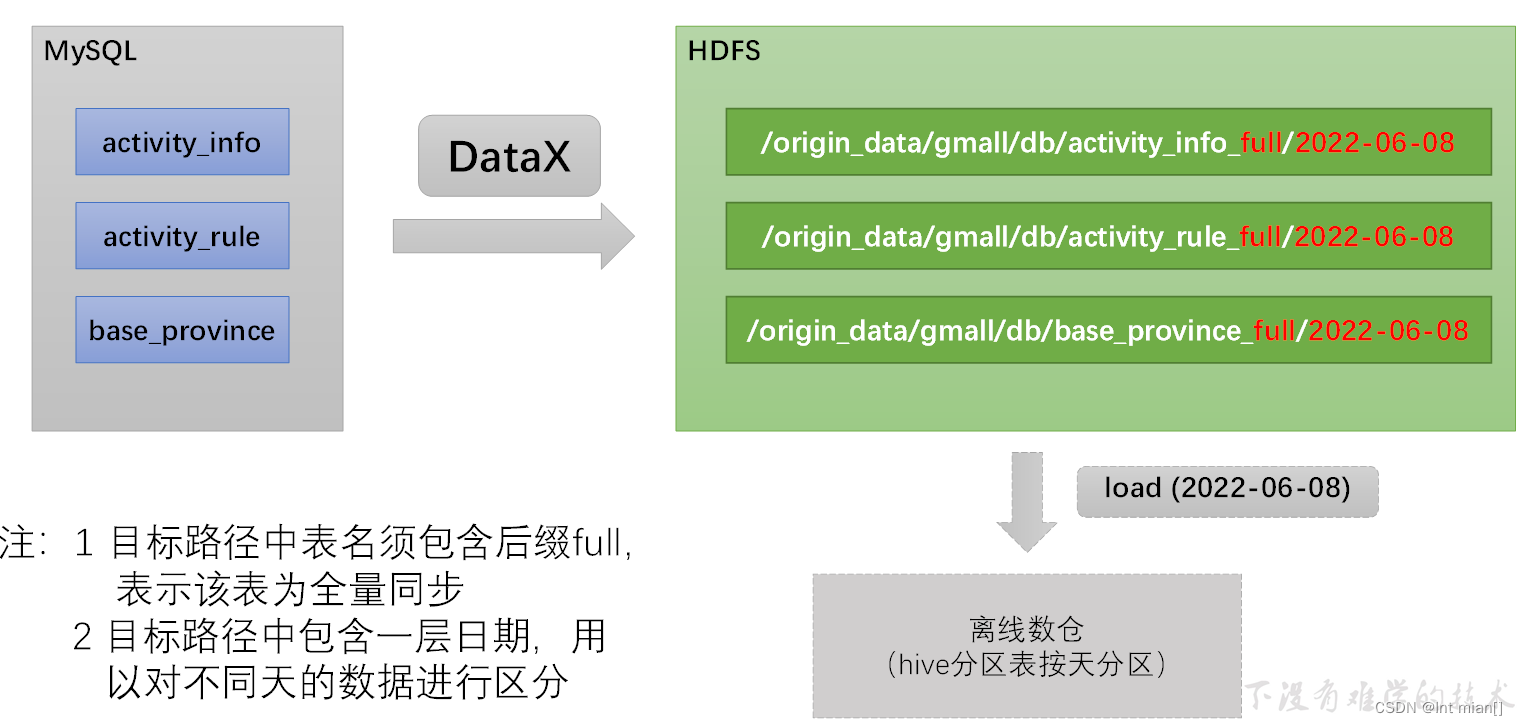
需要为每张全量表编写一个DataX的json配置文件
写了一个脚本,流程不难但繁琐,建议回去看尚硅谷的资料
大致流程梳理:
目的是把数据库全量同步到hdfs,那么准备好datax配置文件json。
从资料里拉了个配置文件json生成器,一下就生成了所有要导的表的json。
然后写了一个脚本,执行mysql_to_hdfs_full.sh all 2022-06-08
慢慢等。。。。。。。。。。17张表导入
业务数据sql2hdfs增量同步
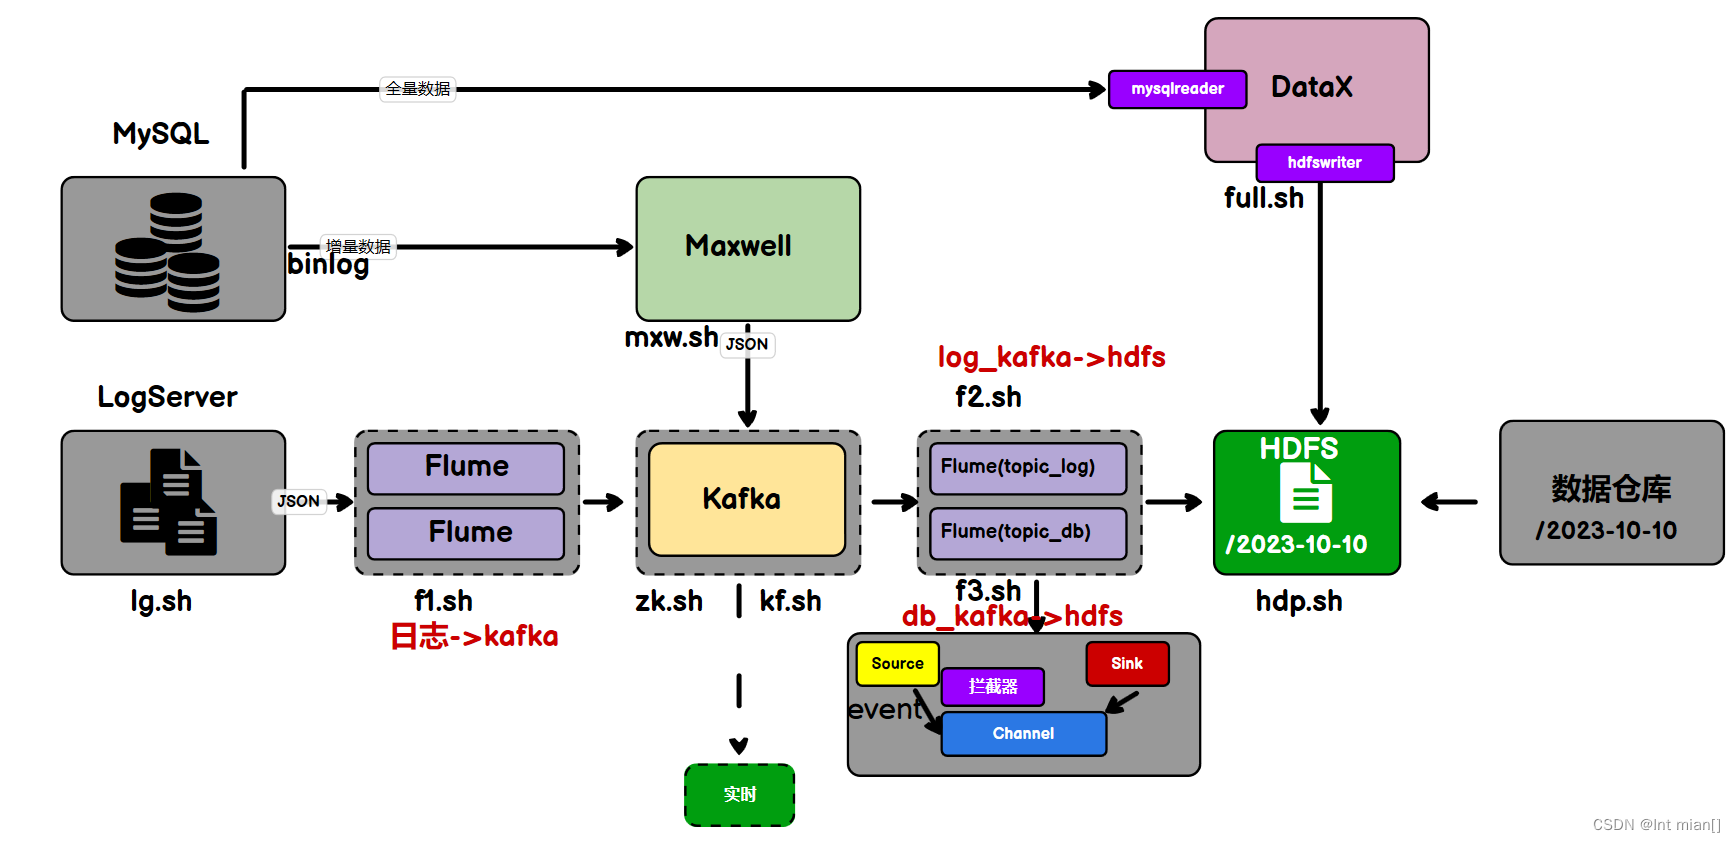
通过maxwell和flume

Flume需要将Kafka中topic_db主题的数据传输到HDFS,故其需选用KafkaSource以及HDFSSink,Channel选用FileChannel。
需要注意的是, HDFSSink需要将不同MySQL业务表的数据写到不同的路径,并且路径中应当包含一层日期,用于区分每天的数据。关键配置如下:
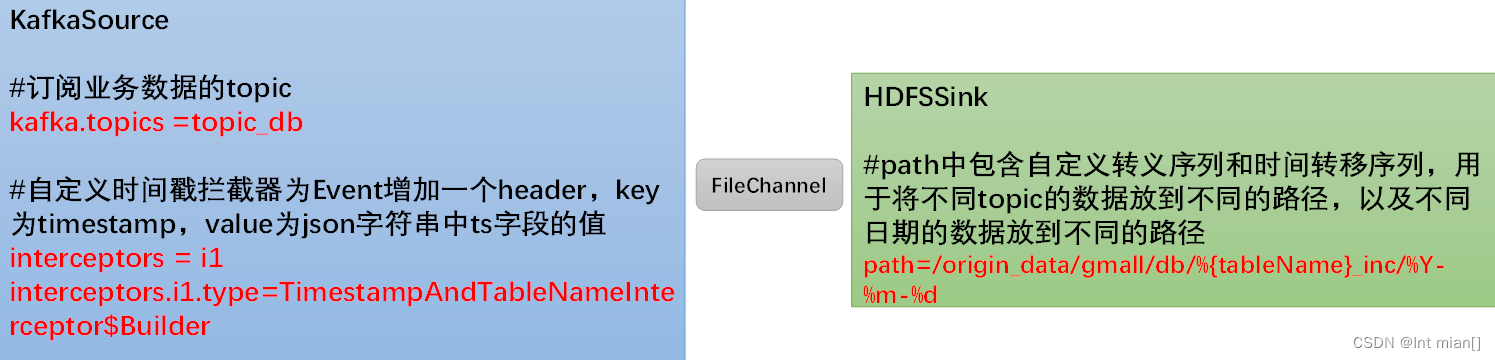
vim job/kafka_to_hdfs_db.conf
a1.sources = r1
a1.channels = c1
a1.sinks = k1a1.sources.r1.type = org.apache.flume.source.kafka.KafkaSource
a1.sources.r1.batchSize = 5000
a1.sources.r1.batchDurationMillis = 2000
a1.sources.r1.kafka.bootstrap.servers = hadoop102:9092,hadoop103:9092
a1.sources.r1.kafka.topics = topic_db
a1.sources.r1.kafka.consumer.group.id = flume
a1.sources.r1.setTopicHeader = true
a1.sources.r1.topicHeader = topic
a1.sources.r1.interceptors = i1
a1.sources.r1.interceptors.i1.type = com.atguigu.gmall.flume.interceptor.TimestampAndTableNameInterceptor$Buildera1.channels.c1.type = file
a1.channels.c1.checkpointDir = /opt/module/flume/checkpoint/behavior2
a1.channels.c1.dataDirs = /opt/module/flume/data/behavior2/
a1.channels.c1.maxFileSize = 2146435071
a1.channels.c1.capacity = 1000000
a1.channels.c1.keep-alive = 6
## sink1
a1.sinks.k1.type = hdfs
a1.sinks.k1.hdfs.path = /origin_data/gmall/db/%{tableName}_inc/%Y-%m-%d
a1.sinks.k1.hdfs.filePrefix = db
a1.sinks.k1.hdfs.round = falsea1.sinks.k1.hdfs.rollInterval = 10
a1.sinks.k1.hdfs.rollSize = 134217728
a1.sinks.k1.hdfs.rollCount = 0a1.sinks.k1.hdfs.fileType = CompressedStream
a1.sinks.k1.hdfs.codeC = gzip## 拼装
a1.sources.r1.channels = c1
a1.sinks.k1.channel= c1
编写Flume拦截器
在com.atguigu.gmall.flume.interceptor包下创建TimestampAndTableNameInterceptor类
package com.atguigu.gmall.flume.interceptor;import com.alibaba.fastjson.JSONObject;
import org.apache.flume.Context;
import org.apache.flume.Event;
import org.apache.flume.interceptor.Interceptor;import java.nio.charset.StandardCharsets;
import java.util.List;
import java.util.Map;public class TimestampAndTableNameInterceptor implements Interceptor {@Overridepublic void initialize() {}@Overridepublic Event intercept(Event event) {Map<String, String> headers = event.getHeaders();String log = new String(event.getBody(), StandardCharsets.UTF_8);JSONObject jsonObject = JSONObject.parseObject(log);Long ts = jsonObject.getLong("ts");//Maxwell输出的数据中的ts字段时间戳单位为秒,Flume HDFSSink要求单位为毫秒String timeMills = String.valueOf(ts * 1000);String tableName = jsonObject.getString("table");headers.put("timestamp", timeMills);headers.put("tableName", tableName);return event;}@Overridepublic List<Event> intercept(List<Event> events) {for (Event event : events) {intercept(event);}return events;}@Overridepublic void close() {}public static class Builder implements Interceptor.Builder {@Overridepublic Interceptor build() {return new TimestampAndTableNameInterceptor ();}@Overridepublic void configure(Context context) {}}
}
重新打包,放到flume/lib中
为方便使用,此处编写一个Flume的启停脚本。
vim f3
#!/bin/bashcase $1 in
"start")echo " --------启动 hadoop104 业务数据flume-------"ssh hadoop104 "nohup /opt/module/flume/bin/flume-ng agent -n a1 -c /opt/module/flume/conf -f /opt/module/flume/job/kafka_to_hdfs_db.conf >/dev/null 2>&1 &"
;;"stop")echo " --------停止 hadoop104 业务数据flume-------"ssh hadoop104 "ps -ef | grep kafka_to_hdfs_db | grep -v grep |awk '{print \$2}' | xargs -n1 kill"
;;
esac
DataX同步不常变数据,maxwell增量全量同步常变业务数据!!!!
增量表首日全量同步
通常情况下,增量表需要在首日进行一次全量同步,后续每日再进行增量同步,首日全量同步可以使用Maxwell的bootstrap功能,方便起见,下面编写一个增量表首日全量同步脚本。
vim mysql_to_kafka_inc_init.sh
#!/bin/bash# 该脚本的作用是初始化所有的增量表,只需执行一次
MAXWELL_HOME=/opt/module/maxwellimport_data() {$MAXWELL_HOME/bin/maxwell-bootstrap --database gmall --table $1 --config $MAXWELL_HOME/config.properties}
case $1 in
"cart_info")import_data cart_info;;"all")import_data cart_infoimport_data comment_infoimport_data coupon_useimport_data favor_infoimport_data order_detailimport_data order_detail_activityimport_data order_detail_couponimport_data order_infoimport_data order_refund_infoimport_data order_status_logimport_data payment_infoimport_data refund_paymentimport_data user_info;;
esac
现将HDFS上之前同步的增量表数据删除。
hadoop fs -ls /origin_data/gmall/db | grep _inc | awk '{print $8}' | xargs hadoop fs -rm -r -f
mysql_to_kafka_inc_init.sh all
观察HDFS上是否重新出现增量表数据。


)


