本章我们来了解一下二叉树这一概念。
目录
1.树概念及结构
1.1树的概念
1.2 树的特点:
1.3 树的相关概念
1.4 树的表示
1.5 树在实际中的运用(表示文件系统的目录树结构)
2.二叉树概念及结构
2.1概念
2.3 特殊的二叉树:
1. 满二叉树:
2. 完全二叉树:
2.4 二叉树的性质
2.5 二叉树的存储结构
1. 顺序存储
2. 链式存储
3.二叉树的顺序结构及实现
3.1 二叉树的顺序结构
3.2 堆的概念及结构
3.3 堆的实现
3.2.1 堆向下调整算法
3.2.2堆的创建
3.2.3 建堆时间复杂度
3.2.4 堆中元素调整
3.2.5 堆的插入
3.2.6 堆中元素的判断
3.2.7 堆中元素的删除
3.2.8 堆的摧毁
3.2.9 堆的头文件
3.3 堆的应用
3.3.1 堆排序
3.3.2 TOP-K问题
4.二叉树链式结构的实现
4.1 前置说明
4.2二叉树的遍历
4.2.1 前序、中序以及后序遍历
4.2.2 层序遍历
4.3 节点个数以及高度等
4.4 二叉树的创建和销毁
4.5 二叉树头文件
1.树概念及结构
1.1树的概念
树是一种非线性的数据结构,它是由n( n>=0)个有限结点组成一个具有层次关系的集合。 把它叫做树是因为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的。

1.2 树的特点:
(1) 所有树都有一个特殊的结点,称为根结点,它是整个树的起点,其他节点都是从根节点开始向下延伸的。
(2) 每个节点在树中都是唯一的,每个节点都可以通过其在树中的位置被唯一地标识。
(3) 树形结构的节点之间呈现出层级关系,每个节点可以有多个子节点,但只能有一个父节点,除了根节点没有父节点。
(4)在数据结构树中,每个节点都不能构成环,即不存在一个节点的子孙节点中存在其祖先节点的情况。
(5) 树是递归定义的。
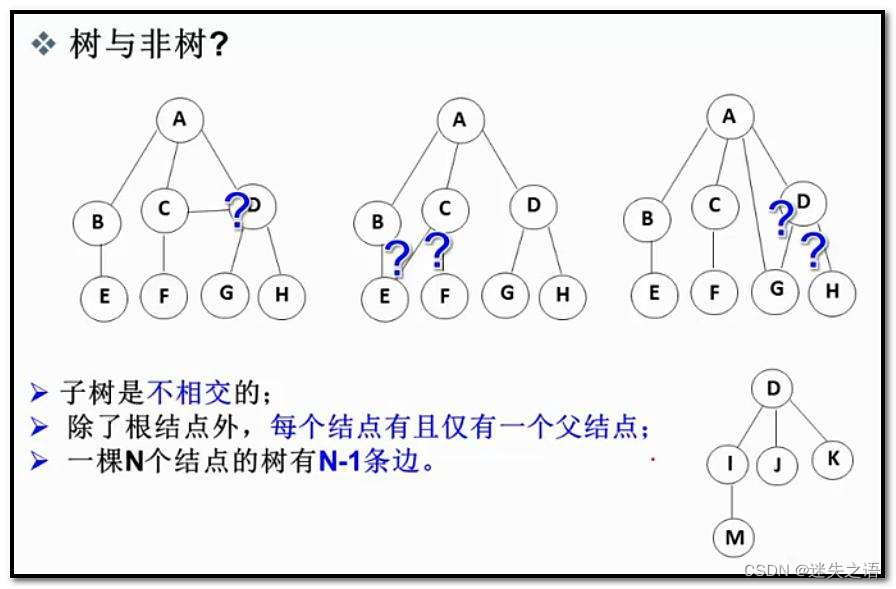
注意:树形结构中,子树之间不能有交集,否则就不是树形结构。
1.3 树的相关概念

1.节点的度 :一个节点含有的子树的个数称为该节点的度; 如上图: A的为6。
2.叶节点或终端节点:度为0的节点称为叶节点; 如上图: B、C、 H、 I...等节点为叶节点。
3.非终端节点或分支节点:度不为0的节点; 如上图: D、 E、 F、G...等节点为分支节点。
4.双亲节点或父节点:若一个节点含有子节点,则这个节点称为其子节点的父节点; 如上图: A是B的父节点。
5.孩子节点或子节点 :一个节点含有的子树的根节点称为该节点的子节点; 如上图: B是A的孩子节点。
6.兄弟节点:具有相同父节点的节点互称为兄弟节点; 如上图: B、C是兄弟节点。
7.树的度 :一棵树中,最大的节点的度称为树的度; 如上图:树的度为6。
8.节点的层次:从根开始定义起,根为第1层,根的子节点为第2层,以此类推;
9.树的高度或深度:树中节点的最大层次; 如上图:树的高度为4。
10.堂兄弟节点:双亲在同一层的节点互为堂兄弟;如上图: H、 I互为兄弟节点。
11.节点的祖先:从根到该节点所经分支上的所有节点;如上图: A是所有节点的祖先。
12.子孙:以某节点为根的子树中任一节点都称为该节点的子孙。如上图:所有节点都是A的子孙。
13.森林:由 m( m>0)棵互不相交的树的集合称为森林;
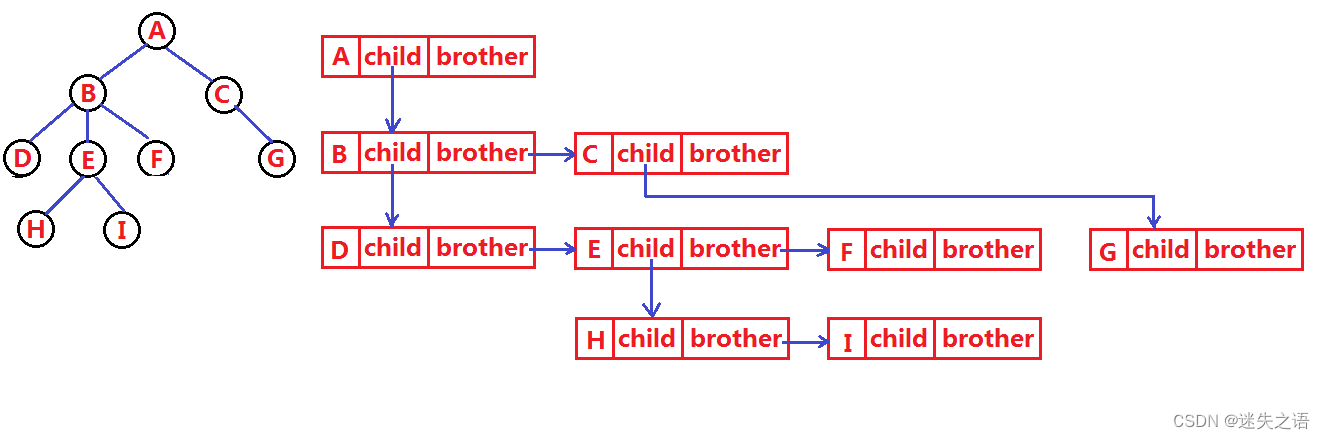
1.4 树的表示
typedef int DataType;
struct Node
{struct Node* _firstChild1; // 第一个孩子结点struct Node* _pNextBrother; // 指向其下一个兄弟结点DataType _data; // 结点中的数据域
};
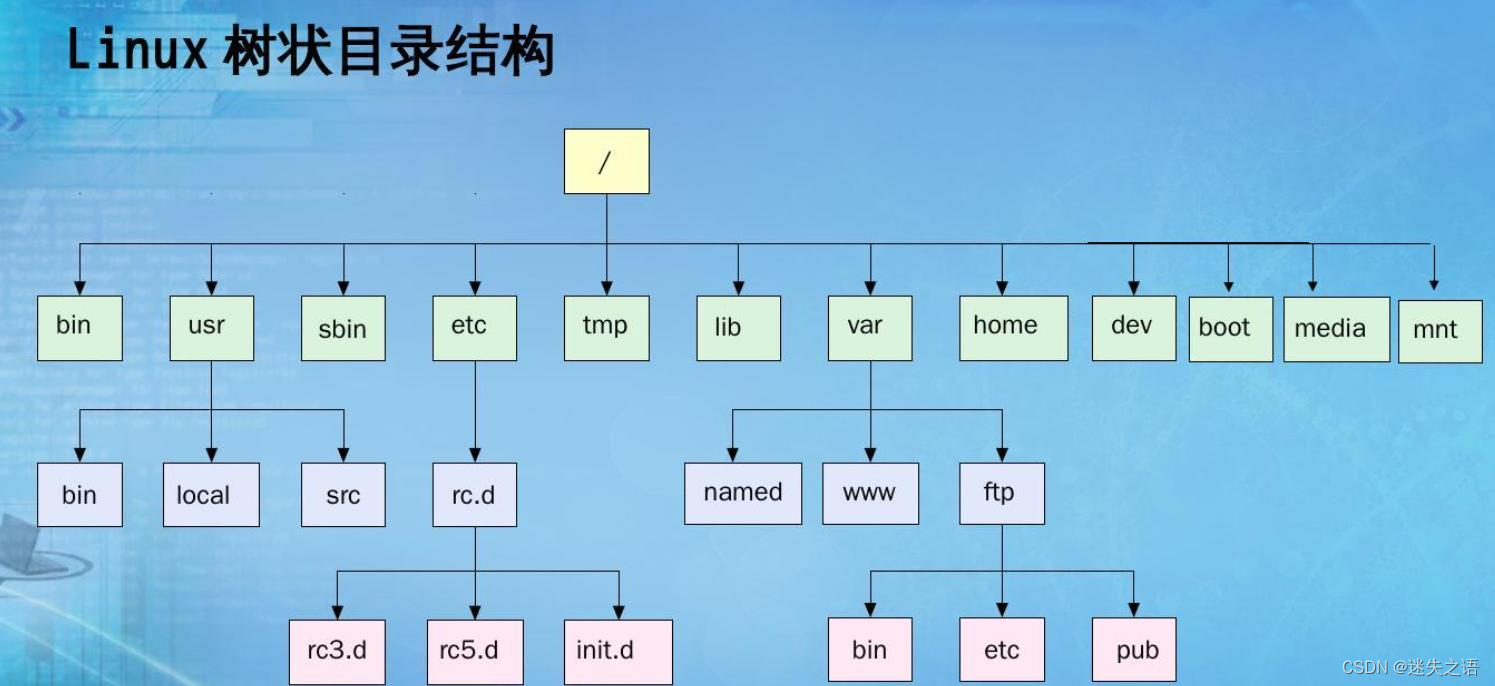
1.5 树在实际中的运用(表示文件系统的目录树结构)
2.二叉树概念及结构
2.1概念


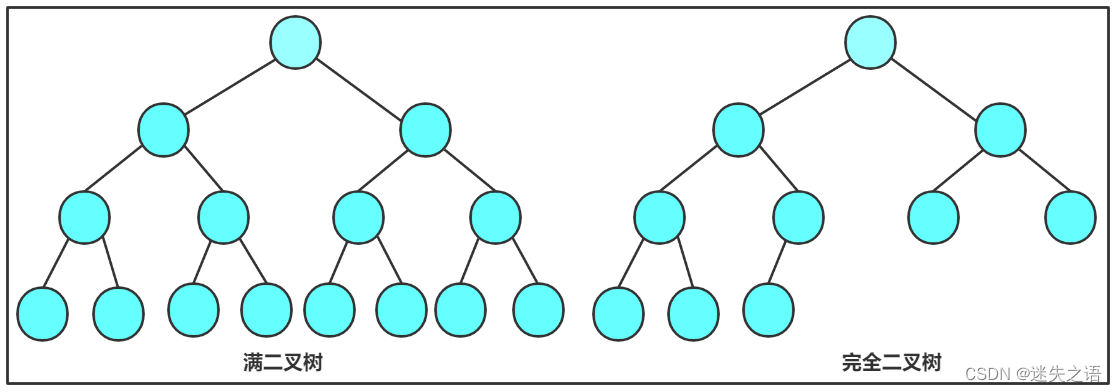
2.3 特殊的二叉树:
1. 满二叉树:
2. 完全二叉树:
2.4 二叉树的性质
1. 若规定根节点的层数为 1 ,则一棵非空二叉树的 第 i 层上最多有个结点。
2. 若规定根节点的层数为 1 ,则 深度为 h 的二叉树的最大结点数是。
3. 对任何一棵二叉树 , 如果度为 0 其叶结点个数为, 度为 2 的分支结点个数为
,则有
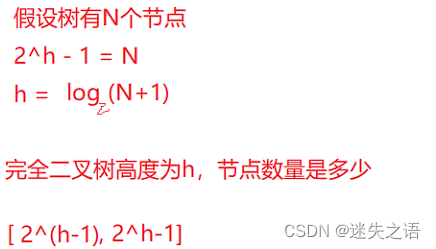
4. 若规定根节点的层数为 1 ,具有 n 个结点的满二叉树的深度 ,。(ps:
是log 以 2为底,n+1 为对数 )
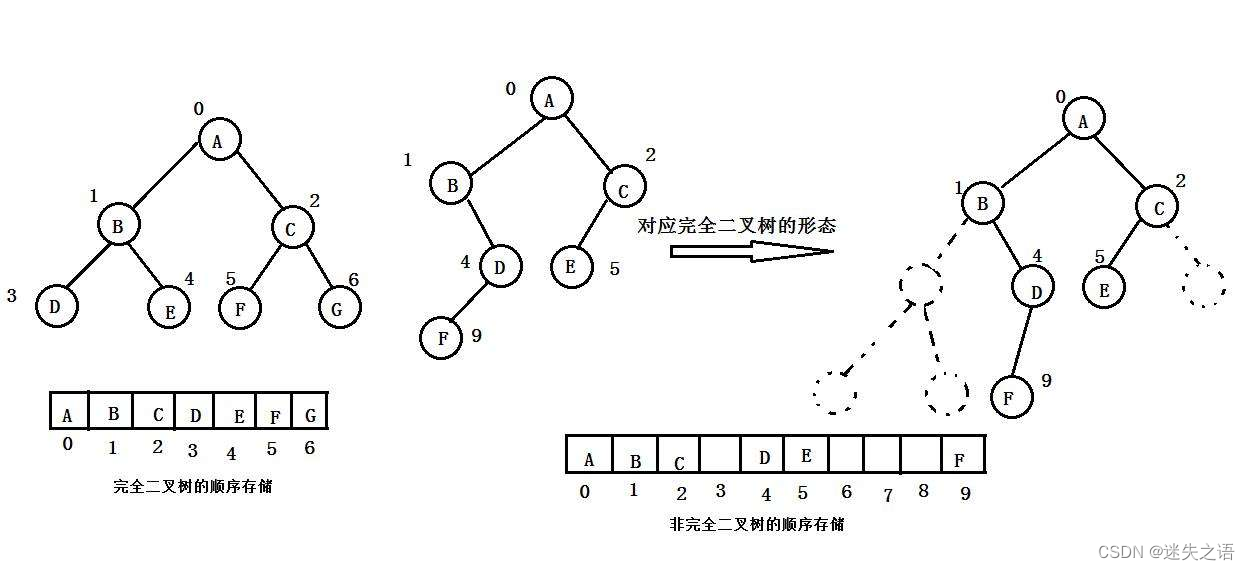
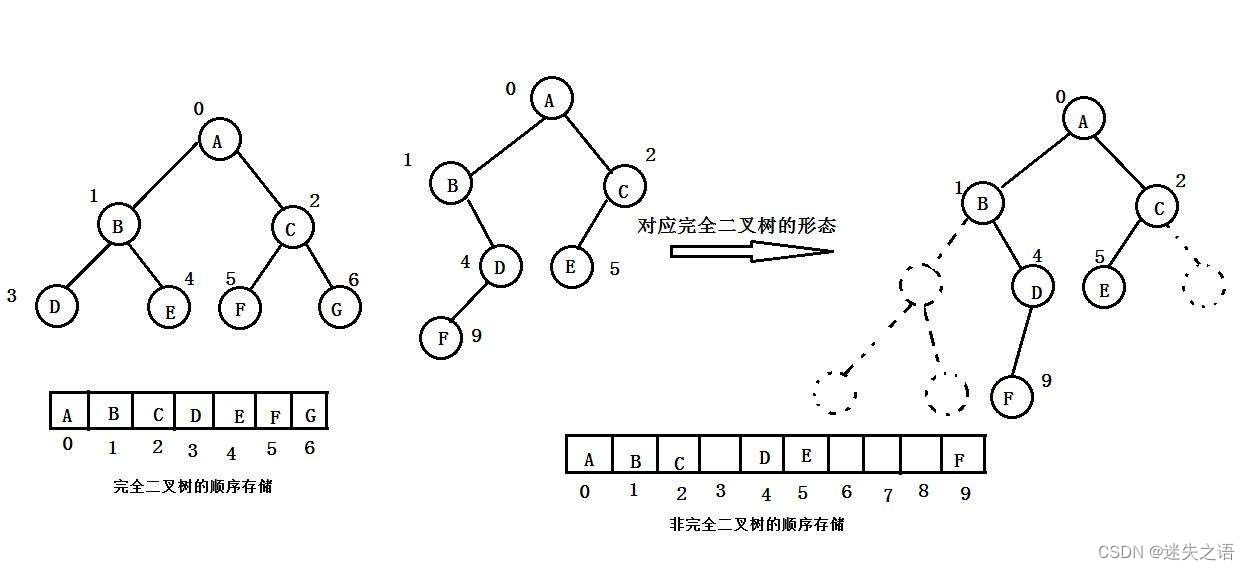
5. 对于具有 n 个结点的完全二叉树,如果按照从上至下从左至右的数组顺序对所有节点从 0 开始编号,则对于序号为i 的结点有:1. 若 i>0 , i 位置节点的双亲序号: (i-1)/2 ; i=0 , i 为根节点编号,无双亲节点。2. 若 2i+1<n ,左孩子序号: 2i+1 , 2i+1>=n 否则无左孩子。3. 若 2i+2<n ,右孩子序号: 2i+2 , 2i+2>=n 否则无右孩子。
2.5 二叉树的存储结构
二叉树一般可以使用两种结构存储,一种顺序结构,一种链式结构。
1. 顺序存储
2. 链式存储
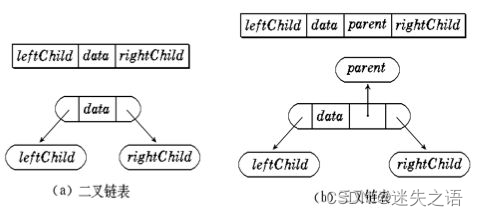
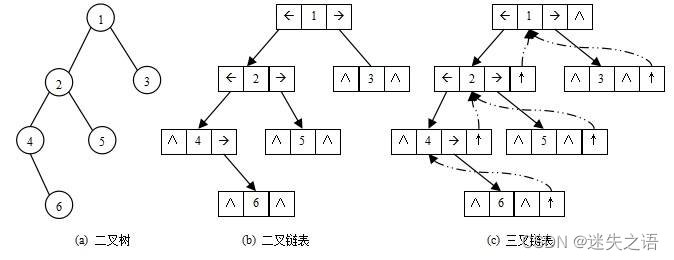
typedef int BTDataType;
// 二叉链
struct BinaryTreeNode
{struct BinTreeNode* _pLeft; // 指向当前节点左孩子struct BinTreeNode* _pRight; // 指向当前节点右孩子BTDataType _data; // 当前节点值域
}
// 三叉链
struct BinaryTreeNode
{struct BinTreeNode* _pParent; // 指向当前节点的双亲struct BinTreeNode* _pLeft; // 指向当前节点左孩子struct BinTreeNode* _pRight; // 指向当前节点右孩子BTDataType _data; // 当前节点值域
};3.二叉树的顺序结构及实现
3.1 二叉树的顺序结构
3.2 堆的概念及结构
3.3 堆的实现
3.2.1 堆向下调整算法
int array[] = {27,15,19,18,28,34,65,49,25,37};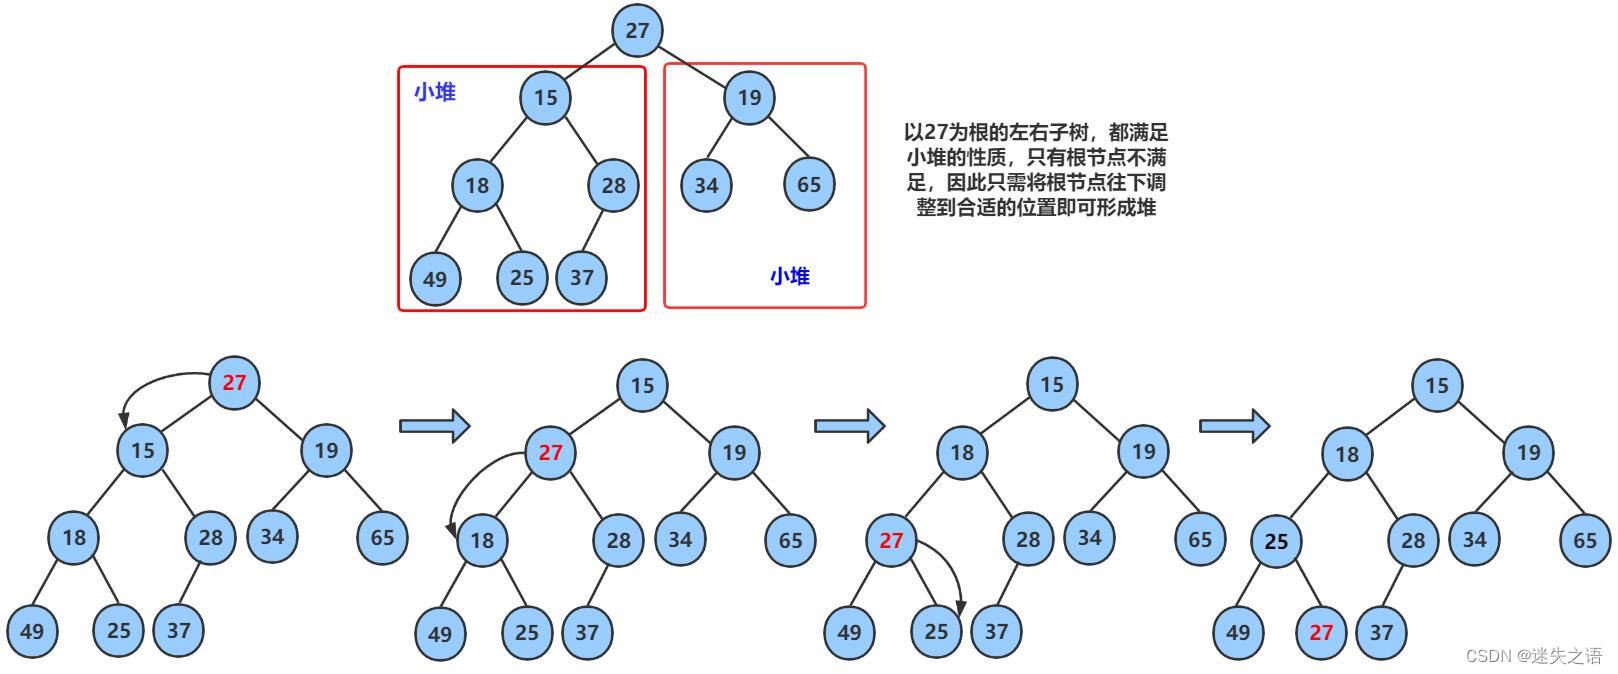
3.2.2堆的创建
int a[] = {1,5,3,8,7,6};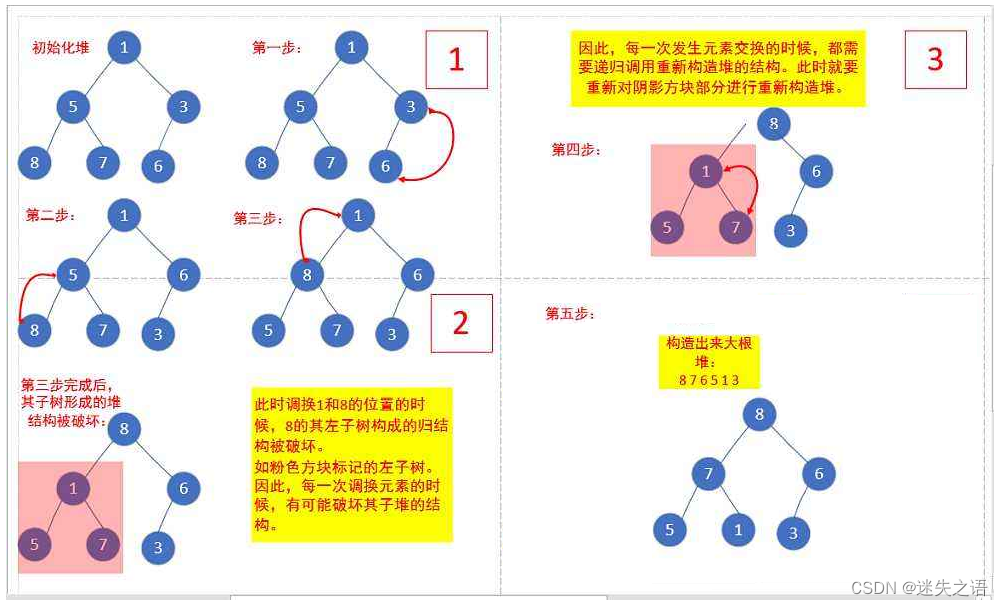
// 小堆
//堆初始化函数
void HeapInit(HP* php)
{assert(php);php->a = NULL;php->size = 0;php->capacity = 0;
}
3.2.3 建堆时间复杂度

3.2.4 堆中元素调整
为了便于插入元素的同时满足堆的特性,我们需要写一个调整堆中元素的函数:
//交换函数
void Swap(HPDataType* p1, HPDataType* p2)
{HPDataType tmp = *p1;*p1 = *p2;*p2 = tmp;
}//向上调整法
void AdjustUp(HPDataType* a, int child)
{int parent = (child - 1) / 2;//while (parent >= 0)while (child > 0){if (a[child] < a[parent]){Swap(&a[child], &a[parent]);child = parent;parent = (child - 1) / 2;//child = (child - 1) / 2;//parent = (parent - 1) / 2;}else{break;}}
}//向下调整法
void AdjustDown(HPDataType* a, int size, int parent)
{int child = parent * 2 + 1;while (child < size){// 假设左孩子小,如果解设错了,更新一下if (child+1 < size && a[child + 1] < a[child]){++child;}if (a[child] < a[parent]){Swap(&a[child], &a[parent]);parent = child;child = parent * 2 + 1;}else{break;}}
}
3.2.5 堆的插入
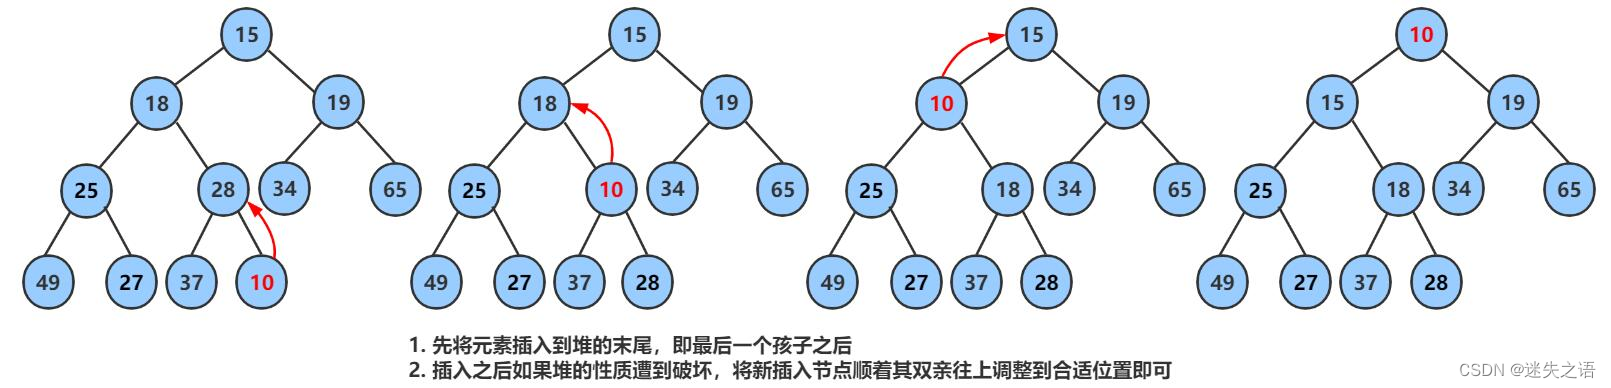
// O(logN)
//堆的插入函数
void HeapPush(HP* php, HPDataType x)
{assert(php);if (php->size == php->capacity){int newCapacity = php->capacity == 0 ? 4 : php->capacity * 2;HPDataType* tmp = (HPDataType*)realloc(php->a, newCapacity * sizeof(HPDataType));if (tmp == NULL){perror("realloc fail");exit(-1);}php->a = tmp;php->capacity = newCapacity;}php->a[php->size] = x;php->size++;AdjustUp(php->a, php->size - 1);
}
3.2.6 堆中元素的判断
为了方便对堆中元素的状况的判断,我们还需要写一下这些函数:
//获取堆顶元素
HPDataType HeapTop(HP* php)
{assert(php);assert(php->size > 0);return php->a[0];
}//获取堆中元素的个数
size_t HeapSize(HP* php)
{assert(php);return php->size;
}//判断堆是否为空
bool HeapEmpty(HP* php)
{assert(php);return php->size == 0;
}
3.2.7 堆中元素的删除
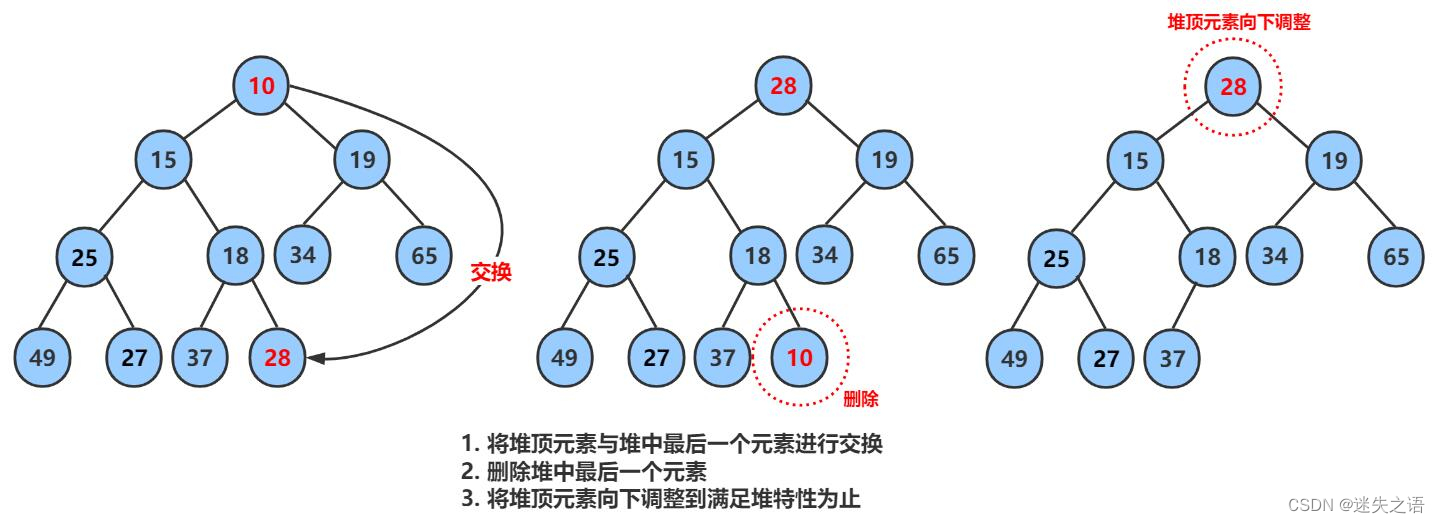
//堆中元素的删除
void HeapPop(HP* php)
{assert(php);assert(php->size > 0);Swap(&php->a[0], &php->a[php->size - 1]);php->size--;AdjustDown(php->a, php->size, 0);
}
3.2.8 堆的摧毁
在堆使用完毕后,我们需要摧毁已经建立的队,释放系统资源,释放之前向系统申请的堆区域的空间。
//摧毁堆
void HeapDestroy(HP* php)
{assert(php);free(php->a);php->a = NULL;php->size = php->capacity = 0;
}
3.2.9 堆的头文件
#define _CRT_SECURE_NO_WARNINGS
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<assert.h>
#include<stdbool.h>
#include<time.h>typedef int HPDataType;typedef struct Heap
{HPDataType* a;int size;int capacity;
}HP;void HeapInit(HP* php);void HeapDestroy(HP* php);void HeapPush(HP* php, HPDataType x);
// 规定删除堆顶(根节点)
void HeapPop(HP* php);HPDataType HeapTop(HP* php);
size_t HeapSize(HP* php);
bool HeapEmpty(HP* php);void Swap(HPDataType* p1, HPDataType* p2);
void AdjustUp(HPDataType* a, int child);
void AdjustDown(HPDataType* a, int size, int parent);
3.3 堆的应用
3.3.1 堆排序

// 升序堆排
void HeapSort(int* a, int n)
{// 建大堆// O(N*logN)/*for (int i = 1; i < n; i++){AdjustUp(a, i);}*/// O(N)for (int i = (n-1-1)/2; i >= 0; --i){AdjustDown(a, n, i);}int end = n - 1;while (end > 0){Swap(&a[0], &a[end]);AdjustDown(a, end, 0);--end;}
}
3.3.2 TOP-K问题
//创建文件存入10000000个随机数
void CreateNDate()
{// 造数据int n = 10000000;srand(time(0));const char* file = "data.txt";FILE* fin = fopen(file, "w");if (fin == NULL){perror("fopen error");return;}for (int i = 0; i < n; ++i){int x = (rand()+i) % 10000000;fprintf(fin, "%d\n", x);}fclose(fin);
}//堆排获取文件中最大的k个数
void PrintTopK(const char* file, int k)
{FILE* fout = fopen(file, "r");if (fout == NULL){perror("fopen error");return;}// 建一个k个数小堆int* minheap = (int*)malloc(sizeof(int) * k);if (minheap == NULL){perror("malloc error");return;}// 读取前k个,建小堆for (int i = 0; i < k; i++){fscanf(fout, "%d", &minheap[i]);AdjustUp(minheap, i);}int x = 0;while (fscanf(fout, "%d", &x) != EOF){if (x > minheap[0]){minheap[0] = x;AdjustDown(minheap, k, 0);}}for (int i = 0; i < k; i++){printf("%d ", minheap[i]);}printf("\n");free(minheap);fclose(fout);
}4.二叉树链式结构的实现
4.1 前置说明
typedef int BTDataType;
typedef struct BinaryTreeNode
{BTDataType _data;struct BinaryTreeNode* left;struct BinaryTreeNode* right;
}BTNode;BTNode* CreatBinaryTree()
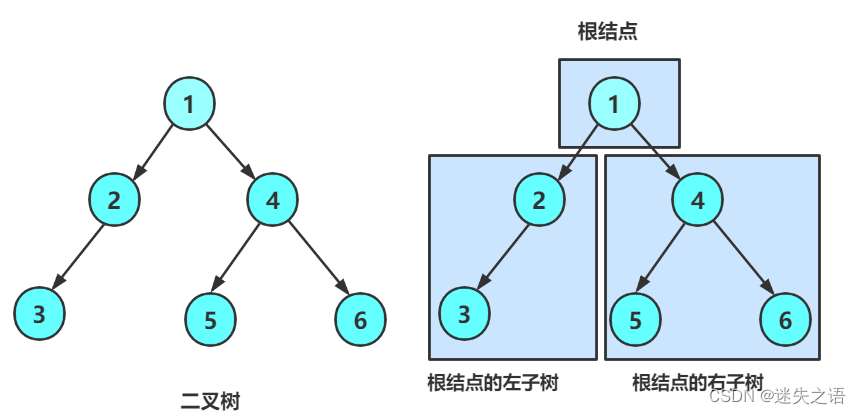
{BTNode* node1 = BuyNode(1);BTNode* node2 = BuyNode(2);BTNode* node3 = BuyNode(3);BTNode* node4 = BuyNode(4);BTNode* node5 = BuyNode(5);BTNode* node6 = BuyNode(6);node1->left = node2;node1->right = node4;node2->left = node3;node4->left = node5;node4->right = node6;return node1;
}
4.2二叉树的遍历
4.2.1 前序、中序以及后序遍历
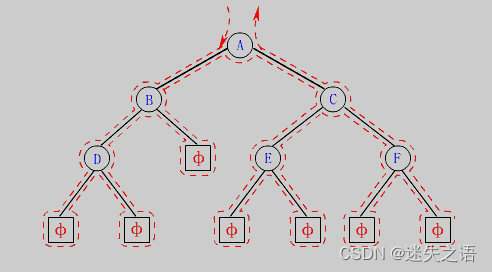
按照规则,二叉树的遍历有: 前序 / 中序 / 后序的递归结构遍历 :1. 前序遍历 (Preorder Traversal 亦称先序遍历 )—— 访问根结点的操作发生在遍历其左右子树之前。2. 中序遍历 (Inorder Traversal)—— 访问根结点的操作发生在遍历其左右子树之中(间)。3. 后序遍历 (Postorder Traversal)—— 访问根结点的操作发生在遍历其左右子树之后。由于被访问的结点必是某子树的根,所以 N(Node )、 L(Left subtree )和 R(Right subtree )又可解释为 根、根的左子树和根的右子树 。 NLR 、 LNR 和 LRN 分别又称为先根遍历、中根遍历和后根遍历。
// 二叉树前序遍历
void BinaryTreePrevOrder(BTNode* root)
{if (root == NULL){return;}printf("%c ", root->data);BinaryTreePrevOrder(root->left);BinaryTreePrevOrder(root->right);
}// 二叉树中序遍历
void BinaryTreeInOrder(BTNode* root)
{if (root == NULL){return;}BinaryTreeInOrder(root->left);printf("%c ", root->data);BinaryTreeInOrder(root->right);
}// 二叉树后序遍历
void BinaryTreePostOrder(BTNode* root)
{if (root == NULL){return;}BinaryTreePostOrder(root->left);BinaryTreePostOrder(root->right);printf("%c ", root->data);
}


前序遍历结果: 1 2 3 4 5 6
中序遍历结果: 3 2 1 5 4 6
后序遍历结果: 3 2 5 6 4 1
4.2.2 层序遍历
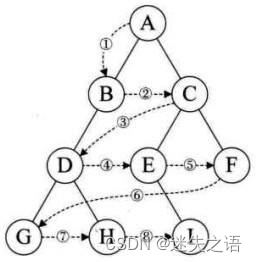
// 层序遍历
void BinaryTreeLevelOrder(BTNode* root)
{Queue q;   //这里创建了一个队列,借助队列先进先出的特性实现了层序QueueInit(&q);   //队列初始化if (root){QueuePush(&q, root);  //元素入队列}int levelsize = 1;while (!QueueEmpty(&q))      //队列为空停止训话{while (levelsize--)       {BTNode* front = QueueFront(&q);  //获取队头元素QueuePop(&q);                    //删除队头printf("%c ", front->data);if (front->left){QueuePush(&q, front->left);   //元素入队列}if (front->right){QueuePush(&q, front->right);}}printf("\n");levelsize = QueueSize(&q);    //获取队列元素个数}printf("\n");QueueDestroy(&q);                 //摧毁队列}
4.3 节点个数以及高度等
// 二叉树节点个数
int BinaryTreeSize(BTNode* root)
{return root == NULL ? 0 : 1 + BinaryTreeSize(root->left) + BinaryTreeSize(root->right);
}// 二叉树叶子节点个数
int BinaryTreeLeafSize(BTNode* root)
{if (root == NULL){return 0;}if (root->left == NULL && root->right == NULL){return 1;}return   BinaryTreeLeafSize(root->left) + BinaryTreeLeafSize(root->right);
}// 二叉树第k层节点个数
int BinaryTreeLevelKSize(BTNode* root, int k)
{assert(k > 0);if (root == NULL)return 0;if (k == 1)return 1;return TreeLevelK(root->left, k - 1)+ TreeLevelK(root->right, k - 1);
}// 二叉树查找值为x的节点
BTNode* BinaryTreeFind(BTNode* root, BTDataType x)
{if (root == NULL){return NULL;}if (root->data==x){return root;}BTNode* left = BinaryTreeFind(root->left,x);if (left){return left;}BTNode* right = BinaryTreeFind(root->right,x);if (right){return right;}return NULL;
}// 判断二叉树是否是完全二叉树
int BinaryTreeComplete(BTNode* root)
{Queue q;           //同样借助队列进行QueueInit(&q);QueuePush(&q, root);while(!QueueEmpty(&q)){BTNode* front = QueueFront(&q);QueuePop(&q);if (front == NULL){break;}QueuePush(&q, front->left);QueuePush(&q, front->right);}//如果节点为空,但队列此时不为零while (!QueueEmpty(&q)){BTNode* front = QueueFront(&q);QueuePop(&q);if (front == NULL){QueueDestroy(&q);return 0;}}QueueDestroy(&q);return 1;}
4.4 二叉树的创建和销毁
//创建二叉树
BTNode *BinaryTreeCreate(BTDataType * src, int n, int* pi)
{if (*pi >= n || src[*pi] == '#'){(*pi)++;return NULL;}BTNode * cur = (BTNode *)malloc(sizeof(BTNode));cur->_data = src[*pi];(*pi)++;cur->left = BinaryTreeCreate(src, n, pi);cur->right = BinaryTreeCreate(src, n, pi);return cur;
}//摧毁二叉树void BinaryTreeDestory(BTNode** root)
{if (*root){BinaryTreeDestory(&(*root)->left);BinaryTreeDestory(&(*root)->right);free(*root);*root = NULL;}
}
4.5 二叉树头文件
#pragma once
#define _CRT_SECURE_NO_WARNINGS
#include<stdio.h>
#include<stdlib.h>
#include<assert.h>
typedef char BTDataType;typedef struct BinaryTreeNode
{BTDataType data;struct BinaryTreeNode* left;struct BinaryTreeNode* right;
}BTNode;// 通过前序遍历的数组"ABD##E#H##CF##G##"构建二叉树
BTNode* BinaryTreeCreate(BTDataType* a, int n, int* pi);
// 二叉树销毁
void BinaryTreeDestory(BTNode** root);
// 二叉树节点个数
int BinaryTreeSize(BTNode* root);
// 二叉树叶子节点个数
int BinaryTreeLeafSize(BTNode* root);
// 二叉树第k层节点个数
int BinaryTreeLevelKSize(BTNode* root, int k);
// 二叉树查找值为x的节点
BTNode* BinaryTreeFind(BTNode* root, BTDataType x);
// 二叉树前序遍历
void BinaryTreePrevOrder(BTNode* root);
// 二叉树中序遍历
void BinaryTreeInOrder(BTNode* root);
// 二叉树后序遍历
void BinaryTreePostOrder(BTNode* root);
// 层序遍历
void BinaryTreeLevelOrder(BTNode* root);
// 判断二叉树是否是完全二叉树
int BinaryTreeComplete(BTNode* root);
本章结束!


)


)


