前言
今天开始学习数仓的内容,之前花费一年半的时间已经学完了 Hadoop、Hive、Zookeeper、Spark、HBase、Flume、Sqoop、Kafka、Flink 等基础组件。把学过的内容用到实践这是最重要的,相信会有很大的收获。
1、数据仓库概念
1.1、概念
数据仓库( Data Warehouse ),是为企业制定决策,提供数据支持的。可以帮助企业,改进业务流程、提高产品质量等。(数据仓库的目的不只是简单的存储数据,而是把收集起来的数据进行计算分析,得到有价值的信息)
1.2、数据分类
数据仓库的输入数据通常包括:业务数据、用户行为数据和爬虫数据等
业务数据:就是各行业在处理事务过程中产生的数据。比如用户在电商网站中登录、下单、支付等过程中,需要和网站后台数据库进行增删改查交互,产生的数据就是业务数据。业务数据通常存储在MySQL、Oracle等数据库中(要求响应要快)。
用户行为数据:用户在使用产品过程中,通过埋点收集与客户端产品交互过程中产生的数据,并发往日志服务器进行保存。比如页面浏览、点击、停留、评论、点赞、收藏等。用户行为数据通常存储在日志文件中。
爬虫数据:通常是通过爬虫等技术获取其他公司网站的数据。
1.3、数仓架构
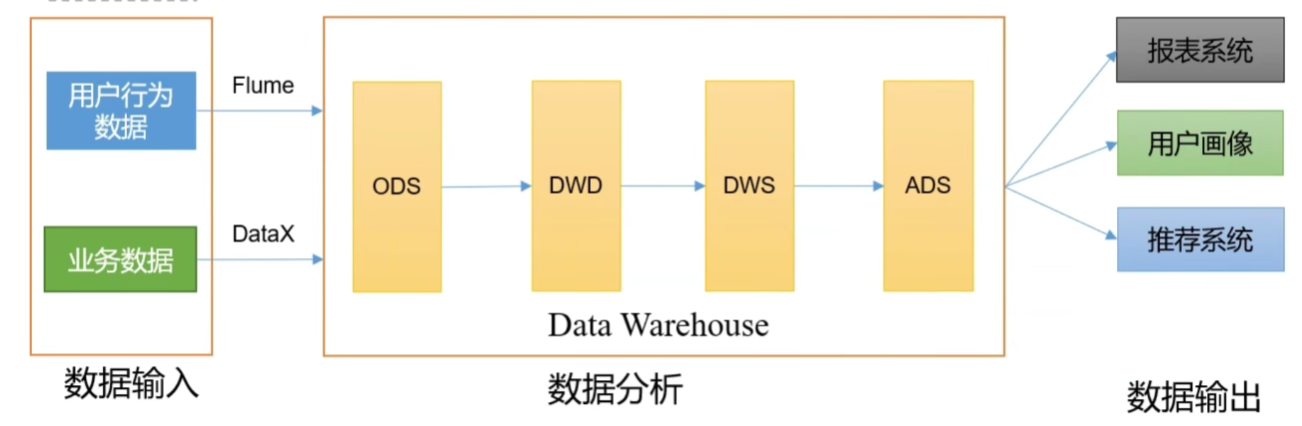
- ODS 层(原始数据层):离线数仓中一般是 Hive,用来做数据备份(如果后面的 DWD 、DWS、ADS 层数据丢失,都可以通过上一层来进行恢复)
- DWD 层(明细数据层):主要做数据清洗(对错误缺失数据进行处理,以及一些隐私信息的脱敏)
- DWS 层(汇总数据层):预聚合(做一些表的连接 join 之类的操作,提前 join,节省计算开销)
- ADS 层(数据应用层):统计最终指标
数据仓库并不是数据的最终目的,而是为数据最终的目的做准备,包括比如:备份、清洗、聚合、统计等。
2、项目需求及架构设计
2.1、项目需求分析
1)采集平台
- 用户行为数据采集平台搭建
- 业务数据采集平台搭建
2)离线需求
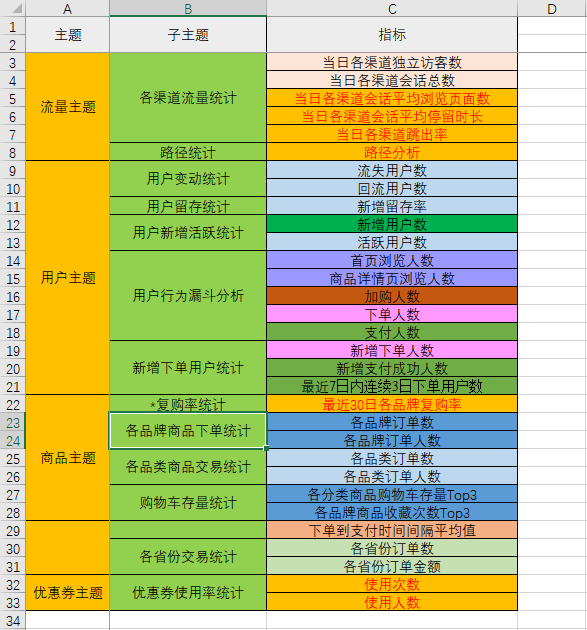
3)实时需求
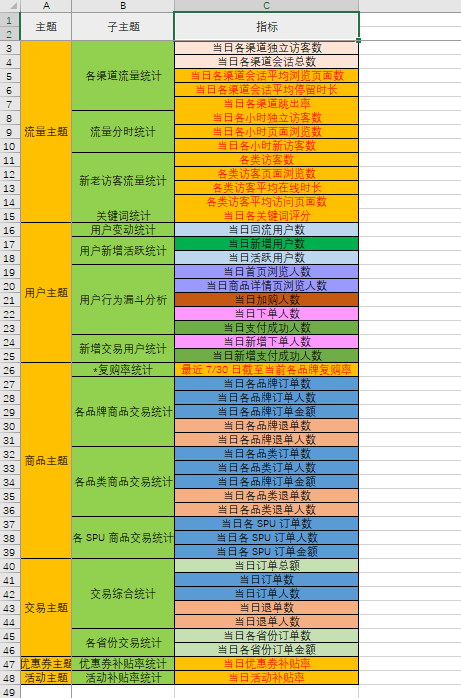
2.2、项目框架
1. 技术选型
考虑因素:数据量大小、业务需求、行业内经验、技术成熟度(比如spark/flink)、开发维护成本、总成本预算等
- 数据采集传输:Flume(用户行为数据采集,因为这部分数据都是日志文件的形式),DataX(业务数据采集,因为要把数据从 MySQL 传输到 HDFS),MaxWell(功能类似于 DataX 但是 DataX 是全量同步,MaxWell 是增量同步),Kafka(流量削峰),Sqoop(功能和 Datax 一样,也可以使用)
- 数据存储:MySQL(离线数仓和实时数仓的计算结果都会存到 MySQL 供数据展示),HDFS,HBase(实时数仓),Redis(实时数仓),MongoDB(一般存储爬虫的数据,这里不用)
- 数据计算:Hive,Spark(一般只用在离线,Hive on Spark 结合使用),Flink,Storm(这里不用),Tez(同样是一个基于内存的离线引擎,这里也不用)
- 即席查询:Presto(用于离线),Kylin(用于离线,这里不用),Impala(用于离线,这里不用),Druid(用于实时,这里不用),ClickHouse(用于实时),Doris(用于实时,这里不用)
- 数据可视化;Superset(用于离线),Echarts,Sugar(用于实时),QuickBI,DataV
- 任务调度:DolphinScheduler(国产开源,兼具轻量级和功能丰富,用于离线),Azkaban(轻量级,用法简单),Oozie(重量级,功能更多),Airflow(Python 写的一款框架)
- 集群监控:Zabbix(离线),Prometheus(实时)
- 元数据管理:Atlas(管理表和表之间的关系)
- 权限管理:Ranger(HDP 公司),Sentry(CDH 公司)
2. 系统数据流设计
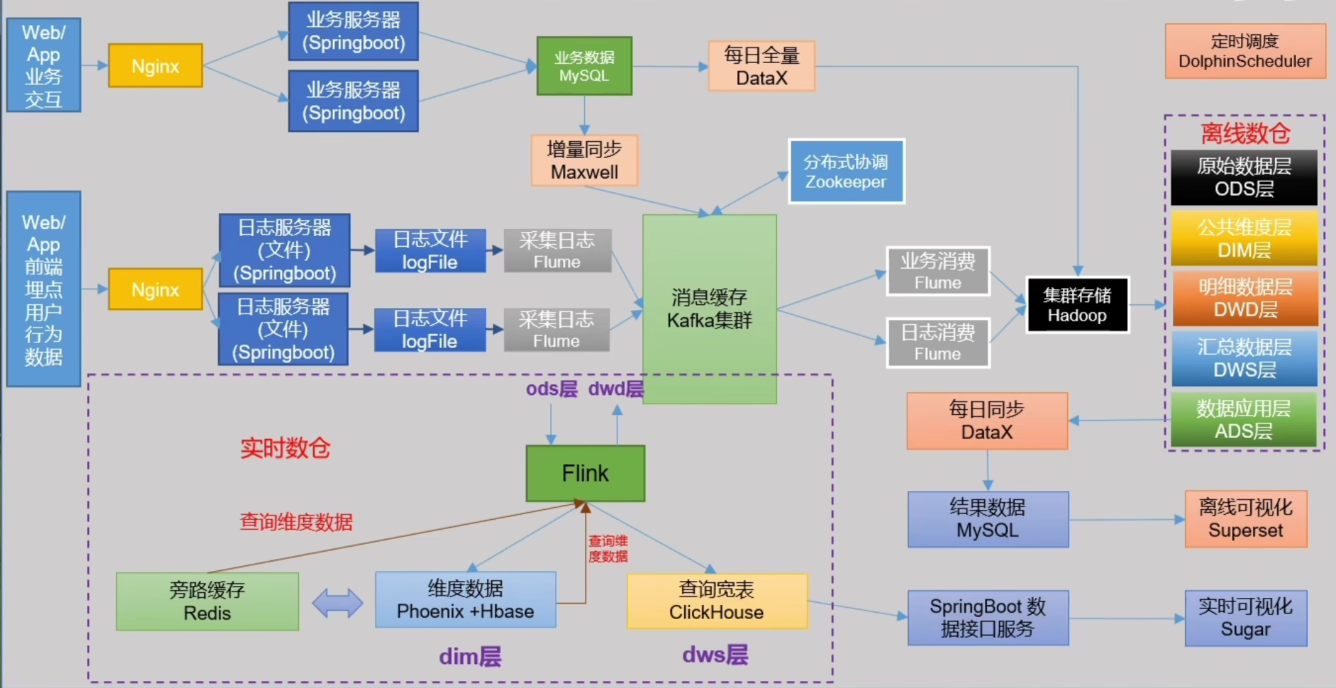
这里 Kafka 不管是离线数仓还是实时数仓都是一个不可缺少的中间件。
3. 框架版本选项
3.1、Apache/CDH/HDP
我们使用 Apache 版本,但是组件的兼容性需要我们自己解决。
CDH 版本很稳定但是它是收费的,HDP 版本可以二次开发但是不稳定。
3.2、云服务
- 阿里云 EMR(包含常用的大部分大数据框架)、MaxCompute、DataWorks
- 亚马逊 EMR
- 腾讯云 EMR
- 华为云 EMR
3.3、具体版本选择
- Hadoop 3.1.3
- Zookeeper 3.5.7
- MySQL 5.7.16
- Hive 3.1.2
- Flume 1.9.0
- Kafka 3.0.0
- Spark 3.0.0
- DataX 3.0.0
- Superset 1.3.2
- Dolphinscheduler 2.0.3
- Maxwell 1.29.2
- Flink 1.13.0
- Redis 6.0.8
- HBase 2.0.5
- ClickHouse 20.4.5.36-2
4. 服务器选型
4.1、物理机
- 128G 内存,20 核物理 CPU,40 线程,8 THDD 和 2T SSD 硬盘,戴尔品牌单台报价 4w+ ,寿命 5 年左右。
- 需要考虑运维人员、电费成本。
4.2、云主机
- 5w 左右每年,不需要考虑运维、电费成本。
4.3、企业选择
- 有钱的公司(大城市的一些对技术不太讲究的公司,比如金融公司)会选择阿里云
- 中小型公司有钱后会购买物理机(数据放在自己手里更放心)
- 有长期打算,资金充足的公司也会选择物理机
5. 集群规模
确认集群规模:
- 每天日活跃用户 100 万,每人每天创造 100 条数据: 100w * 100 = 1亿条
- 每条数据 1KB ,每天:1亿 / 1024 / 1024 ≈ 100GB
- 半年不扩容服务器来算:100GB * 180天 ≈ 18TB
- 保存 3 个副本:18TB * 3 = 54 TB
- 预留 20%~30% buf:54TB / 0.7 = 77TB
算到这里需要大概 8T * 10 台服务器,但是数仓是分层的,我们的数据在 ODS 层(原始数据层)是主要的消耗磁盘的地方,而其他几层也是需要消耗磁盘存放中间结果的,所以结果应该比我们预估的更大!但是又考虑到数据在存储时可以压缩(100GB 可以压缩到 5~10GB左右),所以我们其实只需要 3 台服务器就可以保证半年内每天 100 GB 数据的计算存储,5~10 台服务器则可以保证 2~3 年数据该数据的计算和存储。
6. 集群资源规划设计
在企业中通常会搭建一套生产集群(十几、甚至几十几百台)和一套测试集群(3~5台)。生产集群运行生产任务,测试集群用于上线前代码编写和测试。
| 服务名称 | 子服务 | 服务器 hadoop102 | 服务器 hadoop103 | 服务器 hadoop104 |
| HDFS | NameNode | √ | ||
| DataNode | √ | √ | √ | |
| SecondaryNameNode | √ | |||
| Yarn | NodeManager | √ | √ | √ |
| Resourcemanager | √ | |||
| Zookeeper | Zookeeper Server | √ | √ | √ |
| Flume(采集日志) | Flume | √ | √ | |
| Kafka | Kafka | √ | √ | √ |
| Flume (消费Kafka日志) | Flume | √ | ||
| Flume (消费Kafka业务) | Flume | √ | ||
| Hive | √ | √ | √ | |
| MySQL | MySQL | √ | ||
| DataX | √ | √ | √ | |
| Spark | √ | √ | √ | |
| DolphinScheduler | ApiApplicationServer | √ | ||
| AlertServer | √ | |||
| MasterServer | √ | |||
| WorkerServer | √ | √ | √ | |
| LoggerServer | √ | √ | √ | |
| Superset | Superset | √ | ||
| Flink | √ | |||
| ClickHouse | √ | |||
| Redis | √ | |||
| Hbase | √ | |||
| 服务数总计 | 20 | 11 | 12 |
总结
到这里,数仓基本的概念是了解了,这个项目会用到哪些技术也基本明白了(Hadoop、Hive、MySQL、Spark、Flume、Kafka、HBase、DataX等),接下来就是慢慢熟练之前学的哪些框架在实际应用中是怎么使用的,一些没学过的框架(比如 DataX、Superset、DoplhinScheduler)慢慢补,都是小工具 so easy。
)


![【PyTorch][chapter 15][李宏毅深度学习][Neighbor Embedding-LLE]](http://pic.xiahunao.cn/【PyTorch][chapter 15][李宏毅深度学习][Neighbor Embedding-LLE])

—— 类与对象(1))


)


