主成分分析碎石图_ISLR读书笔记十九:主成分分析(PCA)

本文使用 Zhihu On VSCode 创作并发布

前面写的一些统计学习方法都是属于监督学习(supervised learning),这篇主成分分析(principal components analysis,简称 PCA )和下一篇聚类分析(clustering)都是属于非监督学习(unsupervised learning)。

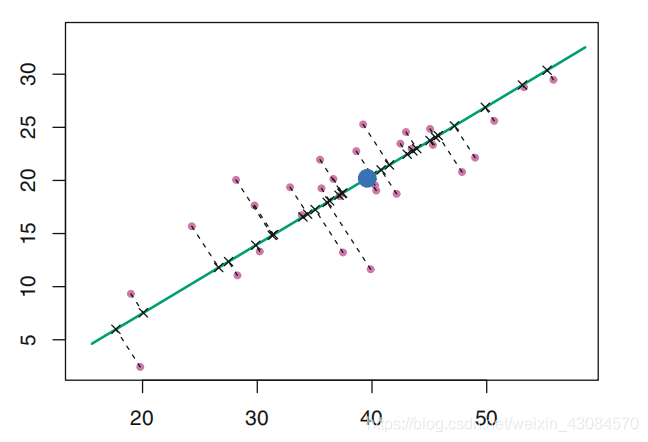
之前 ISLR读书笔记十二 中已经提到过主成分这一概念。其主要目的是利用一小部分数据组合,尽可能多地体现 全部数据的特征,从而实现降维的作用。

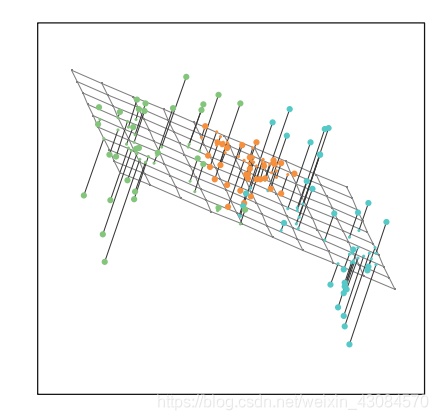
这里的 尽可能多地体现 可以有两种解读:

  1. 将数据投影到方差最大的方向上,尽可能保留方差信息

9530ba9d0ad643b5c8c01ba85af912d1.png

2. 低维空间下的最佳近似。

8ff961d1e320ed2449b0962fa379dd48.png

从第一种解读出发,计算第一主成分:
令

这里要求

,
称作加载(loadings),
称作加载向量(loading vector)

由于只关心数据的方差,所以可以对数据进行中心化,即要求

对于每一个分量

第一主成分使得样本方差最大。即

由于

,所以即,使得
最大。这里,
称作分数(scores)

该优化问题,可以用奇异值分解(SVD)的方法解得。

第二主成分是所有与第一主成分

不相关(uncorrelated)的,关于
的线性组合中,方差最大的线性组合。令

可以证明

与
不相关,等价于加载向量
与
正交。

第三主成分是所有与

、
不相关(uncorrelated)的,关于
的线性组合中,方差最大的线性组合。以此类推。

从第二种解读出发,第一主成分加载向量是

维空间中,最接近
个观测数据的直线(在欧式距离平方的均值下最接近)。

更一般地,前
个主成分的分数向量和加载向量,构成了原始
维数据在
维空间的最佳近似,即

另外 PCA 还有其他一些需要注意的点:

规模化:

数据通常需要提前进行规模化(scaled)(每个变量乘以不同的常数),使得每个自变量的标准差为1。否则如果有部分变量方差特别大,那么PCA 的结果会受很大影响。

唯一性

每一个主成分在相差一个正负号的意义下式唯一的

被解释方差比例

我们通常关心前几个主成分反映了多少方差
数据总方差定义如下

第

个主成分的被解释方差定义如下:

第

个主成分被解释方差的比例(proportion of variance explained)

即为

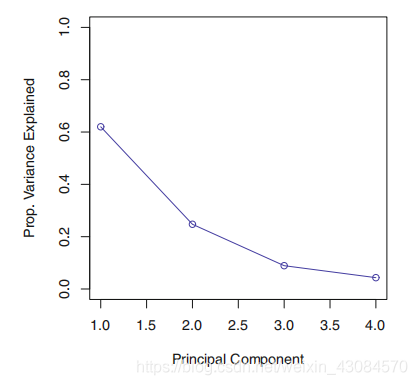
决定主成分的个数

可以通过碎石图(scree plot),来决定主成分的个数
方法是寻找一个点,在这个点之后的点,主成分被解释方差比例很小
f2b6544fac4ba9f2b33eec6204064725.png

本文来自互联网用户投稿,该文观点仅代表作者本人,不代表本站立场。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如若转载,请注明出处:http://www.tpcf.cn/news/567379.html

如若内容造成侵权/违法违规/事实不符,请联系多彩编程网进行投诉反馈email:809451989@qq.com,一经查实,立即删除!

相关文章

office另存为pdf的加载项_pdf怎么转换成word?打工人必备的丛林法则

小编接受了一个工作,要批量将pdf转换成word,而且不太花钱的我(和大部分人一样,只想找免费的工具),在同事的帮助下,找到了很不错的办法,再加上我自己总结的几个办法,给大家分享一些干货。网上有不…

使用gdisk中的n新建分区时没有p和e选项

正常分区界面为: 但是分区时发现 不可选择主分区或者扩展分区。 原因分析: 1、使用p命令查看:已有三个分区 2、再进行分区时: 可能是默认的一个扩展分区---如果可以创建多个逻辑分区 也可能是一个主分区--只能创建一个主分区…

node本地连接服务器的数据库_基于Node.jsORM框架Sequelize的数据库迁移一

开课吧Web前端教程前言在日常的后端项目开发中,我们经常需要和数据库打交道。在这个过程中,我们需要创建数据库、表还有一些测试数据。许多时候,因为业务需求的变更导致的数据库结构的变化,需要修改数据库,添加新的测试…

使用OfficeTool免费安装Office

1、在office tool plus官网下载office tool plus Office Tool Plus 官方网站 - 一键部署 Office 2、安装office tool plus 3、卸载原office:点击工具箱-修复工具-移除Office,选择使用Office Tool Plus移除Office,点击开始。 4、点击部署-产品…

语言线性拟合线对称_文科生都能看懂的机器学习教程:梯度下降、线性回归、逻辑回归...

【新智元导读】虽然在Coursera、MIT、UC伯克利上有很多机器学习的课程,包括吴恩达等专家课程已非常经典,但都是面向有一定理科背景的专业人士。本文试图将机器学习这本深奥的课程,以更加浅显易懂的方式讲出来,让没有理科背景的读者…

c/c++读取txt文件中指定行的内容_和尧名大叔一起从0开始学Python编程-简单读写文件

0基础自学编程是很痛苦的一件事情,所以我想把自己学习的这个过程记录下来,让想学编程的人少走弯路,大叔文化程度较低,可能会犯一些错误,欢迎大家督促我。今天,我们来学习一下用Python简单读写文件&#xff…

excel从只有省市县的地址中分别提取省、市、县

提取省 LEFT(H2,MIN(FIND({"省","市","区"},H2&"省市区"))) 提取市 LEFT(SUBSTITUTE(H23,I23,""),MIN(FIND({"市","区","县","州"},SUBSTITUTE(H23,I23,"")&&qu…

两个字符串组成tuple_史上最全python字符串操作指南

惨不忍睹拿出了看家的老中医野广告,都没能拯救惨淡的selenium剧集。上周五和朋友聊天,说希望看到一些python基础的知识。本来还担心更新基础的东西没人看,但现在看来,最差不过selenium系列了...哈哈。虽然说更新基础知识&#xff…

python3数据科学入门与实战_Python3学习之Python3数据科学入门与实战视频教程

Python3学习之Python3数据科学入门与实战视频教程 Python3数据科学入门与实战 这是一个数据驱动的时代,想要从事机器学习、人工智能、数据挖掘等前沿技术,都离不开数据跟踪,本课程通过Numpy、Pandas进行数据科学计算,通过Seaborn、…

语言五子棋无ai程序框图_微软多语言预训练模型T-ULRv2登顶XTREME排行榜

编者按:为进一步实现用 AI 赋能用户体验,微软正在不断拓展多语言模型的边界。近日,由微软图灵团队与微软亚洲研究院联合探索的最新跨语言研究成果——多语言预训练模型 T-ULRv2,登顶 XTREME 排行榜,T-ULRv2 可以在相同…

excel学习

1.高配筛选—切片器 (1)创建超级表 选中某个单元格,插入,表格。 (2)插入切片器 插入—切片器 (3)改变切片器样式 选中菜单栏切片器,按钮,选择横排 2.subtotal实现动态编号 3-counta 过滤筛选 103-counta 过滤筛选和隐藏

keil3如何放大字体_Word技巧之快速放大字体!快来GET新技能!

一般情况下我们都会选择用Word编辑文章,文章编辑完成之后我们通常会对文章进行排版。在排版的过程中如果我们需要将Word字体放大该怎么办呢?今天倾尘跟大家分享的就是办公小技巧:Word 里的字体如何无限放大?方法一:点击…

dlib简便下载方法

一、查看已安装Python版本 二、下载python对应版本的dlib.wlh文件 官方网上边是没有3.7版本往后的dlib,想要下载其它版本的dlib自己去找了,但是我这里只有3.8的需要下载的可以点这里 提取码:dlib 三、在dlib.wlh文件所在路径下,安…

stm32 web get 参数_BlackHat2020议题之Web缓存投毒

周末闲着没事就来学习下新的思路,文章很长,花了一天时间才码出来,所以,你懂我意思吧?对了,周末打算出去走走,所以就不更文了本文将会介绍Web缓存投毒的各种骚姿势以及利用链,并会搭配相应案例进行讲解&…

c3p0 服务启动获取连接超时_JDBC数据库连接池

连接池的本质是构建一个容器,容器是用来存创建好的线程,http连接、数据库连接、netty连接等各个连接池的使用大致分为三个部分1、首先是初始化连接池,根据设置相应的参数、连接池的大小、核心连接数等参数,初始化创建数据库、http…

人脸检测,关键点识别,人脸对齐

import cv2 import dlib import numpy as np import math PREDICTOR_PATH "E:/Testcomptition/shape_predictor_68_face_landmarks.dat" predictor dlib.shape_predictor(PREDICTOR_PATH) # 用来预测关键点 detector dlib.get_frontal_face_detector() class Fac…

python与数据处理_python数据处理:数据合并和Reshaping

本文资料来自于: Python for Data Analysis: Chapter5, 7, 12 文中实例查看地址:http://nbviewer.jupyter.org/github/RZAmber/for_blog/blob/master/learn_numpy.ipynb 1. Combing and Merging Data Sets 在pandas中,数据可以通过三种方式进…

使用详解_Log4j2使用详解

日志框架简单比较(slf4j、j.u.l、log4j、logback、log4j2 )slf4j:slf4j是对所有日志框架制定的一种规范、标准、接口,并不是一个框架的具体的实现,因为接口并不能独立使用,需要和具体的日志框架实现配合使用…

paddlehub安装及对口罩检测

1、安装 python -m pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple pip install -i https://mirror.baidu.com/pypi/simple paddlehub 报错,解决方案: >pip install -i https://mirror.baidu.com/pypi/simple paddlehub --use…

python实例变量不存在_python – peewee实例匹配查询不存在

我有以下代码,我在查询我的peewee数据库.我在具有term.sets_term_id的行上的for循环中收到错误.这是错误TermsDoesNotExist:实例匹配查询不存在:如果我执行变量(term),则sets_terms_id是一个选项.为什么我会收到该错误以及如何解决? def get_…