转载:https://blog.csdn.net/qq_33934427/article/details/125903960
文章目录
- 1、JavaEE
- 2、网络基础
- 3、Mysql
- 4、Spring/SpringMVC(IOC装配、AOP增强、常用注解)
- 5、Spring Boot/Spring Cloud
- 1)SpringBoot部分
- 2)SpringCloud整体理解
- 3、SpringCloud五大组件
- a)Eureka(服务注册与发现)
- b)Ribbon(不能单独使用)
- c)Feign(配合Ribbon使用)
- d)Hystrix(对RPC调用接口进行过载保护)
- e)Zuul(微服务网关)
- f)五大组件流程图
- g)其他
1、JavaEE
-
【问】J2EE和Java Web的区别,参考J2EE与javaweb的区别
Note:-
J2EE是Java的企业应用开发,涵盖了B/S和C/S(Server服务器),注重的是结构和框架,我们所熟知的struts2、hibernate和spring即ssh就是j2ee的一些基本框架。 -
JavaWeb是指Java在B/S方面的开发,做的是网络应用; -
j2EE和JavaWeb说的是两个层面:javaee是指Java的企业级应用,可以说是一个规范,包含servlet,jsp,jndi,jms,mvc框架,对象持久化等等组件javaweb是指用Java技术来解决相关web互联网领域的技术总和,其中就包含javaee的组件。
-
-
【问】jsp 和 servlet 有什么区别?,参考JSP简单介绍
Note:servlet是服务器端的java程序,是客户端和服务器端的中间层;JSP(Java server pages) 是一种动态网页开发技术,它使用JSP标签在HTML网页中插入Java代码,其本质是一个java servlet;JSP需要通过web容器(比如tomcat)将JSP代码编译成JVM能够识别的Java类(Servlet);JSP有内置对象,而Servlet没有内置对象。- 在
Springboot开发中,也可以使用Thymeleaf模板引擎来显示页面,和JSP不同的是,Thymeleaf是一个纯的html页面,能够像静态的HTML那样以原始的方式编写和预览,并且能够在运行时渲染动态模型数据,而JSP只能在web容器中渲染后运行。参考JSP和Thymeleaf
JSP和Thymeleaf的设计是基于模型-视图-控制器(MVC)模式,它们的缺点是前后端耦合度太高,不利于前后端应用的分离。
-
【问】说一下 jsp 的 4 种作用域?,参考jsp九大内置对象、四种作用域、跳转方式
Note:jsp有四种作用域:page-> 页面级别,显然只有在一个jsp页面内可用。request-> 请求级别,服务器跳转,一次请求之后消失。session-> 会话级别,客户端跳转(服务器跳转),与浏览器有关,ie是在重新打开ie时才会不同(刷新浏览器session域的数据会消失)。application= 应用级别,当重启服务器时才会消失。
-
【问】jsp 有哪些内置对象?作用分别是什么?,参考jsp九大内置对象、四种作用域、跳转方式
Note:内置对象 内容 类型 作用域 request 请求对象(封装请求内容) 类型 javax.servlet.ServletRequest作用域 Request response 响应对象 类型 javax.servlet.ServletResponse作用域 page pageContext 页面上下文对象 类型 javax.servlet.jsp.PageContext作用域 page session 会话对象 类型 javax.servlet.http.HttpSession作用域 session application 应用程序对象 类型 avax.servlet.ServletContext作用域 application out 输出对象 类型 javax.servlet.jsp.JspWriter作用域 page config 配置对象 类型 javax.servlet.ServletConfig作用域 page page 页面对象 类型 javax.lang.Object作用域 page exception 异常对象 类型 javax.lang.Throwable作用域 page - 通过
pageContext可以获取JSP页面的out,request,response,session和application对象; session可以通过ThreadLocal来管理;application实现了用户间数据的共享,可存放全局变量,它开始于服务器启动,直到服务器关闭;page即JSP本身,config可取得服务器的配置信息。
- 通过
-
【问】说一下 session 的工作原理?(客户端
登录会在服务器端生成session,服务端返回数据时将sessionid通过cookies返回给浏览器,用户下次登录时取出cookies中sessionid,到服务器端去匹配,如果不存在则跳转回登录页面) -
【问】session 和 cookie 有什么区别?(位置/容量/类型/有效期/安全),跨域&Cookie&Session
Note:- 1)存储位置不同:
cookie在客户端浏览器;session在服务器; - 2)存储容量不同:
cookie<=4K,一个站点最多保留20个cookie;session没有上线,出于对服务器的保护,session内不可存过多东西,并且要设置session删除机制; - 3)存储方式不同:
cookie只能保存ASCII字符串,并需要通过编码方式存储为Unicode字符或者二进制数据;session中能存储任何类型的数据,包括并不局限于String、integer、list、map等; - 4)隐私策略不同:
cookie对客户端是可见的,不安全;session存储在服务器上,安全; - 5)有效期不同:开发可以通过设置
cookie的属性,达到使cookie长期有效的效果;
session依赖于名为JESSIONID的cookie,而cookie JSESSIONID的过期时间默认为-1,只需关闭窗口该session就会失效,因而session达不到长期有效的效果; - 6)跨域支持上不同:
cookie支持跨域;session不支持跨域;
- 1)存储位置不同:
-
【问】如果客户端禁止 cookie,此时session 还能用吗?(虽然无法将
sessionid通过cookie传给浏览器,但可以通过url重写的方式,将sessionId追加到url尾) -
【问】cookie、session、token的区别?,参考Cookie、Session和Token的区别与联系
Note:cookie和session是混合使用的,session的实现常常依赖于cookie机制,其中cookie和session的区别见上两问解析。session在集群中存在的问题:在分布式系统中,客户端通过cookies中的sessionid,到服务器端去匹配是否有这个人sessionid,由于无法有效统一管理session(不同服务器之间复制所有用户的session开销会很大,单点存储session又不高可用),因此有人提出没必要把所有的sessionId放在一个服务器中,而是通过加密解密的方式来进行身份验证,解密的密钥只有服务器端有,就不存在安全问题,因此就有了token。参考cookie、session与token的真正区别CA数字签名是在服务器端(某网站)和服务器端(CA机构)来发送的,某网站发送公钥给CA机构,CA机构使用私钥对其公钥进行加密,并将消息发送给用户,用户可以使用CA提供的公钥来校验网站CA签名的合法性。Token也是基于签名的,是在服务器端和客户端进行发送的,比如说服务器用HMAC-SHA256算法(信息摘要算法),加上一个密钥(加密算法), 对用户名的数据(比如userId)做一个签名,并**将“数据 + 签名”作为token*保存在客户端的cookies中。
在验证的时候,客户端通过cookies向服务端发送token,服务端会*使用私钥对数据部分进行解密得到新的签名,并与原token中的签名进行比较,如果相等则验证通过,如果不等说明数据已被篡改。参考加密,签名,token解释及场景分析,cookie、session与token的真正区别

-
【问】如何避免 sql 注入?,参考万能密码:‘or 1=1-- 实战SQL注入,秒破后台,MyBatis 框架下 SQL 注入攻击的 3 种方式,真是防不胜防!
Note:-
一般没有进行
SQL语句参数化的登录语句是这样的:
Select * From 用户表 Where UserName=xxx and Password=xxx如果对于上面的
sql,Password如果输入xxx or 1=1就能够查询到数据
Select * From 用户表 Where UserName=xxx and Password=xxx or 1=1 -
mybatis通过#{}预编译可以防止sql注入,而${}只是对sql进行拼接。
-
2、网络基础
-
【问】http 响应码 301 和 302 代表的是什么?有什么区别?(
301和302状态码都表示重定向,301表示永久性重定向(页面域名会发生修改),302表示临时性重定向(页面域名不修改,但内容会修改)),参考永久性重定向&临时性重定向 -
【问】forward 和 redirect 的区别?,参考页面跳转的两种方式(转发和重定向)区别及应用场景分析,重定向和转发的区别
Note:

-
相同点:两者都会实现页面跳转;
-
不同点 :
- url是否改变:
redirect会改变地址栏的url*内容;而*forward不会改变url内容; - 行为不同:
forward是服务器内部行为,而redirect是客户端行为; - 请求次数不同:
forward**是**一次请求过程,而redirect**是**二次请求过程,因此在效率上转发高于重定向 - 语法不同:转发是
request.getRequestDispatcher("xxx.jsp或者servlet").forward(request,response);,重定向是response.sendRedirect("xxx.jsp或者servlet")。 - 安全性不同:
forward是在服务器内部实现跳转,客户端不知道跳转路径,相对来说比较安全;而在redirect中,客户端参与到跳转流程,给攻击者带来了攻击入口,受威胁的可能性较大。
- url是否改变:
-
适合场景 :
-
forward转发 :- 要保持
request域的数据时使用转发; - 若携带较多参数则选择服务器内转发;
- 要保持
-
redirect重定向:- 对于竭力避免表单重复提交的场景下,即对数据进行修改、删除、添加操作的时候选择重定向方式;
- 要访问外站资源的时候用重定向。
-
-
-
【问】简述 tcp 和 udp的区别?(TCP可靠有连接,保证数据正确性、顺序性;UDP不可靠无连接,可能丢数据),参考【计算机网络】传输层知识点总结
-
【问】tcp 在建立连接时为什么要三次握手,两次不行吗?为什么?(
3次握手才能完成ack同步,才能确定服务端已经准备开启连接),参考【计算机网络】传输层知识点总结
Note:- 主要原因是通过三次握手避免打开历史连接请求。如果客户端发送的连接请求在网络中滞留太久,客户端等待一个超时重传时间后,就会重新请求连接。有三次握手,服务器虽然收到了两个连接请求,并回发了两个请求确认,但客户端不会回应前一个请求确认,就不会打开这个失效的链接请求【具体就是通过服务端返回的
ack来验证的,如果客户端发现不是自己期望的ack号,就会发起 RST 报文中止这个失效链接】。 - 通过三次握手同步双方的初始序列号。
- 主要原因是通过三次握手避免打开历史连接请求。如果客户端发送的连接请求在网络中滞留太久,客户端等待一个超时重传时间后,就会重新请求连接。有三次握手,服务器虽然收到了两个连接请求,并回发了两个请求确认,但客户端不会回应前一个请求确认,就不会打开这个失效的链接请求【具体就是通过服务端返回的
-
【问】说一下 tcp 粘包是怎么产生的?(原因是一条消息的边界不确定),可参考什么是TCP粘包?,TCP粘包现象分析及处理方式
Note:-
TCP是面向流的的传输协议,存在粘包问题,发送端可以一次发送不定长度的数据,而接收端也可以一次提取不定长度的数据。即这种传输方式是无保护消息边界的。
UDP是面向数据报的传输协议,不存在粘包问题,发送的UDP报文都被接收端视为一条消息,若消息太长被分片,UDP协议也会完成组合后才呈现在内核缓冲区;且UDP报文有消息头,对于接收端来说,易于区分处理。即这种传输方式是有保护消息边界的。 -
TCP粘包的原因:
- 应用层传到
TCP协议的数据,不是以消息报为单位向目的主机发送,而是以字节流的方式发送到下游,这些数据可能被切割和组装成各种数据包,接收端收到这些数据包后没有正确还原原来的消息,因此出现粘包现象。 - 粘包出现的根本原因是不确定消息的边界。接收端在面对"无边无际"的二进制流的时候,根本不知道收了多少
01才算一个消息。
- 应用层传到
-
粘包的处理方法 :只要在发送端每次发送消息的时候 给消息带上识别消息边界的信息
,接收端就可以根据这些信息识别出消息的边界,从而区分出每个消息。常见的方法有:
- 加入特殊标志:头标志和尾标志
- 加入消息长度信息
-
-
【问】OSI 的七层模型都有哪些?(应用层,表示层,会话层,传输层,网络层,链路层,物理层)
-
【问】get 和 post 请求有哪些区别?(参数位置/长度/安全性/请求次数/编码)
Note:get请求参数是连接在url后面的;而post请求参数是存放在requestbody内的;get请求因为浏览器对url长度有限制,所以参数个数有限制;而post请求参数个数没有限制;- 因为
get请求参数暴露在url上;所以安全方面post比get更加安全; get请求只能进行url编码;而post请求可以支持多种编码方式;get请求参数会保存在浏览器历史记录内;post请求并不会;get请求浏览器会主动cache;post并不会,除非主动设置;get请求产生1个tcp数据包;post请求产生2个tcp数据包;- 浏览器在发送
get请求时会将header和data一起发送给服务器,服务器返回200状态码;而在发送post请求时,会先将header发送给服务器,服务器返回100,之后再将data发送给服务器,服务器返回200状态码;
-
【问】域名解析全过程?(
HOST表或缓存 -> 本地域名服务器 -> 迭代查询根域名服务器(先返回顶级域名服务器,接着返回权限域名服务器,接着返回IP地址))
Note:域名解析过程:(假设域名为www.baidu.com)- 1)先在
HOSTS表或者本地主存中的DNS缓存中查询 - 2)如果没有,再通过递归查询查找本地DNS服务器
- 3)如果还没找到,本地DNS服务器通过迭代查询查找根域名服务器,根域名服务器返回
.com域的顶级域名服务器; - 4)接着本地域名服务器向
.com的顶级域名服务器发出请求,返回baidu.com权限域名服务器; - 5)本地域名服务器向
baidu.com权限域名服务器发送请求,得到了www.baidu.com的IP地址。
- 1)先在
-
【问】Cookie设置域名domain与跨域的问题说明?(协议、域名和端口号都相同才不存在跨域)
Note:-
一个标准的URL格式如下:
协议://主机名.域名.域名后缀或IP地址(:端口号)/目录/文件名。
比如http://www.dailynews.com.cn/channel/welcome.htm中,www为主机名,dailynews为本地域名,com为组织域名,cn为最高层域名(表示中国);
其中dailynews.com.cn的父域名包括com.cn和cn,子域名包括www.dailynews.com.cn。 -
什么是
跨域问题 :
-
跨域是指一个域(网站)下的文档或脚本试图去请求另一个域(网站)下的资源。
-
跨域问题是浏览器为了防御
CSRF攻击 (Cross-site request forgery 跨站请求伪造 )发生,避免恶意攻击而带来的风险而采取的同源策略限制。当一个页面中使用XMLHTTPRequest(XHR请求,也既AJAX请求)对象发送HTTP请求时,必须保证当前页面和请求的对象是同源的,即协议、域名和端口号要完全一致,否则浏览器就会阻止此跨域请求返回的数据。比如:
http://www.a.com与https://www.a.com是不同源的,它们协议不同(跨域)http://www.a.com与http://www.b.com是不同源的,它们域名不同(跨域)http://www.a.com/test1.js与http://www.a.com/test2.js是同源的(不跨域)
-
-
Cookie无法设置除当前域名或者其父域名(向右表示上级)之外的其他domain,这是因为浏览器出于对cookie的保护造成的(同源策略),也就是cookie无法跨域设置。cookies的domain设置规则如下:当前域名只能设置当前域名以及当前域名的父(上级)域名,不能设置当前域名的子(下级)域名。
假设现在有三个域名如下3个域名,一个顶级域名
zydya.com、一个二级域名blog.zyday.com
和一个三级域名one.blog.zyday.com。- 在
zyday.com域名下设置cookie,其他域名下是否会取到cookie;

- 在
blog.zyday.com域名下设置cookie,其他域名下是否会取到cookie;

- 在
one.blog.zyday.com域名下设置cookie,其他域名下是否会取到cookie;

-
-
【问】如何实现跨域?(CORS(前后端设置)/Nginx反向代理/WebSocket),参考什么是跨域?跨域解决方法,面试被问跨域问题,怎么破?
Note:-
跨域主要涉及
4个响应头:
Access-Control-Allow-Origin用于设置允许跨域请求源地址 (预检请求和正式请求在跨域时候都会验证)Access-Control-Allow-Headers跨域允许携带的特殊头信息字段 (只在预检请求验证)Access-Control-Allow-Methods跨域允许的请求方法或者说HTTP动词 (只在预检请求验证)Access-Control-Allow-Credentials是否允许跨域使用cookies,如果要跨域使用cookies,可以添加上此请求响应头,值设为true;
-
方案1:
CORS是跨域资源分享(Cross-Origin Resource Sharing)的缩写。它是 W3C 标准,属于跨源AJAX请求的根本解决方法。-
1)普通跨域请求:只需服务器端设置
Access-Control-Allow-Origin -
2)带
cookie跨域请求 :前后端都需要进行设置-
前端设置:根据
xhr.withCredentials字段判断是否带有cookie,如果是vue则设置为:Vue.http.options.credentials = true;如果是axios则设置为:axios.defaults.withCredentials = true; -
服务器端设置 :服务器端对于
CORS的支持,主要是通过设置Access-Control-Allow-Origin来进行的。如果浏览器检测到相应的设置,就可以允许Ajax进行跨域的访问。java后台实现:
-
-
-
// 允许跨域访问的域名:若有端口需写全(协议+域名+端口),若没有端口末尾不用加'/'response.setHeader("Access-Control-Allow-Origin", "http://www.domain1.com"); // 允许前端带认证cookie:启用此项后,上面的域名不能为'*',必须指定具体的域名,否则浏览器会提示response.setHeader("Access-Control-Allow-Credentials", "true"); // 提示OPTIONS预检时,后端需要设置的两个常用自定义头response.setHeader("Access-Control-Allow-Headers", "Content-Type,X-Requested-With");
-
方案2 :
Nginx反向代理- 使用
nginx反向代理实现跨域,是最简单的跨域方式。只需要修改nginx的配置即可解决跨域问题,支持所有浏览器,支持session,不需要修改任何代码,并且不会影响服务器性能。
- 使用
-
方案3:
WebSocket持久化协议Websocket是HTML5的一个持久化的协议,它实现了浏览器 与 服务器的全双工通信,同时也是跨域的一种解决方案。WebSocket和HTTP都是应用层协议,都基于TCP协议。Websocket只需要要做一个握手的动作,在建立连接之后,双方可以在任意时刻,相互推送信息。
-
方案4 :
JSONP(JSON协议)-
JSONP是服务器与客户端跨源通信的常用方法。最大特点就是简单适用,兼容性好(兼容低版本IE),缺点是只支持get请求,不支持post请求。 -
核心思想 :网页通过添加一个
<script>元素,向服务器请求 JSON 数据,服务器收到请求后,将数据放在一个指定名字的回调函数的参数位置传回来。<script src="http://test.com/data.php?callback=dosomething"></script> // 向服务器test.com发出请求,该请求的查询字符串有一个callback参数,用来指定回调函数的名字// 处理服务器返回回调函数的数据 <script type="text/javascript">function dosomething(res){// 处理获得的数据console.log(res.data)} </script>
-
-
【问】websocket应用的是哪个协议?(HTML5中的持久化协议,属于应用层协议,见上一问)
-
【问】说一下 JSONP 实现原理?(见上2问)
-
【问】什么是 XSS 攻击,如何避免?(和sql注入类似),参考XSS攻击
Note:- XSS(Cross Site Scripting,避免与CSS冲突缩写为XSS)跨站脚本攻击:利用网页开发时留下的漏洞,通过巧妙的方法注入恶意指令代码到网页,在用户浏览器上,在渲染DOM树的时候,执行了不可预期的JS脚本,从而发生了安全问题比如使用户加载并执行攻击者恶意制造的网页程序;
- 基于HTML的XSS避免方法:不用innerHtml,用innerText;对用户的输入进行过滤,如对
& < > " ' /等进行转义;
-
【问】什么是 CSRF 攻击,如何避免?(用户在银行页面上时,
CSRF主要是通过伪造成广告,当用户点击之后,该url会自动携带用户的cookies去访问银行页面;避免方式是:验证HTTP Referer字段 或 在请求地址中添加token并验证),参考CSRF攻击与防御(写得非常好)
3、Mysql
更多内容参考【软考】软件设计师知识点整理中《数据库系统》章节,Mysql初阶易错知识点整理(待更新),MySQL进阶 - 易错知识点整理(待更新)
-
【问】数据库的三范式是什么?,参考数据库的规范理论
Note:- 1NF:表中属性不可分,但表中非主属性存在部分函数依赖;不满足第一范式的数据库模式不能称为关系数据库。
- 2NF:满足1NF,非主属性 完全函数依赖 于候选码;表中非主属性存在传递依赖;
- 3NF:符合2NF,并且消除了非主属性对于候选码的 传递函数依赖。
- 还有BCNF(在3NF基础上消除主属性对码的部分和传递函数依赖),4NF(在BCNF基础上消除非平凡且非函数依赖的多值依赖)
- 目的:尽量消除插入、删除异常,修改复杂,数据冗余;
基本思想:逐步消除数据依赖中不合适的部分
-
【问】一张自增表里面总共有 7 条数据,删除了最后 2 条数据,重启 mysql 数据库,又插入了一条数据,此时 id 是几?
Note:-
表类型是
InnoDB:- 如果不重启,InnoDB会在缓存中通过保存最大的ID(7),插入新数据时ID为8;
- 如果重启,InnoDB保存最大的ID(7)丢失,插入新数据时ID为6
-
表类型是
MyIsAM:重启之后,最大ID也不会丢失,ID是8;主要原因是两类型的存储引擎不同。 -
InnoDB必须有主键(建议使用自增主键,不用UUID,自增主键索引查询效率高)、支持行级锁,事务和外键,有更好的并发能力;MyISAM不支持事务和外键,系统崩溃时很难恢复数据,因此建议使用InnoDB作为表类型。
-
-
【问】如何获取当前数据库版本(mysql则
select version();或mysql -v) -
【问】说一下 ACID 是什么?(原子性/一致性(实时/强一致)/隔离性(不可见)/持久性),参考Mysql四大属性 & 四个隔离级别是如何实现的
-
【问】char 和 varchar 的区别是什么?(
char固定长度,占用空间大但查找效率高;varchar变长),参考MySQL 中 varchar 和 char 区别 -
【问】FLOAT和DOUBLE的区别是什么?(
FLOAT最多存储8位十进制数,共4字节;DOUBLE最多存储18位十进制数,共8字节,参考老马资源) -
【问】mysql 的内连接、左连接、右连接有什么区别?,参考mysql 内连接、自然连接、外连接的区别
Note:- 自然连接(natural join)**是一种特殊的等值连接,在**无需设置条件下,两个表的相同属性列建立连接;
- 内连接(inner join,inner可省略) 基本与自然连接相同,不同之处在于通过设置条件,内连接可以让两个表的不相同的属性列建立连接;
- 左外连接(left outer join,outer可省略),通过设置条件建立两表连接,左表要舍弃的保留在结果集中,右表对应的列上填null;右外连接则相反。
-
【问】mysql 索引是怎么实现的?(
InnoDB存储引擎中,B+树是从二叉查找树,平衡二叉树,B树发展来的),参考MySQL的索引(普通索引、唯一索引,主键索引、组合索引、全文索引、空间索引)相关操作,B+树真的不难,图解 B+树的插入与删除操作
Note:-
B+树基本概念:-
B+树是平衡树(B树),如果每页可存放4条记录,扇出(fan out)为5,可以理解成5阶多叉树。 -
对于数据结构
B+树来说,在插入关键字时,需要注意以下几点:- 插入的操作全部都在叶子结点上进行,且不能破坏关键字自小而大的顺序;
- 由于
B+树中各结点中存储的关键字的个数有明确的范围,做插入操作可能会出现结点中关键字个数超过阶数的情况,此时需要将该结点进行 “分裂”;过程即为依次向上分裂。
-
对于
mysql的B+树非叶子节点上是不存储数据的,仅存储键值,而 B 树(平衡树)节点中不仅存储键值,也会存储数据。
之所以这么做是因为在数据库中页的大小是固定的,InnoDB中页的默认大小是 16KB。如果不存储数据,那么就会存储更多的键值,如果我们的B+树一个节点可以存储 1000 个键值,那么 3 层B+树可以存储 1000×1000×1000=10 亿个数据。
相较于B树B+树空间利用率更高,可减少I/O次数,磁盘读写代价更低。 -
InnoDB中B+树索引的所有数据均存储在叶子节点,而且数据是按照顺序排列的。那么B+树使得范围查找,排序查找,分组查找以及去重查找变得异常简单;InnoDB的B+树索引是聚集索引,即数据和索引在一起; -
MyISAM中的B+树索引实现与InnoDB中的略有不同。在 MyISAM 中,B+树索引的叶子节点并不存储数据,而是存储数据的文件地址,指向了数据行;MyISAM的B+树索引是非聚集索引,即数据和索引分离,在查询时先到内存中找到该索引,接着到磁盘中找到相应数据,较为耗时。
-
-
Hash索引和B+树索引的比较 :-
Hash索引:
- 在查询速度上,如果是等值查询,
Hash索引比B+树索引效率高,时间复杂度O(1);Mysql的Memory存储引擎支持Hash索引; - 如果键值不是唯一(或存在Hash冲突),就需要先找到该键所在位置,然后再根据链表往后扫描,直到找到相应的数据,这时候复杂度会变成
O(n),降低了Hash索引的查找效率。
Hash 索引通常不会用到重复值多的列上,比如列为性别、年龄的情况等;当然B+ tree索引也不适合这种离散型低的字段上。
- 在查询速度上,如果是等值查询,
-
B+树索引:
- Hash索引是无序的,如果是范围查询检索,这时候 Hash 索引就无法起到作用;
- 1)Hash 索引只支持等值比较查询、无法支持范围查询检索,
B+tree索引的叶子节点形成有序链表,便于范围查询。 - 2)Hash 索引无法做
like ‘xxx%’这样的部分模糊查询,因为需要对完整 key 做 Hash 计算,定位bucket。而B+ tree索引具有最左前缀匹配,可以进行部分模糊查询。 - 3)Hash索引中存放的是经过Hash计算之后的Hash值,而且Hash值的大小关系并不一定和Hash运算前的键值完全一样,所以数据库无法利用索引的数据来避免任何排序运算。
B+tree索引的叶子节点形成有序链表,可用于排序。 - 4)Hash 索引不支持多列联合索引,对于联合索引来说,Hash 索引在计算 Hash 值的时候是将索引键合并后再一起计算 Hash 值,不会针对每个索引单独计算 Hash 值。因此如果用到联合索引的一个或者几个索引时,联合索引无法被利用;
- 5)因为存在哈希碰撞问题,在有大量重复键值情况下,哈希索引的效率极低。
B+tree所有查询都要找到叶子节点,性能稳定;
-
-
应用场景:
- 1)大多数场景下,都会有组合查询,范围查询、排序、分组、模糊查询等查询特征,Hash 索引无法满足要求,建议数据库使用
B+树索引。 - 2)在离散型高,数据基数大且等值查询时候,Hash索引有优势。
- 1)大多数场景下,都会有组合查询,范围查询、排序、分组、模糊查询等查询特征,Hash 索引无法满足要求,建议数据库使用
-
-
【问】什么是聚簇索引和非聚簇索引?(数据和索引是否分离;聚簇索引包括整条数据,而非聚集索引包含的是数据行地址,搜索效率较低;参考上一问和下一问)
-
【问】B+树在满足聚簇索引时,是否需要回表查询数据(聚簇索引包含整行数据,不需要回表查询,参考老马资源)
Note:- 在
B+树的索引中,叶子节点可能存储了当前的key值,也可能存储了当前的key值以及整行的数据,这就是聚簇索引和非聚簇索引。 - 在
InnoDB中,只有主键索引是聚簇索引,如果没有主键,则挑选一个唯一键建立聚簇索引。如果没有唯一键,则隐式的生成一个键来建立聚簇索引。 - 当查询使用聚簇索引时,在对应的叶子节点,可以获取到整行数据,因此不用再次进行回表查询。
- 在
-
【问】非聚簇索引一定会回表查询吗?(不一定,看要查询字段是否包含在索引中,比如
行select age from employee where age < 20就不用回表,参考老马资源) -
【问】数据库为什么不用红黑树而用B+树?(B+树多叉,红黑树二叉)
Note:- 红黑树是二叉树,树高最高不会超过 2 ∗ l o g ( n ) 2log(n)2∗log*(n),因此查找的时间复杂度为O ( l o g ( n ) ) O(log(n))O(log(n)),但是在数据量非常大时,需要访问节点数还是会比较多,而
B+树是多叉的,可以有效减少磁盘IO次数;
- 红黑树是二叉树,树高最高不会超过 2 ∗ l o g ( n ) 2log(n)2∗log*(n),因此查找的时间复杂度为O ( l o g ( n ) ) O(log(n))O(log(n)),但是在数据量非常大时,需要访问节点数还是会比较多,而
-
【问】说一下 mysql 的行锁和表锁?(行锁和表锁都是悲观锁,粒度不同),参考MySQL之行锁与表锁
Note:-
按照锁的性质可以把锁分为共享锁(S读锁)和排它锁(X写锁)
- 若事务T给表/行加了S锁,则其他事务可以获取该表/行的S锁,但不能加X锁;
- 若事务T给表/行加了X锁,则其他事务对该表/行不能加S锁或X锁
-
innodb表锁:- 在执行insert、select、delete、update语句时,并不会对该表添加表级S锁或X锁。
Innodb的表级锁一般不会用到,只会在特殊情况下,例如系统崩溃恢复时使用,在autocommit = 0、innodbc_table_locks = 1的情况下,可通过 下面的语句手动获取表级别的S锁和X锁:
lock tables t read:对表t加S锁
lock tables t write:对表t加X锁
-
innodb行锁:Record lock:Record Lock也称行锁,官方称之为LOCK_REC_NOT_GAP,仅仅锁一条记录;行锁也有S锁和X锁之分,一条记录的S锁如果被获取,那么其他事务依然可以继续获取该记录的S锁,但是不可以获取X锁;Gap lock:间隙锁,锁定一个范围,不包括记录本身;可以解决幻读问题。
例如事务B想插入一个ID为4的记录,先定位到4的下一条记录的位置,此时定位到8,发现8上面有一个Gap Lock,那么事务B就会阻塞至8的Gap Lock释放之后,才可以将新记录插入进去。Next-key lock:record+gap 锁定一个范围,包含记录本身;
-
-
【问】说一下乐观锁和悲观锁?(乐观锁即不加锁,通过带版本号的CAS算法 - 旧值A、修改值B、当前内存值V来实现;悲观锁通过行锁和表锁实现),可参考乐观锁之CAS算法,MySQL之行锁与表锁
-
【问】说一下数据库的事务隔离?(读提交/读未提交/可重复读/串行化),参考Mysql的四个隔离级别是如何实现的
Note:-
读未提交(
RU):三个问题都不可以解决- 所有的读不加锁,读到的数据都是最新的数据,性能最好。
- 所有的写加行级锁,写完释放。
-
读已提交(
RC使用MVVC技术实现) :可以解决脏读;- 写操作:加行级锁。事务开始后,会在UNDO日志中写入修改记录,数据行中的隐藏列DATA_POLL_PTR存储指向该行的UNDO记录的指针。
- 读操作:不加锁。在读取时,如果该行被其它事务锁定,则顺着隐藏列DATA_POLL_PTR指针,找到上一个有效的历史记录(有效的记录:该记录对当前事务可见,且DELETE_BIT=0)。
-
可重复读(
RR) :可以解决脏读和可重复读;- 写操作:加行级锁;读操作:不加锁;
RR读写操作和加锁逻辑和RC相同,都是使用MVVC(多版本并发控制) 技术实现- 不同点在于:行记录对于当前事务的可见性(可见性:即哪个版本的行记录对这个事务是可见的)。RC级别对数据的可见性是该数据的最新记录,RR级别对数据的可见性是事务开始时,该数据的记录。
-
串行化:可以解决幻读(设置读锁(共享锁)和写锁);
-
-
【问】说一下 mysql 常用的引擎?(
InnoDB和MyIsAM,见第二问) -
【问】在mysql子查询中,
in和exists有什么区别(exists不一定比in快,但not exists都比not in快,参考老马资源),可参考MySQL使用IN、EXISTS、ANY、ALL关键字的子查询
Note:-
mysql中的in语句是把外表和内表(子查询子表) 作hash 连接,而exists语句是对外表作loop循环,每次loop循环再对内表进行查询。 -
只有子查询返回的结果列包含一个值时,比较运算符才适用。假如一个子查询返回的结果集是值的列表,这时比较运算符就必须用
IN运算符代替。// 查询出研发部(dept为'dev')和人力资源部(dept为'hr')的员工列表 select id, dept, name, post from employee where dept in ('dev', 'hr'); -
用
EXISTS关键字时,内层查询语句不返回查询的记录。而是返回一个真假值。如果内层查询语句查询到满足条件的记录,就返回true,否则false。//找出所有其所在部门没有助理(post 为 assistant)的员工信息,使用exists实现 select id, name, dept from employee as o where not exists(select * from employee as i where o.dept = i.dept and post='assistant'); -
1)如果查询的两个表大小相当,那么用
in和exists差别不大。
2)如果两个表中一个较小,一个是大表,则子查询表大的用exists,子查询表小的用in。
3)not in和not exists:如果查询语句使用了not in,那么内外表都进行全表扫描,没有用到索引;而not extsts的子查询依然能用到表上的索引。所以无论那个表大,用not exists都比not in要快。
-
-
【问】如何定位及优化SQL语句的性能问题(
Explain + select语句显示了mysql如何使用索引来处理select语句以及连接表;可以在慢查询日志中查看执行时间超过long_query_time秒的sql并对其优化,参考老马资源),可参考MYSQL explain详解,MySQL 数据库管理之 — 日志查询
Note:- 执行计划包含的信息
id有一组数字组成。表示一个查询中各个子查询的执行顺序;- id相同执行顺序由上至下;id不同,id值越大优先级越高,越先被执行;
select_type为每个子查询的查询类型,一些常见的查询类型如下:
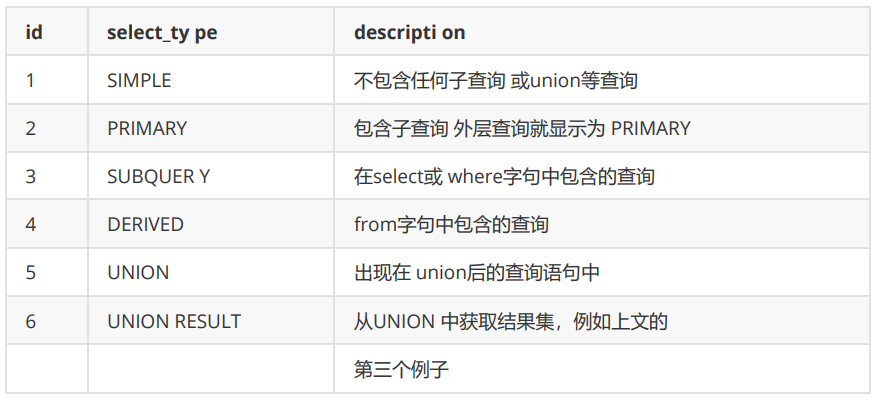
type(非常重要,可以看到有没有走索引) 访问类型:ALL扫描全表数据index遍历索引 (索引文件全扫描)range索引范围查找index_subquery在子查询中使用refunique_subquery在子查询中使用eq_refref_or_null对Null进行索引的优化的ref fulltext使用全文索引ref使用非唯一索引(普通索引)查找数据
extra的信息非常丰富,常见的有:- Using index 使用覆盖索引
- Using where 使用了用where子句来过滤结果集
- Using filesort 使用文件排序,使用非索引列进行排序时出现,非常消耗性能,尽量优化。
- Using temporary 使用了临时表
- SQL性能优化的目标:至少要达到
range级别,要求是ref级别,如果可以是consts则更好。 说明:- 1)
consts单表中最多只有一个匹配行(主键或者唯一索引),在优化阶段即可读取到数据。 - 2)
ref指的是使用普通的索引(normal index,非唯一索引)。 - 3)
range对索引进行范围检索。 如果explain表的结果type=index表示遍历索引,索引物理文件全扫描,速度非常慢,这个index级别比较range还低,与全表扫描相差无几。
- 1)
- 执行计划包含的信息
-
【问】如何做 mysql 的性能优化?(用具体字段替代
*;where中避免用or,or不走索引,可用in代替;where中使用默认值代替null,因为null不走索引;在联合索引中,全值匹配会自动用到mysql优化器,最左连续匹配),可参考MySQL性能优化的9种方法,SQL优化 21 连击 + 思维导图,Mysql最左匹配原则 -
【问】讲一讲你的SQL优化经历(先建立单列索引,如果单列索引粒度较粗,过滤后的数据行还很多,可以使用多列联合索引),可参考一次非常有意思的 SQL 优化经历:从 30248.271s 到 0.001s
Note:sql调优总结(参考上面链接做的实验进行理解)-
列类型尽量定义成数值类型,且长度尽可能短,如主键和外键,类型字段等等
-
建立单列索引,根据需要建立多列联合索引
- 当单个列过滤之后还有很多数据,那么索引的效率将会比较低,即列的区分度较低,那么如果在多个列上建立索引,那么多个列的区分度就大多了,将会有显著的效率提高。
-
根据业务场景建立覆盖索引:只查询业务需要的字段,如果这些字段被索引覆盖,将极大的提高查询效率。
-
多表连接的字段上需要建立索引,这样可以极大的提高表连接的效率
-
where条件字段上需要建立索引 -
排序字段上需要建立索引,可以提高排序效率
-
分组字段上需要建立索引
-
Where条件上不要使用运算函数,以免索引失效
-
-
【问】MySQL 上亿大表如何优化?(可以使用
pt-query-digest工具分析最近一周的mysql-slow.log,查看存在哪些慢查询(其中不乏使用了索引的),进而对索引进行优化),可参考MySQL 上亿大表如何优化? -
【问】mysql中
select......for update是锁表还是锁行?(select不会加锁,但对于带更新操作的select......for update会加悲观锁(写锁))
Note:- 如果使用主键id = 1为条件去
select ... for update,然后开启另一个事务也去updateid=1的数据,会发现第二个事务更新被阻塞;
如果开启另一个事务也去update主键id=2的数据,会发现事务顺利执行;
因此select ... for update在查询id=1时使用了行锁; - 如果使用普通字段code去操作,一个事务
select * from user where code = 001 for update,另一个事务update user set age = 10 where code = 003,发现第二个事务更新被阻塞;
因此select ... for update在查询code时对整张表上了锁(表锁); - 因此
select......for update没用索引/主键的话就是表锁,用索引或主键则是行锁
- 如果使用主键id = 1为条件去
-
【问】什么是分库分表?(如果上面的sql优化后效果不是很好,水平分/垂直分库/表),参考不用找了,大厂在用的分库分表方案,都在这了
Note:-
数据库瓶颈:不管是IO瓶颈,还是CPU瓶颈,最终都会导致数据库的活跃连接数增加 ,进而逼近甚至达到数据库可承载活跃连接数的阈值,可用数据库连接少甚至无连接可用,并发量、吞吐量低,系统崩溃。
-
IO瓶颈 :
- 第一种:磁盘读IO瓶颈,热点数据太多,数据库缓存放不下,每次查询时会产生大量的IO,降低查询速度 -> 分库和垂直分表 。
- 第二种:网络IO瓶颈,请求的数据太多,网络带宽不够 -> 分库 。
-
CPU瓶颈 :
- 第一种:
SQL问题导致的查询效率低,可进行SQL语句优化; - 第二种:单表数据量太大,查询时扫描的行太多,
SQL效率低,CPU率先出现瓶颈 -> 水平分表。
- 第一种:
-
-
水平分库分表 :横向切,按行抽离出数据。
-
水平分库:库多了,
io和
cpu的压力自然可以成倍缓解(数据库连接池)。
- 1)以字段为依据,按照一定策略(
hash、range等),将一个库中的数据拆分到多个库中。 - 2)每个库的结构都一样,但不同库中的数据没有交集,所有库的并集是全量数据;
- 1)以字段为依据,按照一定策略(
-
水平分表
:表的数据量少了,
单次SQL执行效率高
,自然减轻了CPU的负担。
- 概念和分表结果和水平分库相同(上面的“库”改为“表”即可)
-
-
垂直分库分表
:纵向切,
按业务抽离
出表或字段。
-
垂直分库
:随着的
业务的拓展
,之前库中的
配置表,字典表
可以抽象到更高一层进行服务化。
-
1)以表为依据,按照业务归属不同,将不同的表拆分到不同的库中。
-
2)每个库的结构都不一样,不同库中的数据没有交集,所有库的并集是全量数据;
-
3)
使用场景
:
- 随着业务的发展一些公用的配置表、字典表等越来越多,这时可以将这些表拆到单独的库中,甚至可以服务化。
- 再有,随着业务的发展孵化出了一套业务模式,这时可以将相关的表拆到单独的库中,甚至可以服务化。
-
-
垂直分表
:随着的
需求的细化
,比如用户经常看到
列表页
而非
详情页
,所以可将两者抽离出来,
符合数据库规范理论
。
-
1)以字段为依据,按照字段的活跃性,将表中字段拆到不同的表 (主表和扩展表)中。
-
2)每个表的结构都不一样;每个表的数据也不一样,一般来说,每个表的字段至少有一列交集,一般是主键,用于关联数据;所有表的并集是全量数据;
-
3)
使用场景
:
- 可以用列表页和详情页来帮助理解。垂直分表的拆分原则是将热点数据(可能在一起查询时经常存在冗余的数据)放在一起作为主表,非热点数据放在一起作为扩展表。
- 这样更多的热点数据就能被缓存下来,进而减少了随机读
IO。拆了之后,要想获得全部数据就需要关联两个表来取数据。关联数据,应该在业务Service层做文章(不要使用join,或者说没必要),分别获取主表和扩展表数据然后用关联字段关联得到全部数据。
-
-
-
分库分表工具
:
sharding-sphere:jar,前身是sharding-jdbc;TDDL:jar,Taobao Distribute Data Layer;Mycat:中间件。
-
分库分表步骤:
根据容量(当前容量和增长量)评估分库或分表个数 -> 选key(均匀)-> 分表规则(hash或range等)-> 执行(一般双写)-> 扩容问题(尽量减少数据的移动)。 -
分库分表总结
:
- 1)分库分表,首先得知道瓶颈在哪里,然后才能合理地拆分(分库还是分表?水平还是垂直?分几个?)。且不可为了分库分表而拆分。
- 2)选
key很重要,既要考虑到拆分均匀(常用hash),也要考虑到非partition key的查询。 - 3)只要能满足需求,拆分规则越简单越好。
-
-
【问】分库分表之后,id 主键如何处理?(snowflake 分布式id算法,提供 64 位的
long型的id:41bit表示的是时间戳,10bit记录工作机器 id,12bit用来记录同一个毫秒内产生的不同id;mongoDB id也用到类似思想),参考分库分表之后,id 主键如何处理?,分布式 ID(雪花算法,mongoDB id) -
【问】分库分表具体如何操作?
-
【问】分库分表后,数据库数据一致性问题如何解决?(分布式事务),参考 分库分表后,数据库数据一致性问题如何解决?
Note:- 通过对数据的垂直拆分或水平拆分后,我们解决了数据库容量、性能等问题,但是将会面临数据迁移和数据一致性的问题。
- 在数据迁移方面,需要考虑如何快速迁移、平滑迁移、不停机的迁移等。待数据迁移完毕后,还需要校验数据的完整性。可以采用的方法:
binlog + 全量(停机) + 增量 - 数据一致性方面,要根据的业务来判断是否要必要引入分布式事务,如果需要引入分布式事务,需要斟酌是采用
XA,还是基于BASE的柔性事务
-
【问】什么是mysql的预编译,参考预编译语句(Prepared Statements)介绍,以MySQL为例
Note:-
编译sql语句:通过
PREPARE stmt_name FROM preparable_stm的语法来预编译一条sql语句mysql> prepare ins from 'insert into t select ?,?'; Query OK, 0 rows affected (0.00 sec) Statement prepared 123 -
执行sql语句:通过
EXECUTE stmt_name [USING @var_name [, @var_name] ...]的语法来执行预编译语句mysql> set @a=999,@b='hello'; Query OK, 0 rows affected (0.00 sec)mysql> execute ins using @a,@b; Query OK, 1 row affected (0.01 sec) Records: 1 Duplicates: 0 Warnings: 0mysql> select * from t; +------+-------+ | a | b | +------+-------+ | 999 | hello | +------+-------+ 1 row in set (0.00 sec) 1234567891011121314 -
预编译语句不使用可以释放掉:要释放一条预编译语句,则可以使用
{DEALLOCATE | DROP} PREPARE stmt_name的语法进行操作:mysql> deallocate prepare ins; Query OK, 0 rows affected (0.00 sec) 12
-
4、Spring/SpringMVC(IOC装配、AOP增强、常用注解)
参考Spring常见面试题总结(超详细回答),SpringMVC常见面试题总结(超详细回答),Spring 中文文档 3.1
在学习这一章节前,为了更好地理解IoC和DI,强烈建议先熟悉一下创建型设计模式(单例,静态工厂,抽象工厂,生成器和原型),参考创建型设计模式
-
【问】什么是 Spring 框架?Spring 框架有哪些主要模块?(Context/CORE/AOP/Web/MVC/ORM/DAO)
Note:-
Spring是一个
轻量级的
IoC和AOP容器框架。是为
Java应用程序提供基础性服务的一套框架,目的是用于简化企业应用程序的开发,它使得开发者只需要关心业务需求。主要包括以下
七个模块
:
Spring Context:Spring上下文提供框架式的Bean访问方式,以及企业级功能(JNDI、定时任务等);Spring Core:Spring核心类库,所有功能都依赖于该类库,提供IOC和DI服务;Spring AOP:AOP允许将一些通用任务,如安全、事务、日志等进行集中式处理,从而提高了程序的复用性;Spring Web:提供了基本的面向Web的综合特性,提供对常见框架如Struts2的支持,Spring能够管理这些框架,将Spring的资源注入给框架,也能在这些框架的前后插入拦截器;Spring MVC:提供面向Web应用的Model-View-Controller,即MVC实现。Spring ORM:对现有的ORM框架(hibernate,mybatis)的支持;Spring DAO:对JDBC的抽象封装,简化了数据访问异常的处理,并能统一管理JDBC事务;
-
-
【问】Spring常用注解?(SpringMVC的见下一问),参考Spring常用注解(绝对经典),精讲Spring—Spring常用注解【经典总结】,java注解原理:反射 & 动态代理
Note:-
1)组件类注解:
-
@Component:泛指各种组件,用于标注一个普通的spring Bean类,@Component可以代替@Repository、@Service、@Controller,@Configration等,因为这三个注解是被@Component标注的。但使用具体的注解会携带更多语义,并且便于开发和维护。 -
@Controller、
@Service、
@Repository都可以称为
@Component。
@Controller:标注一个控制器组件类。@Service:标注一个业务逻辑组件类。@Repository:标注一个DAO组件类。
-
被注解的
java类当做Bean实例(默认单例),Bean实例的名称默认是Bean类的首字母小写,其他部分不变。 -
指定了某些类可作为
Spring Bean类使用后,最好还需要让spring搜索指定路径,在Spring配置文件加入如下配置:
<!-- 自动扫描指定包及其子包下的所有Bean类 --><context:component-scan base-package="org.springframework.*"/> 12 -
-
2)装配(注入)Spring bean的注解:
-
@Autowired:属于Spring的org.springframework.beans.factory.annotation包下,可用于为类的属性、构造器、方法进行注值;有个属性为required,可以配置为false;只按照Type注入;
@Resource:不属于spring的注解,而是来自于JSR-250位于java.annotation包下;@Resource默认按Name自动注入,也提供按照Type注入。
@PostConstruct和@PreDestroy方法 实现初始化和销毁bean之前进行的操作。 -
@Autowired和
@Resource的区别:
@Autowired注解默认按照类型装配,如果容器中包含多个同一类型的Bean,那么启动容器时会报找不到指定类型bean的异常,解决办法是结合@Qualifier注解进行限定@Resource注解的使用性更为灵活,可指定名称,也可以指定类型 。
-
-
3) JSON序列化:
@JsonIgnore在json序列化时将java bean中的一些属性忽略掉,序列化和反序列化都受影响;一般标记在属性或者方法上,返回的json数据即不包含该属性。在和fastjson一起使用时可能会存在注解失效的问题。 -
4)Java配置类相关注解
-
@Bean注解主要用于方法上,有点类似于工厂方法,当使用了@Bean注解,我们可以连续使用多种定义bean时用到的注解:譬如用@Qualifier注解定义工厂方法的名称,用@Scope注解定义该bean的作用域范围(譬如是singleton还是prototype等)。 -
使用
@Configuration来注解类 表示
类可以被
Spring的IoC容器所使用,作为
bean定义的资源。
@Target({ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) @Documented @Component //看这里!!! public @interface Configuration {String value() default ""; } 1234567 -
在配置
@Configuration时,并不能用
@Component替代,原因如下:
//配置方法1 @Configuration public static class Config {@Beanpublic SimpleBean simpleBean() {return new SimpleBean();}@Beanpublic SimpleBeanConsumer simpleBeanConsumer() {return new SimpleBeanConsumer(simpleBean());} }//配置方法2 @Component public static class Config {@Beanpublic SimpleBean simpleBean() {return new SimpleBean();}@Beanpublic SimpleBeanConsumer simpleBeanConsumer() {return new SimpleBeanConsumer(simpleBean());} } 1234567891011121314151617181920212223242526272829 -
第一个代码正常工作,正如预期的那样,
SimpleBeanConsumer将会得到一个单例SimpleBean的链接。 -
第二个配置是完全错误的(不能用
@Component,不能被Spring IoC容器使用),因为Spring会创建一个SimpleBean的单例bean,但是SimpleBeanConsumer将获得另一个SimpleBean实例(也就是相当于直接调用new SimpleBean(),这个bean是不归Spring管理的),既new SimpleBean()实例是Spring上下文控件之外的。
-
-
5)切面(AOP)相关注解:参考@Pointcut 注解的使用
Spring支持AspectJ的注解式切面编程:-
Advice(通知、切面): 某个连接点
JointPoint所采用的处理逻辑,也就是向连接点注入的代码, AOP在特定的切入点上执行的增强处理。
1)@Before: 标识一个前置增强方法,相当于BeforeAdvice的功能.
2)@After: final增强,不管是抛出异常或者正常退出都会执行.
3)@AfterReturning: 后置增强,似于AfterReturningAdvice, 方法正常退出时执行。
4)@AfterThrowing: 异常抛出增强,相当于ThrowsAdvice.
5)@Around: 环绕增强,相当于MethodInterceptor。 -
JointPoint(连接点):程序运行中的某个阶段点,比如方法的调用、异常的抛出等。 -
Pointcut(切入点):
JoinPoint的集合,是程序中
需要注入
Advice的位置的集合,
指明
Advice要在什么样的条件下才能被触发,在程序中主要体现为:表示式(expression)和签名(signature)。
//Pointcut表示式 @Pointcut("execution(* com.savage.aop.MessageSender.*(..))") //Point签名 private void log(){} 1234 -
Advisor(增强): 是PointCut和Advice的综合体,完整描述了一个advice将会在pointcut所定义的位置被触发。 -
@Aspect(切面): 通常是一个类的注解,里面可以定义切入点Pointcut和通知Advice。
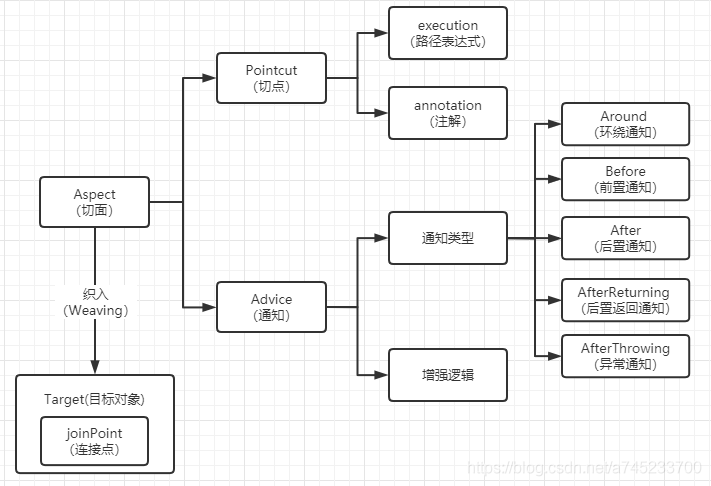
在
java配置类中使用@EnableAspectJAutoProxy注解开启Spring对AspectJ代理的支持。 -
-
6)异步相关:
@EnableAsync:配置类中通过此注解开启对异步任务的支持;@Async:在实际执行的bean方法上使用该注解来声明其是一个异步任务(方法上或类上所有的方法都将异步,需要@EnableAsync开启异步任务)
-
7)
Enable***注解说明:主要是用来开启对xxx的支持:@EnableAspectAutoProxy:开启对AspectJ自动代理的支持;@EnableAsync:开启异步方法的支持;@EnableScheduling:开启计划任务的支持;@EnableWebMvc:开启web MVC的配置支持;
@EnableConfigurationProperties:开启对@ConfigurationProperties注解配置Bean的支持;
@EnableJpaRepositories:开启对SpringData JPA Repository的支持;
@EnableTransactionManagement:开启注解式事务的支持;
@EnableCaching:开启注解式的缓存支持;
-
-
【问】SpringMVC常用注解?,参考Spring常用注解(绝对经典),精讲Spring—Spring常用注解【经典总结】,SpringMVC常见面试题总结(超详细回答)
Note:-
1)
web模块常用到的注解:
-
@Controller:表明该类会作为与前端作交互的控制层组件,通过服务接口定义的提供访问应用程序的一种行为,解释用户的输入,将其转换成一个模型然后将视图呈献给用户。 -
@Controller定义的控制器,还允许自动检测定义在
类路径下的组件
(配置文件中配置扫描路径)并
自动注册
。
@RequestMapping: 这个注解用于将url映射到整个处理类或者特定的处理请求的方法。@RequestParam:将请求的参数绑定到方法中的参数上,有required参数,默认情况下,required=true,也就是该参数必须要传。如果该参数可以传可不传,可以配置required=false。@PathVariable: 该注解用于修饰方法参数,会将修饰的方法参数变为可供使用的uri变量(可用于动态绑定)。@RequestBody:@RequestBody是指方法参数应该被绑定到HTTP请求Body上。@ResponseBody:@ResponseBody用于修饰方法返回值,其作用是将返回类型直接输入到HTTP response body中。@ResponseBody在输出JSON格式的数据时,会经常用到;如果不用则返回字符串数据。
-
@RestController:与
@Controller类似,控制器实现了REST的API,
只为服务于JSON,XML或其它自定义的类型内容
,
@RestController用来
创建REST类型的控制器
,可以避免你重复的写
@Controller与
@ResponseBody。
//@Controller
//@ResponseBody
@RestController
@RequestMapping("/hello")
public class HelloController {@RequestMapping(value = "/happy", method =RequestMethod.POST)String helloWorld() {    return "Hello World";//返回String类型}@RequestMapping(value="/happy/{dayid}",method=RequestMethod.GET)public String findPet(@PathVariable String dayid, Model mode) {//使用@PathVariable注解绑定 {dayid} 到String dayid}@RequestMapping(value = "/something", method = RequestMethod.PUT)public void handle(@RequestBody String body,@RequestBody User user){//可以绑定自定义的对象类型}
}
123456789101112131415161718
-
-
2)Spring事务模块注解
-
在处理
dao层或
service层的事务操作时,譬如删除失败时的回滚操作。使用
@Transactional作为注解,但是需要在配置文件激活
	<!-- 开启注解方式声明事务 -->
<tx:annotation-driven transaction-manager="transactionManager" />
12
代码如下:
@Service public class CompanyServiceImpl implements CompanyService {@Autowiredprivate CompanyDAO companyDAO;@Transactional(propagation = Propagation.REQUIRED, readOnly = false, rollbackFor = Exception.class)public int deleteByName(String name) {int result = companyDAO.deleteByName(name);return result;}... } 12345678910111213 -
其中事务的
传播机制
和
隔离机制
比较重要!
- 事务传播行为类型包括:
PROPAGATION_REQUIRED,PROPAGATION_SUPPORTS等 - 事务的隔离机制包括:
DEFAULT,READ_UNCOMMITTED,READ_COMMITTED,REPEATABLE_READ,SERIALIZABLE串行化。
- 事务传播行为类型包括:
-
-
-
【问】使用 Spring 框架能带来哪些好处?(7大模块),参考Spring常见面试题总结(超详细回答)
Note:- 1)
Spring属于低侵入式设计,代码的污染极低(即Spring代码基本符合设计模式中的6大基本原则); - 2)
spring通过IoC容器中的DI机制将对象之间的依赖关系交由框架处理,降低组件的耦合性; - 3)提供对
AOP的支持,它允许将一些通用任务,如安全、事务、日志等进行集中式处理,从而提高了程序的复用性; - 4)
Spring4提供Junit4的支持,可以通过注解方便测试spring程序; - 5)方便集成各种优秀框架,如Struts、hibernate、mybstis;
- 6)支持声明式事务处理(
@Transactional,只需通过配置就可以完成对事务的管理。
- 1)
-
【问】什么是控制反转(IoC)?什么是依赖注入(DI)?(Spring IoC容器控制对象的生命周期(并非对象托管),反射实现DI,参考老马资源),参考Spring常见面试题总结(超详细回答),阿里云面试:Spring 中 Bean 的生命周期是怎样的?
Note:-
IOC(Inversion of Control,控制反转),指将对象的控制权转移给Spring框架。以前是由自己控制它所引用对象的生命周期,而在IoC中Spring容器来负责控制对象的生命周期(比如创建、销毁)和对象间的依赖关系。由Spring容器帮我们创建、查找及注入依赖对象,而引用对象只是被动的接受依赖对象,所以这叫控制反转。 -
IoC的一个重点就是在程序运行时,动态的向某个对象提供它所需要的其他对象,这一点是由DI(Dependency Injection,依赖注入)来实现的,即应用程序在运行时依赖IoC容器来动态注入对象所需要的外部依赖(依赖是指对象间的关联关系,比如聚合/组合/继承)。而Spring的DI具体就是通过反射实现注入的。 -
IoC容器提供哪些Bean管理功能:Spring通过一个配置文件描述Bean及Bean之间的依赖关系,利用Java语言的反射功能实例化Bean并建立Bean之间的依赖关系。Spring的IoC容器在完成这些底层工作的基础上,还提供了Bean实例缓存、生命周期管理、 Bean 实例代理、事件发布、资源装载等高级服务。 -
IoC容器如何获取
Bean之间的依赖关系:Spring启动时读取应用程序提供的Bean配置信息,并在Spring容器中生成一份相应的Bean配置注册表BeanDefinitionRegistry,然后根据这张注册表实例化Bean,装配好Bean之间的依赖关系,为上层应用提供准备就绪的运行环境。其中Bean缓存池由HashMap实现。
-
-
【问】请解释下 Spring 框架中的 IoC?(IoC 容器实现 参考老马资源)
Note:ApplicationContext的继承体系图如下:参考ApplicationContext继承关系解析

BeanDefinitionRegistry注册表:Spring配置文件中每一个节点元素在Spring容器里都通过一个BeanDefinition对象表示,它描述了Bean的配置信息。而BeanDefinitionRegistry接口提供了向容器手工注册BeanDefinition对象的方法。BeanFactory顶层接口:位于类结构树的顶端 ,它最主要的方法就是getBean(String beanName),该方法从容器中返回特定名称的Bean,BeanFactory的功能通过其他的接口得到不断扩展。ListableBeanFactory:该接口定义了访问容器中Bean基本信息的若干方法,如查看Bean的个数、获取某一类型Bean的配置名、查看容器中是否包括某一Bean等方法;HierarchicalBeanFactory父子级联:父子级联IoC容器的接口,子容器可以通过接口方法访问父容器; 通过HierarchicalBeanFactory接口,Spring的IoC容器可以建立父子层级关联的容器体系,子容器可以访问父容器中的Bean,但父容器不能访问子容器的 Bean。
Spring使用父子容器实现了很多功能,比如在Spring MVC中,表现层Bean位于一个子容器中,而业务层和持久层的Bean位于父容器中。这样,表现层Bean就可以引用业务层和持久层的Bean,而业务层和持久层的Bean则看不到表现层的Bean。ConfigurableBeanFactory是一个重要的接口,增强了IoC容器的可定制性,它定义了设置类装载器、属性编辑器、容器初始化后置处理器等方法;AutowireCapableBeanFactory自动装配:定义了将容器中的 Bean 按某种规则(如按名字name匹配、按类型type匹配等,使用到了@Autowired或@Resource)进行自动装配的方法;SingletonBeanRegistry运行期间注册单例Bean:定义了允许在运行期间向容器注册单实例Bean的方法;对于单实例(singleton)的 Bean 来说,BeanFactory会缓存Bean实例,所以第二次使用getBean()获取Bean时将直接从 IoC 容器的缓存中获取 Bean 实例。Spring 在DefaultSingletonBeanRegistry类中提供了一个用于缓存单实例Bean的缓存器,它是一个用HashMap实现的缓存器,单实例的Bean以beanName为键保存在这个HashMap中。- 依赖日志框:在初始化
BeanFactory时,必须为其提供一种日志框架,比如使用Log4J, 即在类路径下提供Log4J配置文件,这样启动 Spring 容器才不会报错。 ApplicationContext面向开发应用:ApplicationContext由BeanFactory派 生而来 , 提供了更多面向实际应用的功能 。
ApplicationContext继承了HierarchicalBeanFactory和ListableBeanFactory接口,在此基础上,还通过多个其他的接口扩展了BeanFactory的功能。
-
【问】BeanFactory 和 ApplicationContext 有什么区别?(开发时用ApplicationContext作为IoC容器),参考Spring常见面试题总结(超详细回答)
Note:-
BeanFactory和
ApplicationContext是
Spring的两大核心
接口
,
都可以当做Spring的容器
。
-
1)
BeanFactory是Spring里面最底层的接口,是IoC的核心,定义了IoC的基本功能,包含了各种Bean的定义、加载、实例化,依赖注入和生命周期管理。 -
2)
ApplicationContext接口作为
BeanFactory的子类,除了提供
BeanFactory所具有的功能外,还提供了更完整的框架功能:
- 继承
MessageSource,因此支持国际化。 - 资源文件访问,如
URL和文件(ResourceLoader)。 - 载入多个(有继承关系)上下文(即同时加载多个配置文件) ,使得每一个上下文都专注于一个特定的层次,比如应用的web层。
- 提供在监听器中注册
bean的事件。
- 继承
-
-
BeanFactroy和
ApplicationContext在实例化
Bean时存在不同:
BeanFactroy采用的是延迟加载(懒加载)形式来注入Bean的,只有在使用到某个Bean时(调用getBean()),才对该Bean进行加载实例化。这样,我们就不能提前发现一些存在的Spring的配置问题。ApplicationContext,它是在容器启动时,一次性创建了所有的Bean。这样,在容器启动时,我们就可以发现Spring中存在的配置错误,这样有利于检查所依赖属性是否注入。ApplicationContext启动后预载入所有的单实例Bean,所以在运行的时候速度比较快,因为它们已经创建好了。相对于BeanFactory,ApplicationContext唯一的不足是占用内存空间,当应用程序配置Bean较多时,程序启动较慢。
-
BeanFactory和ApplicationContext都支持BeanPostProcessor、BeanFactoryPostProcessor的使用,但两者之间的区别是:BeanFactory需要手动注册,而ApplicationContext则是自动注册。 -
BeanFactory通常以编程的方式被创建,ApplicationContext还能以声明的方式创建,如使用ContextLoader。
-
-
【问】请解释 Spring Bean 的生命周期?(实例化(东西在但不全)在初始化(东西可用)之前),参考Spring常见面试题总结(超详细回答),阿里云面试:Spring 中 Bean 的生命周期是怎样的?,更具体的
Bean加载过程参考Spring的Bean加载流程
Note:Spring Bean的生命周期只有四个阶段:实例化 (Instantiation) --> 属性赋值(Populate) --> 初始化(Initialization) --> 销毁(Destruction),但具体来说,Spring Bean的生命周期包含下图的流程(7 + 2):

-
1)实例化
Bean:- 对于
BeanFactory容器,当客户向容器请求一个尚未初始化的bean时,或初始化bean的时候需要注入另一个尚未初始化的依赖时,容器就会调用createBean()进行实例化。 - 对于
ApplicationContext容器,当容器启动结束后,通过获取BeanDefinition对象中的信息(配置注册表),实例化所有的bean。
- 对于
-
2)设置对象属性(依赖注入):
- 实例化后的对象被封装在
BeanWrapper对象中; - 紧接着,
Spring根据BeanDefinition中的信息 以及 通过BeanWrapper提供的设置属性的接口,完成属性设置与依赖注入。
- 实例化后的对象被封装在
-
3)处理Aware接口:
Spring会检测该对象是否实现了xxxAware接口,通过Aware类型的接口,可以让我们拿到Spring容器的一些资源(设置注入):- ①如果这个
Bean实现了BeanNameAware接口,会调用它实现的setBeanName(String beanId)方法,传入Bean的名字; - ②如果这个
Bean实现了BeanClassLoaderAware接口,调用setBeanClassLoader()方法,传入ClassLoader对象的实例。 - ②如果这个
Bean实现了BeanFactoryAware接口,会调用它实现的setBeanFactory()方法,传递的是Spring工厂自身。 - ③如果这个
Bean实现了ApplicationContextAware接口,会调用setApplicationContext(ApplicationContext)方法,传入Spring上下文;
- ①如果这个
-
4)
BeanPostProcessor前置处理:如果想对Bean进行一些自定义的前置处理,那么可以让Bean实现了BeanPostProcessor接口,那将会调用postProcessBeforeInitialization(Object obj, String s)方法。 -
5)
InitializingBean接口是否实现:如果Bean实现了InitializingBean接口,执行afeterPropertiesSet()方法。 -
6)
init-method:如果Bean在Spring配置文件中配置了init-method属性,则会自动调用其配置的初始化方法。 -
7)
BeanPostProcessor后置处理:如果这个Bean实现了BeanPostProcessor接口,将会调用postProcessAfterInitialization(Object obj, String s)方法;由于这个方法是在Bean初始化结束时调用的,所以可以被应用于内存或缓存技术;以上几个步骤完成后,
Bean就已经被正确创建了,之后就可以使用这个Bean了。- 第5、6 步是真正的初始化,
- 第 3、4 步为在初始化前执行,
- 第 7 步在初始化后执行,初始化完成之后,Bean 就可以被使用了
-
8)
Bean在使用前注册了销毁的相关调用接口 -
9)
DisposableBean接口是否实现:当Bean不再需要时,会经过清理阶段,如果Bean实现了DisposableBean这个接口,会调用其实现的destroy()方法; -
10)
destroy-method:最后,如果这个Bean的Spring配置中配置了destroy-method属性,会自动调用其配置的销毁方法。
-
-
【问】Spring Bean 的作用域(scope)之间有什么区别?,参考Spring常见面试题总结(超详细回答)
Note:- 1)
singleton:默认作用域,单例bean,每个容器中只有一个bean的实例。 - 2)
prototype:为每一个bean请求创建一个实例。 - 3)
request:为每一个request请求创建一个实例,在请求完成以后,bean会失效并被垃圾回收器回收。 - 4)
session:与request范围类似,同一个session会话共享一个实例,不同会话使用不同的实例(ThreadLocal管理session)。 - 5)
global-session:全局作用域,所有会话共享一个实例。如果想要声明让所有会话共享的存储变量的话,那么这全局变量需要存储在global-session中。
- 1)
-
【问】什么是 Spring inner beans?(bean中的成员属性也是一个bean,比如Customer中聚集了一个person对象)
-
【问】Spring 框架中的单例 Beans 是线程安全的么?(
Spring框架并没有对单例bean进行任何多线程的封装处理,需开发者自行去解决(synchronized,lock等)),参考Spring常见面试题总结(超详细回答)
Note:-
Spring容器本身并没有提供Bean的线程安全策略,因此可以说Spring容器中的
Bean本身不具备线程安全的特性,但是具体情况还是要
结合
Bean的作用域来讨论。
-
1)对于
prototype作用域的Bean,每次都创建一个新对象,也就是线程之间不存在Bean共享,因此不会有线程安全问题。 -
2)对于
singleton作用域的
Bean,所有的线程都
共享一个单例实例的
Bean,因此是存在线程安全问题的。但是如果单例
Bean是一个
无状态
Bean(该Bean的成员属性只执行查询操作),那么这个单例
Bean是
线程安全的
。比如
Controller类、
Service类和
Dao等,这些
Bean大多是无状态的,只关注于方法本身。
有状态Bean(Stateful Bean) :就是有实例变量的对象,可以保存数据,是非线程安全的。
无状态Bean(Stateless Bean):就是没有实例变量的对象,不能保存数据,是不变类,是线程安全的。
-
-
有状态单例Bean的线程安全解决方法:
- 对于有状态的
bean(比如Model和View),就需要自行保证线程安全,最浅显的解决办法就是将有状态的bean的作用域由“singleton”改为“prototype”。 - 也可以采用
ThreadLocal解决线程安全问题(空间换时间),为每个线程提供一个独立的变量副本,不同线程只操作自己线程的副本变量。还可以使用synchronized,lock(时间换空间)对单例Bean加锁。
- 对于有状态的
-
-
【问】请解释 Spring Bean 的自动装配?如何开启基于注解的自动装配?(通过
@Autowired自动装配)
Note:要使用@Autowired,需要注册AutowiredAnnotationBeanPostProcessor-
方法1
:引入配置文件中的
<beans>下引入
<context:annotation-config><beans><context:annotation-config /> </beans> 123 -
方法2
:在bean配置文件中直接引入
AutowiredAnnotationBeanPostProcessor:
<beans><bean class="org.springframework.beans.factory.annotation.AutowiredAnnotationBeanPostProcessor"/>
</beans>
123
-
-
【问】请解释自动装配模式的区别?或者说自动装配的规则?,可参考面试题 请解释自动装配模式的区别?
Note:-
Spring装配包括
手动装配和自动装配
,手动装配是基于
xml配置文件的、而
自动装配
则通过
constructor、
setter方法实现(用到
@Autowired注解)。
no:默认的方式是不进行自动装配,通过显式设置ref属性来进行装配。byName:通过参数名 自动装配,Spring容器在配置文件中发现bean的autowire(@Autowired+@Qualifier)属性被设置成byname,之后容器试图匹配、装配和该bean的属性具有相同名字的bean。byType:通过参数类型自动装配,Spring 容器在配置文件中发现bean的 autowire 属性被设置成byType,之后容器试图匹配、装配和该bean的属性具有相同类型的bean。如果有多个 bean 符合条件,则抛出错误。constructor:这个方式类似于byType, 但是要提供给构造器参数,如果没有确定的带参数的构造器参数类型,将会抛出异常。autodetect:首先尝试使用constructor来自动装配,如果无法工作,则使用byType方式。
-
-
【问】请举例解释@Autowired 注解?(
@Resource默认name注入,也提供type注入;@Autowired仅支持type依赖注入,如果要想用name注入,则需要配合@Qualifier消歧) -
【问】请举例说明@Qualifier注解?,参考SpringBoot @Autowired的两种注入方式
Note:- 如果在
xml中定义了一种类型(type,比如Student类)的多个bean,同时在java注解中又想把其中一个bean对象作为属性,那么此时可以使用@Qualifier加@Autowired来达到这一目的。 - 若不在
student2上加@Qualifier(value="student2")这个注解,在运行时会出现“No qualifying bean of type [com.tutorialspoint.Student] is defined: expected single matching bean but found 2: student1,student2”这个异常。
- 如果在
-
【问】Spring如何解决循环依赖问题?,参考Spring如何解决循环依赖问题
Note:
循环依赖问题在Spring中主要有三种情况:- 1)通过构造方法进行依赖注入时产生的循环依赖问题。
- 2)通过
setter方法进行依赖注入且是在多例(原型)模式下产生的循环依赖问题。 - 3)通过
setter方法进行依赖注入且是在单例模式下产生的循环依赖问题。
在
Spring中,只有第(3)种方式的循环依赖问题被解决了,其他两种方式在遇到循环依赖问题时都会产生异常。这是因为:- 第一种构造方法注入的情况下,在
new对象的时候就会堵塞住了,其实也就是”先有鸡还是先有蛋“的历史难题。 - 第二种
setter方法(多例)的情况下,每一次getBean()时,都会产生一个新的Bean,如此反复下去最终就会导致OOM问题的出现。
Spring在单例模式下的setter方法依赖注入引起的循环依赖问题,主要是通过二级缓存和三级缓存来解决的,其中三级缓存是主要功臣。解决的核心原理就是:在对象实例化之后,依赖注入之前,Spring提前暴露的Bean实例的引用在第三级缓存中进行存储。 -
【问】构造方法注入和设值注入有什么区别?(设值
setter注入支持大部分依赖注入,单例模式下的setter可解决循环依赖的问题)
Note:- 两者存在以下明显的区别:
- 1)设值注入(
setter)支持大部分依赖注入,如果我们仅需要注入int、string和long型的变量,不要用设值方法注入。对于基本类型,如果没有注入,可以为基本类型设置默认值。
构造方法(constructor)注入不支持大部分依赖注入,因为在调用构造方法时必须传入正确的构造参数,否则会报错。 - 2)设值注入不会重写构造方法的值。如果我们对同一个变量同时使用了构造方法注入和设值注入,那么构造方法将不能覆盖设值注入的值。很明显,因为构造方法只在对象被创建时被调用(设值
setter注入在前,构造方法constructor注入在后)。 - 3)在使用设值注入时还不能保证某种依赖是否已经被注入,也就是说,这时对象的依赖关系有可能是不完整的。而在另一种情况下,构造器(
constructor)注入则不允许生成依赖关系不完整的对象。 - 4)在设值注入时如果对象A和对象B互相依赖,在创建对象A时
Spring会抛出ObjectCurrentlyInCreationException异常,因为在对象B被创建之前对象A是不能被创建的,反之亦然。Spring用设值(setter)注入解决了循环依赖问题,因为对象的设值方法(setter)是在对象被创建之前被调用的。
- 1)设值注入(
- 两者存在以下明显的区别:
-
【问】请举例说明如何在 Spring 中注入一个 Java Collection?(手动装配)
Note:-
Spring提供了以下四种集合类的配置元素:
- `` : 该标签用来装配可重复的list值。
- `` : 该标签用来装配没有重复的set值。
- ``: 该标签可用来注入键和值可以为任何类型的键值对。
- `` : 该标签支持注入键和值都是字符串类型的键值对。
-
例子如下:
<beans>
<!-- Definition for javaCollection -->
<bean id="javaCollection" class="com.howtodoinjava.JavaCollection"><!-- java.util.List --><property name="customList"><list><value>INDIA</value><value>Pakistan</value><value>USA</value><value>UK</value></list></property>
</bean>
</beans>
1234567891011121314
-
-
【问】如何向 Spring Bean 中注入一个 Java.util.Properties?(手动装配)
Note:-
方法1
:使用
<value>标签配置多值
<bean id="propertiesInjectBean1" class="com.doctor.spring.context.inject.PropertiesInjectBean1"><property name="properties"><value>name=doctorsex=manaddress=alien</value></property> </bean> 123456789 -
方法2
:使用
<property>标签配置单值(设值注入)
<bean id="propertiesInjectBean2" class="com.doctor.spring.context.inject.PropertiesInjectBean2"><property name="properties"><props><prop key="name">doctor</prop><prop key="address">alien</prop></props></property>
</bean>
12345678
-
-
【问】Spring基于xml注入bean的几种方式?(前两种最常用),参考Spring中bean的注入方式
Note:set()方法注入();- 构造器注入:①通过
index属性设置参数的位置;②通过ref属性设置参数类型;(``) - 静态工厂注入;
- 实例工厂;
-
【问】将Bean放入Spring容器中的五种方式?
-
【问】Spring AOP是什么?与AspectJ有什么区别?(
Spring AOP常用注解,AOP术语 即 类图 见上面解析),参考关于 Spring AOP (AspectJ) 你该知晓的一切,@Pointcut 注解的使用
Note:-
OOP面向对象,允许开发者定义纵向的关系(继承),但并不适用于定义横向的关系,会导致大量代码的重复,而不利于各个模块的重用。 -
AOP,一般称为面向切面,作为面向对象的一种补充(横向扩展),用于将那些与业务无关,但却对多个对象产生影响的公共行为和逻辑,抽取并封装为一个可重用的模块,这个模块被命名为“切面”(Aspect),减少系统中的重复代码,降低了模块间的耦合度,提高系统的可维护性。可用于权限认证、日志、事务处理。 -
AOP实现的关键在于 代理模式,AOP代理主要分为静态代理和动态代理。静态代理的代表为AspectJ;动态代理则以Spring AOP为代表。- 1)
AspectJ是静态代理,也称为编译时增强,AOP框架会在编译阶段(ajc编译器)生成AOP代理类,并将AspectJ(切面)织入到Java字节码中,运行的时候就是增强之后的AOP对象。 - 2)
Spring AOP使用的动态代理,所谓的动态代理就是说AOP框架不会去修改字节码,而是每次运行时在内存中临时为方法生成一个AOP对象,这个AOP对象包含了目标对象的全部方法,并且在特定的切点做了增强处理,并回调原对象的方法。
- 1)
-
Spring AOP中的动态代理主要有两种方式,JDK动态代理和CGLIB动态代理(Spring AOP 的实现是遵循AOP规范的,特别是以AspectJ(与java无缝整合)为参考,因此在AOP的术语概念上与前面分析的AspectJ的AOP术语是一样的)- JDK动态代理只提供接口的代理(代理类需要实现该接口),不支持类的代理,要求被代理类实现接口。
- 如果被代理类没有实现接口,那么
Spring AOP会选择使用CGLIB来动态代理目标类。
-
静态代理与动态代理区别在于生成
AOP代理对象的时机不同,相对来说AspectJ的静态代理方式具有更好的性能,但是AspectJ需要特定的编译器进行处理,而Spring AOP则无需特定的编译器处理。 -
5)AOP术语:参考@Pointcut 注解的使用
-
Advice(通知、切面): 某个连接点
JointPoint所采用的处理逻辑,也就是向连接点注入的代码, AOP在特定的切入点上执行的增强处理。
1)@Before: 标识一个前置增强方法,相当于BeforeAdvice的功能.
2)@After: final增强,不管是抛出异常或者正常退出都会执行.
3)@AfterReturning: 后置增强,似于AfterReturningAdvice, 方法正常退出时执行。
4)@AfterThrowing: 异常抛出增强,相当于ThrowsAdvice.
5)@Around: 环绕增强,相当于MethodInterceptor。 -
JointPoint(连接点):程序运行中的某个阶段点,比如方法的调用、异常的抛出等。 -
Pointcut(切入点):
JoinPoint的集合,是程序中需要
注入
Advice的位置的集合,
指明
Advice要在什么样的条件下才能被触发,在程序中主要体现为:表示式(expression)和签名(signature)。
//Pointcut表示式 @Pointcut("execution(* com.savage.aop.MessageSender.*(..))") //Point签名 private void log(){} 1234 -
Advisor(增强): 是PointCut和Advice的综合体,完整描述了一个advice将会在pointcut所定义的位置被触发。 -
@Aspect(切面): 通常是一个类的注解,里面可以定义切入点Pointcut和通知Advice。
在
java配置类中使用@EnableAspectJAutoProxy注解开启Spring对AspectJ代理的支持。 -
-
-
【问】请举例解释@Required 注解?(
@Required注解主要用在setter方法上,它表示该setter方法的属性必须要在配置时注入值。否则就会报BeanInitializationException异常),参考Spring之@Required注解 -
【问】SpringMVC的流程?,参考SpringMVC常见面试题总结(超详细回答)
Note:

具体步骤:- 1)用户向前端控制器
DispatcherServlet发送请求; - 2)
DispatcherServlet向HandlerMapping(请求到处理器映射)请求handler; - 3)
HandlerMapping返回handler对象给DispatcherServlet; - 4)
DispatcherServlet拿着handler对象与HandlerAdapter进行适配; - 5)
HandlerAdapter向DispatcherServlet返回ModelAndView对象; - 6)
DispatcherServlet拿着ModelAndView到ViewResolver(视图解析器)去解析,得到View对象; - 7)
DispatcherServlet将模型数据填充到视图中(渲染); - 8)
DispatcherServlet响应用户;
- 1)用户向前端控制器
-
【问】Springmvc的优点?,参考SpringMVC常见面试题总结(超详细回答)
Note:- 1)可以支持各种视图技术,而不仅仅局限于JSP;
- 2)与Spring框架集成(如IoC容器、AOP等);
- 3)清晰的角色分配:前端控制器(
dispatcherServlet) ,请求到处理器映射(handlerMapping),处理器适配器(HandlerAdapter),视图解析器(ViewResolver)。 - 4) 支持各种请求资源的映射策略。
-
【问】SpringMVC怎么样设定重定向和转发的?,参考SpringMVC常见面试题总结(超详细回答)
Note:- 1)转发:在返回值前面加
"forward:",譬如"forward:user.do?name=method4" - 2)重定向:在返回值前面加
"redirect:",譬如"redirect:http://www.baidu.com"
- 1)转发:在返回值前面加
-
【问】Spring 框架中有哪些不同类型的事件?(更新/开始/停止/关闭/请求事件;
Spring事件驱动模型用到了观察者模式,事件为观察者)
Note:Spring提供了以下5种标准的事件:- 1)上下文更新事件(
ContextRefreshedEvent):在调用ConfigurableApplicationContext接口中的refresh()方法时被触发。 - 2)上下文开始事件(
ContextStartedEvent):当容器调用ConfigurableApplicationContext的Start()方法开始/重新开始容器时触发该事件。 - 3)上下文停止事件(
ContextStoppedEvent):当容器调用ConfigurableApplicationContext的Stop()方法停止容器时触发该事件。 - 4)上下文关闭事件(
ContextClosedEvent):当ApplicationContext被关闭时触发该事件。容器被关闭时,其管理的所有单例Bean都被销毁。 - 5)请求处理事件(
RequestHandledEvent):在Web应用中,当一个http请求(request)结束触发该事件。
如果一个
bean实现了ApplicationListener接口,当一个ApplicationEvent被发布以后,bean会自动被通知。 - 1)上下文更新事件(
-
【问】Spring 框架中都用到了哪些设计模式?
Note:-
Spring设计模式的详细使用案例可以阅读这篇文章:
Spring中所使用的设计模式
- 1)工厂模式:Spring使用工厂模式,通过
BeanFactory和ApplicationContext来创建对象 - 2)单例模式:Bean默认为单例模式
- 3)策略模式:例如
Resource的实现类,针对不同的资源文件,实现了不同方式的资源获取策略; - 4)代理模式:
Spring的AOP功能用到了JDK的动态代理和CGLIB字节码生成技术 - 5)模板方法:可以将相同部分的代码放在父类中,而将不同的代码放入不同的子类中,用来解决代码重复的问题。比如
RestTemplate,JmsTemplate,JpaTemplate; - 6)适配器模式:
Spring AOP的增强或通知(Advice)使用到了适配器模式,Spring MVC中也是用到了适配器模式适配Controller - 7)观察者模式:
Spring事件驱动模型就是观察者模式的一个经典应用。 - 8)桥接模式:可以根据客户的需求能够动态切换不同的数据源。比如我们的项目需要连接多个数据库,客户在每次访问中根据需要会去访问不同的数据库
- 1)工厂模式:Spring使用工厂模式,通过
-
5、Spring Boot/Spring Cloud
参考Spring Boot面试题(2020最新版),【金三银四】Spring Boot面试题(2021最新版),Spring Cloud面试题(2020最新版),【金三银四】Spring Cloud面试题(2021最新版)
1)SpringBoot部分
- 【问】什么是 Spring Boot?
- 【问】Spring Boot 有哪些优点?
- 【问】什么是 JavaConfig?
- 【问】Spring Boot 中的监视器是什么?
- 【问】如何在 Spring Boot 中禁用 Actuator 端点安全性?
- 【问】如何在自定义端口上运行 Spring Boot 应用程序?
- 【问】什么是 YAML?
- 【问】如何使用 Spring Boot 实现异常处理?
- 【问】Spring Boot比Spring多哪些注解
- 【问】Spring Boot如何访问不同的数据库
- 【问】如何实现 Spring Boot 应用程序的安全性?
- 【问】如何集成 Spring Boot 和 ActiveMQ?
- 【问】如何使用 Spring Boot 实现分页和排序?
- 【问】什么是 Swagger?你用 Spring Boot 实现了它吗?
- 【问】什么是 Spring Profiles?
- 【问】什么是 Spring Batch?
- 【问】什么是 FreeMarker 模板?
- 【问】如何使用 Spring Boot 实现异常处理?
- 【问】什么是 CSRF 攻击?如何避免
- 【问】什么是 WebSockets?
- 【问】我们如何监视所有 Spring Boot 微服务?
2)SpringCloud整体理解
-
【问】为什么需要学习Spring Cloud?(单体结构不适合业务扩展,如果扩展业务,系统复杂度高)
- 由于单体结构的应用随着系统复杂度的增高,会暴露出各种各样的问题。近些年来,微服务架构逐渐取代了单体架构,且这种趋势将会越来越流行。Spring Cloud是目前最常用的微服务开发框架,已经在企业级开发中大量的应用。
-
【问】什么是Spring Cloud?(一系列成熟框架的有序集合,或者说是“SpringBoot微服务应用 + 分布式基础设施”,划分的功能很多很细,支持一键启动和部署,为中小型公司提供关于分布式系统基础设施的一站式解决方案,便于开发者更精准地制定优化服务方案,提高系统的可维护性)
- Spring Cloud是一系列框架的有序集合。它利用Spring Boot的开发便利性巧妙地简化了分布式系统基础设施的开发,如服务发现注册、配置中心、智能路由、消息总线、负载均衡、断路器、数据监控等,都可以用Spring Boot的开发风格做到一键启动和部署。
- Spring Cloud并没有重复制造轮子,它只是将各家公司开发的比较成熟、经得起实际考验的服务框架组合起来,通过Spring Boot风格进行再封装屏蔽掉了复杂的配置和实现原理,最终给开发者留出了一套简单易懂、易部署和易维护的分布式系统开发工具包。
-
【问】Spring Cloud有哪五大组件?(Eureka微服务注册与发现,Ribbon客户端负载均衡,Feign远程调用,Zuul路由/认证/限流/服务端负载均衡,Hystrix隔离熔断降级,这五个组件都来自Netflix;还有Spring Cloud Config也是个重要组件,可实现分布式统一配置管理),参考面试请不要再问我Spring Cloud底层原理
-
Spring Cloud Eureka是Spring Cloud Netflix微服务套件的一部分,基于Netflix Eureka做了二次封装,主要负责完成微服务实例的自动注册与发现,这也是微服务架构中的核心和基础功能。Eureka服务冶理体系中的三个核心角色:服务注册中心、服务提供者以及服务消费者,其中服务提供者以及服务消费者都属于Eureka Client。更多Eureka相关的内容,可以参考 Spring Cloud 之 Eureka; -
Ribbon就是一个客户端的负载均衡开源组件,是Netflix发布的开源项目。它不像服务注册中心Eureka Server、配置中心Spring Cloud Config那样独立部署,而是作为基础设施模块,几乎存在于每个Spring Cloud微服务提供者中。Feign组件自身不具备负载均衡能力,Spring CloudFeign是通过集成Ribbon组件实现客户端的负载均衡。微服务间的RPC调用以及API网关的代理请求的RPC转发调用,实际上都需要通过Ribbon来实现负载均衡。Ribbon在客户端以轮询、随机、权重等多种方式实现负载均衡。更多Ribbon相关的内容,可以参考 Spring Cloud 之 Ribbon; -
在 Spring Cloud 中使用
Feign,可以做到使用 HTTP 请求访问远程服务,就像调用本地方法一样的,开发者完全感知不到这是在调用远程方法,更感知不到在访问 HTTP 请求。Feign 整合了 Ribbon 和 Hystrix,具备负载均衡、隔离、熔断与降级功能;更多Feign的相关内容,可以参考 Spring Cloud 之 Feign 简介及简单使用; -
Zuul的功能大致有:- 路由:将不同REST请求转发至不同的微服务提供者,其作用类似于Nginx的反向代理。同时,也起到了统一端口的作用,将很多微服务提供者的不同端口统一到了Zuul的服务端口。
- 认证:网关直接暴露在公网上时,终端要调用某个服务,通常会把登录后的token(令牌)传过来,网关层对token进行有效性验证。如果token无效(或没有token),就不允许访问REST服务。可以结合
Spring Security中的认证机制完成Zuul网关的安全认证。 - 限流:高并发场景下瞬时流量不可预估,为了保证服务对外的稳定性,限流成为每个应用必备的一道安全防火墙。如果没有这道安全防火墙,那么请求的流量超过服务的负载能力时很容易造成整个服务的瘫痪。
- 负载均衡:在多个微服务提供者之间按照多种策略实现负载均衡。
更多Zuul的相关内容,可以参考 Spring Cloud 之 Zuul;
-
Hystrix是Netflix公司的一款组件,其功能是:- 隔离:通过Hystrix的线程池去访问服务,不同的服务通过不同的线程池,实现了不同的服务调度隔离;
- 熔断:分布式架构中的熔断器(断路器)主要用于RPC接口上,为接口安装上“保险丝”,以防止RPC接口出现拥塞时导致系统压力过大而引起的系统瘫痪,当RPC接口流量过大或者目标Provider出现异常时,熔断器及时切断故障可以起到自我保护的作用。
- 降级:当服务不可用(服务正在等待、链接超时、网络延迟、服务器响应慢等),客户端一直等待时,调用fallback方法给客户端返回一个错误提示,不让客户端继续等待。
更多Hystrix的相关内容,可以参考 Spring Cloud 之 Hystrix;
-
-
【问】关于分布式基础设施,SpringCloud如何实现?(Config,Netflix,Bus,Consul,Security,Sleuth,Stream,Stream,Task,Zookeeper,Gateway,OpenFeign)
Spring Cloud的子项目,大致可分成两类,一类是对现有成熟框架"Spring Boot化"的封装和抽象,也是数量最多的项目;第二类是开发了一部分分布式系统的基础设施的实现,如Spring Cloud Stream扮演的就是kafka, ActiveMQ这样的角色。
-
Spring Cloud Config:
集中配置管理工具,分布式系统中统一的外部配置管理,默认使用Git来存储配置,可以支持客户端配置的刷新及加密、解密操作。 -
Spring Cloud Netflix(SpringCloud 5大组件):
Netflix OSS 开源组件集成,包括Eureka、Hystrix、Ribbon、Feign、Zuul等核心组件。 -
Spring Cloud Bus:
用于传播集群状态变化的消息总线,使用轻量级消息代理链接分布式系统中的节点,可以用来动态刷新集群中的服务配置。 -
Spring Cloud Consul:
基于Hashicorp Consul的服务治理组件。 -
Spring Cloud Security:
安全工具包,对Zuul代理中的负载均衡OAuth2客户端及登录认证进行支持。 -
Spring Cloud Sleuth:
Spring Cloud应用程序的分布式请求链路跟踪,支持使用Zipkin、HTrace和基于日志(例如ELK)的跟踪。 -
Spring Cloud Stream:
轻量级事件驱动微服务框架,可以使用简单的声明式模型来发送及接收消息,主要实现为Apache Kafka及RabbitMQ。 -
Spring Cloud Task:
用于快速构建短暂、有限数据处理任务的微服务框架,用于向应用中添加功能性和非功能性的特性。 -
Spring Cloud Zookeeper:
基于Apache Zookeeper的服务治理组件。 -
Spring Cloud Gateway:
API网关组件,对请求提供路由及过滤功能。 -
Spring Cloud OpenFeign:
基于Ribbon和Hystrix的声明式服务调用组件,可以动态创建基于Spring MVC注解的接口实现用于服务调用,在Spring Cloud 2.0中已经取代
Feign成为了一等公民。
-
-
【问】SpringBoot和SpringCloud的区别?(Springboot可以快速开发单个微服务,SpringCloud是对每个微服务进行管理,全局的服务治理框架)
- SpringBoot专注于快速方便的开发单个个体微服务。
- SpringCloud是关注全局的微服务协调整理治理框架,它将SpringBoot开发的一个个单体微服务整合并管理起来,
- 为各个微服务之间提供配置管理、服务发现、断路器、路由、微代理、事件总线、全局锁、决策竞选、分布式会话等等集成服务
- SpringBoot可以离开SpringCloud独立使用开发项目, 但是SpringCloud离不开SpringBoot ,属于依赖的关系
- SpringBoot专注于快速、方便的开发单个微服务个体,SpringCloud关注全局的服务治理框架。
-
【问】Spring Cloud和SpringBoot版本对应关系?Spring Cloud和各子项目版本对应关系?
Spring Cloud Version SpringBoot Version Hoxton 2.2.x Greenwich 2.1.x Finchley 2.0.x Edgware 1.5.x Dalston 1.5.x Component Edgware.SR6 Greenwich.SR2 spring-cloud-bus 1.3.4.RELEASE 2.1.2.RELEASE spring-cloud-commons 1.3.6.RELEASE 2.1.2.RELEASE spring-cloud-config 1.4.7.RELEASE 2.1.3.RELEASE spring-cloud-netflix 1.4.7.RELEASE 2.1.2.RELEASE spring-cloud-security 1.2.4.RELEASE 2.1.3.RELEASE -
【问】Spring Cloud 和dubbo区别?
- 1)服务调用方式:dubbo是RPC;springcloud Rest Api
- 2)注册中心:dubbo是zookeeper;springcloud是Eureka,也可以是zookeeper
- 3)服务网关:dubbo本身没有实现,只能通过其他第三方技术整合;springcloud有
Zuul路由网关,作为路由服务器,进行消费者的请求分发,springcloud支持熔断器(Hystrix),与git完美集成配置文件支持版本控制(Config),事物总线实现配置文件的更新与服务自动装配等等一系列的微服务架构要素。
-
【问】微服务的框架那么多比如:dubbo、Kubernetes,为什么就要使用Spring Cloud的呢?(Spring亲儿子,社区活跃,有更新保证,对Java开发者友好;服务拆分粒度细, 耦合度低, 提供关于分布式系统基础设施的一站式解决方案;支持跨平台并不是它的优势)
- 优点:
- 产出于Spring大家族,Spring在企业级开发框架中无人能敌,来头很大,可以保证后续的更新、完善
- 组件丰富,功能齐全。Spring Cloud 为微服务架构提供了非常完整的支持。例如、配置管理、服务发现、断路器、微服务网关等;
- Spring Cloud 社区活跃度很高,教程很丰富,遇到问题很容易找到解决方案
- 服务拆分粒度更细,耦合度比较低,有利于资源重复利用,有利于提高开发效率
- 可以更精准的制定优化服务方案,提高系统的可维护性
- 减轻团队的成本,可以并行开发,不用关注其他人怎么开发,先关注自己的开发
- 微服务可以是跨平台的,可以用任何一种语言开发
- 适于互联网时代,产品迭代周期更短
- 缺点:
- 微服务过多,治理成本高,不利于维护系统
- 分布式系统开发的成本高(容错,分布式事务等)对团队挑战大
Spring Cloud对于中小型互联网公司来说是一种福音,因为这类公司往往没有实力或者没有足够的资金投入去开发自己的分布式系统基础设施,使用Spring Cloud一站式解决方案能在从容应对业务发展的同时大大减少开发成本。
- 优点:
-
【问】Kubernetes和Spring Cloud哪个部署微服务更好?(在微服务实现上,Kubernetes是基于容器编排实现的;而Spring Cloud则是通过集成各种成熟框架实现的,本身没有强调容器技术,因此将两者结合是目前最好的解决方案:spring-cloud-kubernetes),参考Kubernetes和Springcloud比较
Note:
kubernetes是一个容器集群管理系统,为容器化的应用程序提供部署运行,**维护,扩展,资源调度,服务发现(ETCD)**等功能。SpringCloud是一个构建微服务的框架,而Kubernete是通过对运行的容器编排来实现微服务的。- 相同点:两者从构建微服务的角度和实现方式有很大的不同,但他们提供了构建微服务所需的全部功能。
- 区别:kubernetes:支持多语言,除了有微服务功能,还有环境生命周期,更像是一个平台,而springcloud是一个框架, 但是学习成本高。
结合了
kubernetes和SpringCloud的优点,springcloud官方推出的Spring Cloud Kubernetes开源项目,链接如下: https://github.com/spring-cloud/spring-cloud-kubernetes#why-do-you-need-spring-cloud-kubernetes参考文档如下:你好spring-cloud-kubernetes
3、SpringCloud五大组件
a)Eureka(服务注册与发现)
-
【问】什么是服务注册与发现?(注册中心和服务提供者双方共同维护一张服务注册表;注册中心客户端组件负责和注册中心通信(包括服务注册和发现), 远程客户端组件负责和服务提供者通信(包括RPC远程调用))
Note:
从宏观角度,微服务架构下的系统角色可以简单分为注册中心、服务提供者两个角色,而服务提供者中又包括注册中心客户端组件和 远程客户端组件。

-
服务注册是指服务提供者将自己的服务信息(如服务名、IP地址等)告知服务注册中心。
-
服务发现:注册中心客户端组件从注册中心查询所有服务提供者信息,当其他服务下线后,注册中心能够告知注册中心客户端组件这种变化。
-
远程客户端组件与服务提供者之间一般使用某种RPC通信机制来进行服务消费(不同服务提供者之间的PRC通信),常见的RPC通信方式为REST API,底层为HTTP传输协议。服务提供者通常以Web服务的方式提供REST API接口;远程客户端组件则通常以模块组件的方式完成RESTAPI的远程调用。
-
注册中心
的主要功能如下:
- 服务注册表维护:此功能是注册中心的核心,用来记录各个服务提供者实例的状态信息。注册中心提供Provider实例清单的查询和管理API,用于查询可用的Provider实例列表,管理Provider实例的上线和下线。
- 服务健康检查:注册中心使用一定机制定时检测已注册的Provider实例,如发现某实例长时间无法访问,就会从服务注册表中移除该实例。
-
服务提供者
的主要功能如下:
- 服务注册:是指
Provider微服务实例在启动时(或者定期)将自己的信息注册到注册中心的过程。 - 心跳续约:
Provider实例会定时向注册中心提供“心跳”,以表明自己还处于可用的状态。当一个Provider实例停止心跳一段时间后,注册中心会认为该服务实例不可用了,就会将该服务实例从服务注册表中剔除。如果被剔除掉的Provider实例过了一段时间后又继续向注册中心提供心跳,那么注册中心会把该Provider实例重新加入服务注册表中。 - 健康状况查询:
Provider实例能提供健康状况查看的API,注册中心或者其他的微服务Provider能够获取其健康状况。
- 服务注册:是指
-
服务提供者的
服务注册和心跳续约
一般都会通过
注册中心客户端组件
来完成。
注册中心客户端组件还有如下功能
:
- 服务发现:从注册中心查询可用
Provider实例清单。 - 实例缓存:将从注册中心查询的
Provider实例清单缓存到本地,不需要在每次使用时都去注册中心临时获取。
- 服务发现:从注册中心查询可用
Spring Cloud生态体系中存在多种注册中心框架,例如
Eureka、Nacos、Consul、ZooKeeper等。 -
-
【问】什么是Eureka(服务通过Eureka客户端注册到EurekaService上,并保持心跳,EurekaService可对这些服务进行监控),参考 Spring Cloud 之 Eureka
-
【问】Eureka怎么实现高可用(注册多台Eureka服务器)
-
【问】什么是Eureka的自我保护模式,参考 Spring Cloud 之 Eureka
- 在检测某个服务的心跳时,如果在15min内失败比例低于85%阈值,则该服务为不健康的服务,自我保护机制并不会将该服务从注册表中马上删除;
- 建议在延迟高,网络质量差的环境关闭自我保护机制
-
【问】DiscoveryClient类的作用,参考spring cloud:eureka服务发现
- 在
SpringCloud中可以通过@EnableEurekaClient来将服务注册到Eureka,使得Eureka和其他服务提供者可以发现该服务实例。 - 当一个客户端(服务提供者)注册到
eureka,它会提供关于它自己的端口、地址、健康监控url和home页面等等的元数据,erueka会从每个实例接受心跳信息。如果心跳在配置的时间内失败,实例通常会从注册表中移除。 DiscoveryClient有Netflix提供的com.netflix.discovery.DiscoveryClient,也有SpringCloud提供的org.springframework.cloud.client.discovery.DiscoveryClient,后者不只用于Eureka的服务发现和注册。
- 在
-
【问】Eureka和ZooKeeper都可以提供服务注册与发现的功能,请说说两个的区别?(ZooKeeper有主从,选举期间注册服务挂;Eureka无主从,一个挂了部分注册服务仍然可用)
- 1)ZooKeeper中的节点服务挂了就要选举,在选举期间注册服务瘫痪,虽然服务最终会恢复,但是选举期间不可用的, 选举就是改微服务做了集群,必须有一台主其他的都是从;
- 2)Eureka各个节点是平等关系(无主从),服务器挂了没关系,只要有一台Eureka就可以保证服务可用,数据都是最新的。 如果查询到的数据并不是最新的,就是因为Eureka的自我保护模式导致的。
- 3)Eureka本质上是一个工程,而ZooKeeper只是一个进程
- 4)Eureka可以很好的应对因网络故障导致部分节点失去联系的情况,而不会像ZooKeeper一样使得整个注册系统瘫痪
- 5)ZooKeeper保证的是CP,Eureka保证的是AP;
b)Ribbon(不能单独使用)
-
【问】Ribbon是什么?(客户端负载均衡的软件,需要和Eureka配合才能实现负载均衡,本身不能独立部署;可以通过轮询、随机等规则对注册中心中的目标服务器信息,实现负载均衡)
,参考
Spring Cloud 之 Ribbon
;
- Ribbon是Netflix发布的开源项目,主要功能是提供客户端的软件负载均衡算法
- Ribbon客户端组件提供一系列完善的配置项,如连接超时,重试等。简单的说,就是在配置文件中列出后面所有的机器,Ribbon会自动的帮助你基于某种规则(如简单轮询,随机连接等)去连接这些机器。我们也很容易使用
Ribbon实现自定义的负载均衡算法。(有点类似Nginx)
-
【问】Nginx与Ribbon的区别(
Ribbon属于客户端负载均衡,Nginx为服务器端负载均衡),参考
Spring Cloud 之 Ribbon
;
Nginx是反向代理同时可以实现负载均衡,nginx拦截客户端请求采用负载均衡策略,根据upstream配置进行转发,相当于浏览器(客户端)发送的请求通过nginx服务器进行转发,属于服务器负载均衡,客户端并没有指定某一个具体的服务器来进行响应。Ribbon是客户端负载均衡,服务提供者从注册中心读取目标服务器信息,然后在每次RPC调用请求带来之前,客户端(Provider)采用轮询策略对服务直接访问某一个具体的服务器(Provider),全程在客户端操作(该客户端轮询操作对其他客户端不可见,客户端只能通过尽量随机的方式来避免同一个服务器负载过大)。
-
【问】Ribbon底层实现原理(同一接口计数取余)
- Ribbon 使用
discoveryClient从注册中心读取目标服务信息,对同一接口请求进行计数,使用%取余算法获取目标服务集群索引,返回获取到的目标服务信息。
- Ribbon 使用
-
【问】@LoadBalanced注解的作用(Ribbon客户端的负载均衡接口),参考 Spring Cloud 之 Ribbon;
c)Feign(配合Ribbon使用)
Note:Feign在Spring Cloud2.0升级为OpenFeign
-
【问】什么是Feign?(
Feign帮我们声明一组与Provider的REST接口相对应的本地API接口方法,本质是利用动态代理抽象成FeignClient(Java API)客户端,完成与服务提供方(Provider)REST接口的绑定;Feign + ribbon实现“微服务注册与发现”中的远程调用组件),参考Spring Cloud 之 Feign 简介及简单使用-
Feign是在RestTemplate基础上封装的,使用注解的方式来声明一组与服务提供者(Provider)Rest接口所对应的本地Java API接口方法。 -
Feign将远程Rest接口抽象成一个声明式的FeignClient(Java API)客户端,并且负责完成FeignClient客户端和服务提供方(Provider)的Rest接口绑定。 -
Feign使用了动态代理,使用@FeignClient调用接口的本质就是调用Feign创建的动态代理,然后根据接口上的@RequestMapping等注解,来动态构造出要请求的服务的地址并对这个地址发起请求、解析响应(动态代理模拟客户端(浏览器,App)发送REST请求的过程)。 -
Feign具备可插拔的注解支持,包括Feign注解和JAX-RS注解。同时,对于Feign自身的一些主要组件,比如编码器和解码器等,也以可插拔的方式提供,在有需求时方便扩张和替换它们。 -
在 Spring Cloud 中使用
Feign,可以做到使用
HTTP请求访问远程服务,就像调用本地方法一样的,开发者完全感知不到这是在调用远程方法,更感知不到在访问 HTTP 请求。接下来介绍一下
Feign的特性,具体如下:
- 可插拔的注解支持,包括
Feign注解和AX-RS注解。 - 支持可插拔的
HTTP编码器和解码器。 - 支持
Hystrix和它的Fallback。 - 支持
Ribbon的负载均衡。 - 支持
HTTP请求和响应的压缩。
- 可插拔的注解支持,包括
-
Feign是通过集成Ribbon组件实现客户端的负载均衡。微服务间的RPC调用以及API网关的代理请求的RPC转发调用,实际上都需要通过Ribbon来实现负载均衡。 -
它整合了
Ribbon和Hystrix,从而不需要开发者针对 Feign 对其进行整合。Feign 还提供了 HTTP 请求的模板,通过编写简单的接口和注解,就可以定义好 HTTP 请求的参数、格式、地址等信息。Feign 会完全代理 HTTP 的请求,在使用过程中我们只需要依赖注入 Bean,然后调用对应的方法传递参数即可。
-
-
【问】SpringCloud有几种调用接口方式(Feign,RestTemplate)
-
【问】Ribbon和Feign调用服务的区别(请求调用方式不同,Ribbon需要自己构建Http请求,Feign则直接通过API接口方法帮我们处理了)
Ribbon需要我们自己构建Http请求,模拟Http请求然后通过RestTemplate发给其他服务,步骤相当繁琐;- 而
Feign则是在Ribbon的基础上进行了一次改进,采用接口的形式,将我们需要调用的服务方法定义成抽象方法保存在本地就可以了,不需要自己构建Http请求了,直接调用接口就行了,不过要注意,调用方法要和本地抽象方法的签名完全一致。
-
【问】OpenFeign服务远程调用过程,参考Spring Cloud 之 Feign 简介及简单使用
- 1)
Provider通过注册中心客户端组件,利用DiscoveryClient从注册中心获取服务注册表 - 2)在发起RPC远程调用时,远程调用组件中的
Ribbon,通过轮询或随机方式,选择要请求的服务接口。 - 3)远程调用组件中的
Feign通过动态代理的方式实现FeignClient客户端; - 4)接着完成
FeignClient中的API接口方法与服务提供方(Provider)提供的REST接口进行绑定; - 5)根据接口上的
@RequestMapping等注解,来动态构造出要请求的服务的地址并对这个地址发起请求、解析响应(动态代理模拟客户端(浏览器,App)发送REST请求的过程)。
- 1)
d)Hystrix(对RPC调用接口进行过载保护)
-
【问】什么是断路器(熔断器),参考Spring Cloud 之 Hystrix
- 分布式架构中的熔断器主要用于RPC接口上,为接口安装上“保险丝”,以防止RPC接口出现拥塞时导致系统压力过大而引起的系统瘫痪,当
RPC接口流量过大或者目标Provider出现异常时,熔断器及时切断故障可以起到自我保护的作用。 - 为什么说熔断器非常重要呢?如果没有过载保护,在分布式系统中,当被调用的远程服务无法使用时,就会导致请求的资源阻塞在远程服务器上而耗尽。很多时候刚开始可能只是出现了局部小规模的故障,然而由于种种原因,故障影响范围越来越大,最终导致全局性的后果。
- 熔断器具体的工作机制为:统计最近RPC调用发生错误的次数,然后根据统计值中的失败比例等信息来决定是否允许后面的
RPC调用继续或者快速地失败回退。
熔断器的3种状态如下:- 关闭(closed):熔断器关闭状态,这也是熔断器的初始状态,此状态下RPC调用正常放行。
- 开启(open):失败比例到一定的阈值之后,熔断器进入开启状态,此状态下RPC将会快速失败,然后执行失败回退逻辑。
- 半开启(half-open):在打开一定时间之后(睡眠窗口结束),熔断器进入半开启状态,小流量尝试进行RPC调用放行。如果尝试成功,熔断器就变为关闭状态,
RPC调用正常;如果尝试失败,熔断器就变为开启状态,RPC调用快速失败。(有点类似TCP拥塞控制中的慢开始)
- 熔断器状态之间的相互转换关系如图所示。

在半开启状态下,允许进行一次RPC调用的尝试,如果实际调用成功,熔断器就会复位到关闭状态,回归正常的模式;但是如果这次RPC调用的尝试失败,熔断器就会返回到开启状态,一直等待到下次半开启状态。
- 分布式架构中的熔断器主要用于RPC接口上,为接口安装上“保险丝”,以防止RPC接口出现拥塞时导致系统压力过大而引起的系统瘫痪,当
-
【问】什么是 Hystrix?(延迟容错的组件)
-
Hystrix翻译过来是豪猪,由于豪猪身上长满了刺,因此能保护自己不受天敌的伤害,代表了一种防御机制。Hystrix开源框架是Netflix开源的一个延迟和容错的组件,主要用于在远程Provider服务异常时对消费端的RPC进行保护。 -
在分布式系统,我们一定会依赖各种服务,那么这些个服务一定会出现失败的情况,就会
导致雪崩
,
Hystrix就是这样的一个工具,
防雪崩利器,它具有服务降级,服务熔断,服务隔离,监控
等。
一些防止雪崩的技术。
Hystrix有四种防雪崩方式:
- 服务降级:接口调用失败就调用本地的方法返回一个空(或者是一个友好的提示信息)
- 服务熔断:接口调用失败就会进入调用接口提前定义好的一个熔断的方法,返回错误信息
- 服务隔离:隔离服务之间相互影响,通过
Hystrix为隔离的服务开启一个独立的线程池来实现 - 服务监控:在服务发生调用时,会将每秒请求数、成功请求数等运行指标记录下来(统计RPC接口调用的失败比例)。
有关Hystrix的详细资料,可参考其官方网站:https://github.com/Netflix/Hystrix
-
-
【问】谈谈服务雪崩效应(某个服务的宕机现象会蔓延到其他服务,导致雪崩;服务就是资源,有点类似死锁,)
-
雪崩效应是在大型互联网项目中,
当某个服务发生宕机
时,
调用这个服务的其他服务也会发生宕机
,大型项目的微服务之间的调用是互通的,这样就
会将服务的不可用逐步扩大到各个其他服务中
,从而使整个项目的服务容机崩溃发生雪崩效应的原因有以下几点
- 1)单个服务的代码存在bug;
- 2)请求访问量激增导致服务发生崩溃(如大型商城的枪红包,秒杀功能);
- 3)服务器的硬件故障也会导致部分服务不可用;
-
-
【问】在微服务中,如何保护服务?(服务隔离,服务降级,类似死锁的解决方法:及时释放资源)
- 一般使用使用
Hystrix框架,实现服务隔离来避免出现服务的雪崩效应,从而达到保护服务的效果。当微服务中,高并发的数据库访问量导致服务线程阻塞,使单个服务启机,服务的不可用会蔓延到其他服务,引起整体服务灾难性后果,使用服务降级能有效为不同的服务分配资源,一旦服务不可用则返回友好提示,不占用其他服务资源,从而避免单个服务崩溃引发整体服务的不可用。
- 一般使用使用
-
【问】服务雪崩效应产生的原因(Tomcat默认使用一个线程池处理所有请求)
因为
Tomcat默认情况下只有一个线程池来维护客户端发送的所有的请求,这时候某一接口在某一时刻被大量访问就会占据tomcat线程池中的所有线程,其他请求处于等待状态,无法连接到服务接口。 -
【问】谈谈服务降级、熔断、服务隔离
- 服务降级:当客户端请求服务器端的时候,防止客户端一直等待,不会处理业务逻辑代码,直接返回一个友好的提示给客户端。
- 服务熔断:在服务降级的基础上更直接的一种保护方式,当在一个统计时间范围内的请求失败数量达到设定值(
requestVolumeThreshold)或当前的请求错误率达到设定的错误率阀值(errorThresholdPercentage)时开启断路,之后的请求直接走fallback方法,在设定时间(sleepWindowlnMilliseconds)后尝试恢复。 - 服务隔离:是
Hystrix为隔离的服务开启一个独立的线程池,这样在高并发的情况下不会影响其他服务。服务隔离有线程池和信号量两种实现方式,一般使用线程池方式。
-
【问】服务降级底层是如何实现的?
Hystrix实现服务降级的功能是通过重写HystrixCommand中的getFallback()方法,当Hystrix的run方法或construct执行发生错误时转而执行getFallback()方法。
e)Zuul(微服务网关)
-
【问】什么是微服务网关?有什么作用?(作为网络服务架构的入口,用于统一解决
Provider路由、均衡负载、权限控制(用户身份认证);微服务网关(Nginx,Zuul,Spring Cloud Gateway)可以解决跨域问题),参考Spring Cloud 之 Zuul- 网关相当于一个网络服务架构的入口,所有网络请求必须通过网关转发到具体的服务。作用是统一管理微服务请求,权限控制、负载均衡、路由转发、监控、安全控制黑名单和白名单等。
- 在微服务分布式架构下,客户端(如浏览器)直接访问Provider服务提供者会存在以下问题:
- 客户端需要进行负载均衡,从多个Provider中挑选最合适的微服务提供者。
- 存在跨域请求时,服务端需要进行额外处理。
- 每个服务需要进行独立的用户认证。
- 解决以上问题的手段就是使用微服务网关。微服务网关是微服务架构中不可或缺的部分,它统一解决Provider路由、均衡负载、权限控制等功能。
微服务网关的功能如图所示:

-
【问】什么是Spring Cloud Zuul(服务网关),参考Spring Cloud 之 Zuul
-
Zuul是Netflix公司的开源网关产品,可以和Eureka、Ribbon、Hystrix等组件配合使用。 -
Zuul的规则引擎和过滤器基本上可以用任何JVM语言编写,内置支持Java和Groovy。在Spring Cloud框架中,Zuul的角色是网关,负责接收所有的REST请求(如网页端、App端等),然后进行内部转发,是微服务提供者集群的流量入口。将**
Zuul称为内部网关**,以便和Nginx外部网关相区分。 -
Zuul作为网关层,自身也是一个微服务,跟其他服务提供者一样都注册在Eureka Server上,可以相互发现。Zuul能感知到哪些Provider实例在线,同时通过配置路由规则可以将REST请求自动转发到指定的后端微服务提供者(Provider)。 -
Zuul是对SpringCloud提供的成熟的路由方案,他会根据请求的路径不同,网关会定位到指定的微服务,并代理请求到不同的微服务接口,他对外隐蔽了微服务的真正接口地址。三个重要概念:动态路由表,路由定位,反向代理:
- 动态路由表:Zuul支持
Eureka路由,手动配置路由,这俩种都支持自动更新 - 路由定位:根据请求路径,
Zuul有自己的一套定位服务规则以及路由表达式匹配 - 反向代理:客户端请求到路由网关,网关受理之后,在对目标发送请求,拿到响应之后在给客户端;
- 动态路由表:Zuul支持
-
Zuul的功能大致有:- 路由转发:将不同REST请求转发至不同的微服务提供者,其作用类似于Nginx的反向代理。同时,也起到了统一端口的作用,将很多微服务提供者的不同端口统一到了
Zuul的服务端口。 - 用户认证:网关直接暴露在公网上时,终端要调用某个服务,通常会把登录后的token(令牌)传过来,网关层对
token进行有效性验证。如果token无效(或没有token),就不允许访问REST服务。可以结合Spring Security中的认证机制完成Zuul网关的安全认证。 - 限流:高并发场景下瞬时流量不可预估,为了保证服务对外的稳定性,限流成为每个应用必备的一道安全防火墙。如果没有这道安全防火墙,那么请求的流量超过服务的负载能力时很容易造成整个服务的瘫痪。
- 负载均衡:在多个微服务提供者之间按照多种策略实现负载均衡(
ribbon实现了provider之间的负载均衡,是客户端负载均衡;而Zuul是对来自浏览器或App的REST请求进行负载均衡,是服务器端的负载均衡)??。
- 路由转发:将不同REST请求转发至不同的微服务提供者,其作用类似于Nginx的反向代理。同时,也起到了统一端口的作用,将很多微服务提供者的不同端口统一到了
-
Zuul的应用场景:- 对外暴露,权限校验,服务聚合,日志审计等
-
-
【问】网关与过滤器有什么区别(网关是对所有服务的请求进行分析过滤,过滤器是对单个服务而言)
-
【问】常用网关框架有那些?(Nginx 、 Zuul 、Spring Cloud Gateway)
-
【问】Zuul与Nginx有什么区别?(Zuul是内部网关,Nginx是外部网关;Zuul用Java实现,对网关操作更灵活)
Zuul是 java 语言实现的,主要为java服务提供网关服务,尤其在微服务架构中可以更加灵活的对网关进行操作。Nginx是使用 C 语言实现,性能高于Zuul,但是实现自定义操作需要熟悉 lua 语言,对程序员要求较高,可以使用Nginx做Zuul集群。
-
【问】如何设计一套API接口(内部API接口供内部服务器使用,外部API接口供外部合作单位使用)
考虑到 API 接口的分类可以将 API 接口分为开发 API 接口和内网 API 接口,内网 API 接口用于局域网,为内部服务器提供服务。开放API 接口用于对外部合作单位提供接口调用,需要遵循 Oauth2.0 权限认证协议。同时还需要考虑安全性、幂等性等问题。
-
【问】ZuulFilter常用有那些方法
Run():过滤器的具体业务逻辑shouldFilter():判断过滤器是否有效fifilterOrder():过滤器执行顺序fifilterType():过滤器拦截位置
-
【问】如何实现动态Zuul网关路由转发
- 通过 path 配置拦截请求,通过 ServiceId 到配置中心获取转发的服务列表,
Zuul内部使用Ribbon实现本地负载均衡和转发。
- 通过 path 配置拦截请求,通过 ServiceId 到配置中心获取转发的服务列表,
-
【问】Zuul网关如何搭建集群(使用
Nginx的upstream设置Zuul服务集群)- 使用
Nginx的upstream设置Zuul服务集群,通过location拦截请求并转发到upstream,默认使用轮询机制对Zuul集群发送请求。
- 使用
f)五大组件流程图
参考面试请不要再问我Spring Cloud底层原理,结合参考博客理解业务
Eureka:

Ribbon:

Feign:

Hystrix:

Zuul:

g)其他
- 【问】CAP理论(一致性Consistency(取舍:强一致性、单调一致性、会话一致性、最终一致性、弱一致性) ,可用性Availability,分区容错性Partition tolerance)

 navicat如何创建视图)

 和 equals()方法)


)

