十一月月底,宿舍楼失火啦,搞得20多天没有网,目测直到放假也不会来了。。。
正题
嗯~,其实阅读源码不是为了应付面试,更重要的让你知道,大师是怎样去写代码的,同样是用Java,为啥Clinton Begin写的叫源码,而你写只能叫代码。
最简单的入门代码:
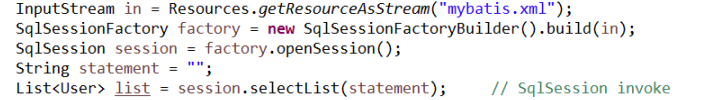
先读取配置文件流,然后构造个SqlSessionFactory,然后开启一个SqlSession,指定statement,调用查询方法,返回结果。那么,你知道他是怎样实现的吗
SqlSessionFactoryBuilder.build 方法
  public SqlSessionFactory build(InputStream inputStream, String environment, Properties properties) {try {XMLConfigBuilder parser = new XMLConfigBuilder(inputStream, environment, properties);return build(parser.parse());} catch (Exception e) {throw ExceptionFactory.wrapException("Error building SqlSession.", e);} finally {ErrorContext.instance().reset();try {inputStream.close();} catch (IOException e) {// Intentionally ignore. Prefer previous error.
      }}}
将输入流传入 XMLConfigBuilder 的构造方法来创建一个 XMLConfigBuilder 对象, 调用 XMLConfigBuilder 的parse 方法进行解析配置文件,返回一个 Configuration 对象
public SqlSessionFactory build(Configuration config) {return new DefaultSqlSessionFactory(config);}
将返回的 Configuration 对象传入另外一个重载的 build 方法,实际上是传入了 DefaultSqlSessionFactory 的构造方法,返回 sqlSessionFactory。
我比较关心的是 XMLConfigBuilder 的 parse 方法,都干了什么事情
首先进入 XMLConfigBuilder 的构造方法后, 真正使用配置文件输入流的是 XPathParser, 它是负责解析 XML文件元素节点的, 通俗地讲, XpathParser 负责将原料加工成零件, XMLConfigBuilder 负责按照工序组装零件成一个产品。
public XMLConfigBuilder(InputStream inputStream, String environment, Properties props) {this(new XPathParser(inputStream, true, props, new XMLMapperEntityResolver()), environment, props);}private XMLConfigBuilder(XPathParser parser, String environment, Properties props) {super(new Configuration());ErrorContext.instance().resource("SQL Mapper Configuration");this.configuration.setVariables(props);this.parsed = false;this.environment = environment;this.parser = parser;}
经过构造方法初始化好XPathParser后,就要进入parse方法了。Parse 方法里有个判断,如果已经解析过了,就会抛出异常,如果没解析,就将解析标志设为 true。接着调用parseConfiguration
public Configuration parse() {if (parsed) {throw new BuilderException("Each XMLConfigBuilder can only be used once.");}parsed = true;parseConfiguration(parser.evalNode("/configuration"));return configuration;}private void parseConfiguration(XNode root) {try {Properties settings = settingsAsPropertiess(root.evalNode("settings"));//issue #117 read properties firstpropertiesElement(root.evalNode("properties"));loadCustomVfs(settings);typeAliasesElement(root.evalNode("typeAliases"));pluginElement(root.evalNode("plugins"));objectFactoryElement(root.evalNode("objectFactory"));objectWrapperFactoryElement(root.evalNode("objectWrapperFactory"));reflectionFactoryElement(root.evalNode("reflectionFactory"));settingsElement(settings);// read it after objectFactory and objectWrapperFactory issue #631environmentsElement(root.evalNode("environments"));databaseIdProviderElement(root.evalNode("databaseIdProvider"));typeHandlerElement(root.evalNode("typeHandlers"));mapperElement(root.evalNode("mappers"));} catch (Exception e) {throw new BuilderException("Error parsing SQL Mapper Configuration. Cause: " + e, e);}}
parseConfiguration 就是工序图, 组装产品一定是按照一定顺序的, 所以这也是建造者模式的核心。
比如:第一个是全局设置 settings,第二个是属性文件,第三个是别名。在这里我们看 environmentsElement,
很明显它是来构建 Environment 的, 也就是我们配置的数据源信息。
private void environmentsElement(XNode context) throws Exception {if (context != null) {if (environment == null) {environment = context.getStringAttribute("default");}for (XNode child : context.getChildren()) {String id = child.getStringAttribute("id");if (isSpecifiedEnvironment(id)) {TransactionFactory txFactory = transactionManagerElement(child.evalNode("transactionManager")); // 构建事务工厂DataSourceFactory dsFactory = dataSourceElement(child.evalNode("dataSource")); // 构建数据源工厂DataSource dataSource = dsFactory.getDataSource();Environment.Builder environmentBuilder = new Environment.Builder(id).transactionFactory(txFactory).dataSource(dataSource);configuration.setEnvironment(environmentBuilder.build());}}}}
主要有两大块: transactionManagerElement 和 dataSourceElement。
private TransactionFactory transactionManagerElement(XNode context) throws Exception {if (context != null) {String type = context.getStringAttribute("type");Properties props = context.getChildrenAsProperties();TransactionFactory factory = (TransactionFactory) resolveClass(type).newInstance();factory.setProperties(props);return factory;}throw new BuilderException("Environment declaration requires a TransactionFactory.");}private DataSourceFactory dataSourceElement(XNode context) throws Exception {if (context != null) {String type = context.getStringAttribute("type");Properties props = context.getChildrenAsProperties();DataSourceFactory factory = (DataSourceFactory) resolveClass(type).newInstance();factory.setProperties(props);return factory;}throw new BuilderException("Environment declaration requires a DataSourceFactory.");}
注意看: resolveClass(type).newInstance(), 这不就是反射吗?
而那个 type 则是我们配置文件里面配置的,比如 jdbc 或是 manage, 对应 JdbcTransactionFactory 和 ManagedTransactionFactory。
Upooled 和 Pooled对应 UnpooledDataSourceFactory 和 PooledDataSourceFactory。
返回 environmentsElement 方法, 我们还看到 Environment 有个 Builder 类, 准确来说是静态内部类。
Environment.Builder environmentBuilder = new Environment.Builder(id).transactionFactory(txFactory).dataSource(dataSource);configuration.setEnvironment(environmentBuilder.build());
具体的Environment类:
public final class Environment {private final String id;private final TransactionFactory transactionFactory;private final DataSource dataSource;public Environment(String id, TransactionFactory transactionFactory, DataSource dataSource) {if (id == null) {throw new IllegalArgumentException("Parameter 'id' must not be null");}if (transactionFactory == null) {throw new IllegalArgumentException("Parameter 'transactionFactory' must not be null");}this.id = id;if (dataSource == null) {throw new IllegalArgumentException("Parameter 'dataSource' must not be null");}this.transactionFactory = transactionFactory;this.dataSource = dataSource;}public static class Builder {private String id;private TransactionFactory transactionFactory;private DataSource dataSource;public Builder(String id) {this.id = id;}public Builder transactionFactory(TransactionFactory transactionFactory) {this.transactionFactory = transactionFactory;return this;}public Builder dataSource(DataSource dataSource) {this.dataSource = dataSource;return this;}public String id() {return this.id;}public Environment build() {return new Environment(this.id, this.transactionFactory, this.dataSource);}}public String getId() {return this.id;}public TransactionFactory getTransactionFactory() {return this.transactionFactory;}public DataSource getDataSource() {return this.dataSource;}}
那么这里有一个设计模式的问题。为什么Environment里面要搞一个Builder类呢?直接使用构造方法不也可以达到相同的目的吗?
1. 首先, 用内部类是因为内部类与外部类有一定的关系, 往往只有该外部类调用此内部类。 静态内部类
只能访问静态的成员变量和方法,不能访问非静态变量的方法。但是普通内部类可以访问任意外部类
的成员变量和方法。静态内部类可以声明普通成员变量和方法,但是普通内部类不能声明 static 变量
或方法。
静态内部类: Inner I = new Outer.Inner();
普通内部类: Outer o = new Outer(); Inner I = o.new Inner();
2. 另外, 静态都是用来修饰类的内部成员的, 比如静态方法, 静态成员变量。 静态方法不能访问非静态
变量和非静态方法。 Static 不能修饰局部变量。
3. 总结:如果类的构造函数有多个参数,设计这样的类时, 最好使用 Builder 模式, 特别是大多数参数
都是可选的时候。如果现在不能确定参数的个数,最好一开始就使用建造者模式。
到此,SqlSessionFactoryBuilder.build方法的作用是:解析配置文件,构建唯一的Configuration对象,构建全局唯一并且线程安全的SqlSessionFactory。
SqlSessionFactory的openSession方法
进入openSession方法
@Overridepublic SqlSession openSession() {return openSessionFromDataSource(configuration.getDefaultExecutorType(), null, false);}
会发现它调用的是另外一个方法。
private SqlSession openSessionFromDataSource(ExecutorType execType, TransactionIsolationLevel level, boolean autoCommit) {Transaction tx = null;try {final Environment environment = configuration.getEnvironment();final TransactionFactory transactionFactory = getTransactionFactoryFromEnvironment(environment);tx = transactionFactory.newTransaction(environment.getDataSource(), level, autoCommit);final Executor executor = configuration.newExecutor(tx, execType);return new DefaultSqlSession(configuration, executor, autoCommit);} catch (Exception e) {closeTransaction(tx); // may have fetched a connection so lets call close()throw ExceptionFactory.wrapException("Error opening session. Cause: " + e, e);} finally {ErrorContext.instance().reset();}}
看try块第一行,获得的Environment是前面由XMLConfigBuilder装配到Configuration里面的。第二三行的事务工厂和数据源都是在解析配置文件期间装配到Environment里面的。
到第四行,这是个新东西Executor,简单来说它是真正执行CRUD操作的工具,给我们提供的SqlSession仅仅是个用户接口。Executor也是由Configuration对象来创建的,可见Configuration是多么重要。
我们知道事务操作必不可少,所以Executor的创建必须有Transaction对象。
第五行,就是创建SqlSession了,DefaultSqlSession是一个具体实现类。我们可以看到它把Executor传进去了,那么就不难发现,SqlSession不过是件衣裳。
接下来看SqlSession调用过程
调用 SqlSession 的 selectList 方法
先看selectOne方法
@Overridepublic <T> T selectOne(String statement, Object parameter) {// Popular vote was to return null on 0 results and throw exception on too many.List<T> list = this.<T>selectList(statement, parameter);if (list.size() == 1) {return list.get(0);} else if (list.size() > 1) {throw new TooManyResultsException("Expected one result (or null) to be returned by selectOne(), but found: " + list.size());} else {return null;}}
看到这句话没
this.<T>selectList(statement, parameter);
我们调用返回一条数据的方法,实际上也是调用selectList,现在看selectList:多个重载方法我就不全部贴了
@Overridepublic <E> List<E> selectList(String statement, Object parameter, RowBounds rowBounds) {try {MappedStatement ms = configuration.getMappedStatement(statement);return executor.query(ms, wrapCollection(parameter), rowBounds, Executor.NO_RESULT_HANDLER);} catch (Exception e) {throw ExceptionFactory.wrapException("Error querying database. Cause: " + e, e);} finally {ErrorContext.instance().reset();}}
MappedStatement你可以理解为你配置文件里面写的sql语句的映射,比如:

同样,这个对象也来自Configuration。接着看,return的是Executor的query方法,ms作为参数。Executor有多个实现类,BaseExecutor是最基础的实现,来看其中的query实现:
@Overridepublic <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException {BoundSql boundSql = ms.getBoundSql(parameter);CacheKey key = createCacheKey(ms, parameter, rowBounds, boundSql);return query(ms, parameter, rowBounds, resultHandler, key, boundSql);}
第一行,从ms里面获得绑定的sql语句,脑袋是不是跟配置产生一点联系了?第二行不需要管,看第三行的实现:
  @SuppressWarnings("unchecked")@Overridepublic <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql) throws SQLException {ErrorContext.instance().resource(ms.getResource()).activity("executing a query").object(ms.getId());if (closed) {throw new ExecutorException("Executor was closed.");}if (queryStack == 0 && ms.isFlushCacheRequired()) {clearLocalCache();}List<E> list;try {queryStack++;list = resultHandler == null ? (List<E>) localCache.getObject(key) : null;if (list != null) {handleLocallyCachedOutputParameters(ms, key, parameter, boundSql);} else {list = queryFromDatabase(ms, parameter, rowBounds, resultHandler, key, boundSql);}} finally {queryStack--;}if (queryStack == 0) {for (DeferredLoad deferredLoad : deferredLoads) {deferredLoad.load();}// issue #601
      deferredLoads.clear();if (configuration.getLocalCacheScope() == LocalCacheScope.STATEMENT) {// issue #482
        clearLocalCache();}}return list;}
当查询的时候先从缓存中找,如果找不到就从数据库中找,这里我们看
list = queryFromDatabase(ms, parameter, rowBounds, resultHandler, key, boundSql);
private <E> List<E> queryFromDatabase(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql) throws SQLException {List<E> list;localCache.putObject(key, EXECUTION_PLACEHOLDER);try {list = doQuery(ms, parameter, rowBounds, resultHandler, boundSql);} finally {localCache.removeObject(key);}localCache.putObject(key, list);if (ms.getStatementType() == StatementType.CALLABLE) {localOutputParameterCache.putObject(key, parameter);}return list;}
这句是关键:
list = doQuery(ms, parameter, rowBounds, resultHandler, boundSql);
在BaseExecutor里面有定义
protected abstract <E> List<E> doQuery(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql)throws SQLException;
它是需要子类去实现。总共有三种:BatchExecutor,ReuseExecutor,SimpleExecutor。这里我们选择SimpleExecutor:
@Overridepublic <E> List<E> doQuery(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, BoundSql boundSql) throws SQLException {Statement stmt = null;try {Configuration configuration = ms.getConfiguration();StatementHandler handler = configuration.newStatementHandler(wrapper, ms, parameter, rowBounds, resultHandler, boundSql);stmt = prepareStatement(handler, ms.getStatementLog());return handler.<E>query(stmt, resultHandler);} finally {closeStatement(stmt);}}
这里说一句题外话:到处都需要Configuration,它无疑是mybatis运行期间的核心。
StatementHandler是对java.sql.Statement的封装处理,有三个实现类:CallableStatementHandler,PreparedStatementHandler,SimpleStatementHandler。
同样,利用Configuration来创建一个StatementHandler实例,之后利用这个handler来创建一个java.sql.statement,最后调用handler的<E>query方法,利用原生的Statement来执行查询操作。
PreparedStatementHandler.query方法
@Overridepublic <E> List<E> query(Statement statement, ResultHandler resultHandler) throws SQLException {PreparedStatement ps = (PreparedStatement) statement;ps.execute();return resultSetHandler.<E> handleResultSets(ps);}
前两行都应该知道,类型转换以及执行jdbc的查询。最后一行是利用原生的PreparedStatement来进行结果集的封装。ResultSetHandler有个默认实现类:DefaultResultSetHandler,具体就不在分析了。
到此为止,返回结果集到最上层,显示给用户。
先写这些吧,写的不是特别满意,望指教~


