【PyTorch】模型选择、欠拟合和过拟合

文章目录

  • 1. 理论介绍
  • 2. 实例解析
    • 2.1. 实例描述
    • 2.2. 代码实现
      • 2.2.1. 完整代码
      • 2.2.2. 输出结果

1. 理论介绍

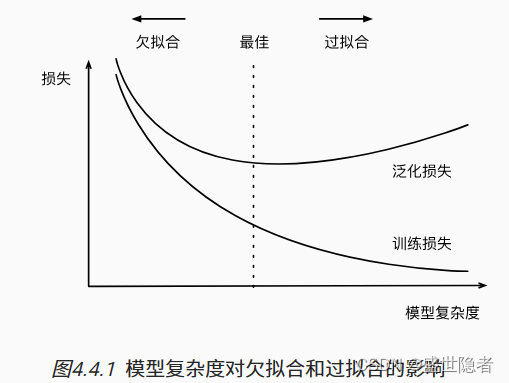
  • 将模型在训练数据上拟合的比在潜在分布中更接近的现象称为过拟合, 用于对抗过拟合的技术称为正则化。
  • 训练误差和验证误差都很严重, 但它们之间差距很小。 如果模型不能降低训练误差,这可能意味着模型过于简单(即表达能力不足),无法捕获试图学习的模式。 这种现象被称为欠拟合。
  • 训练误差是指模型在训练数据集上计算得到的误差。
  • 泛化误差是指模型应用在同样从原始样本的分布中抽取的无限多数据样本时,模型误差的期望。我们永远不能准确地计算出泛化误差,在实际中,我们只能通过将模型应用于一个独立的测试集来估计泛化误差, 该测试集由随机选取的、未曾在训练集中出现的数据样本构成。
  • 影响模型泛化的因素
    • 可调整参数的数量。当可调整参数的数量(有时称为自由度)很大时,模型往往更容易过拟合。
    • 参数采用的值。当权重的取值范围较大时,模型可能更容易过拟合。
    • 训练样本的数量。即使模型很简单,也很容易过拟合只包含一两个样本的数据集,而过拟合一个有数百万个样本的数据集则需要一个极其灵活的模型。
  • 在机器学习中,我们通常在评估几个候选模型后选择最终的模型。 这个过程叫做模型选择。候选模型可能在本质上不同,也可能是不同的超参数设置下的同一类模型。
  • 为了确定候选模型中的最佳模型,我们通常会使用验证集。验证集与测试集十分相似,唯一的区别是验证集是用于确定最佳模型,测试集是用于评估最终模型的性能。
  • K K K折交叉验证:当训练数据稀缺时,将原始训练数据分成 K K K个不重叠的子集。 然后执行 K K K次模型训练和验证,每次在 ( K − 1 ) (K-1) (K−1)个子集上进行训练, 并在剩余的一个子集(在该轮中没有用于训练的子集)上进行验证。 最后,通过对 K K K次实验的结果取平均来估计训练和验证误差。
  • 引起过拟合的因素
    • 模型复杂度
      模型复杂度
    • 数据集大小
      • 训练数据集中的样本越少,我们就越有可能(且更严重地)过拟合。
      • 给出更多的数据,拟合更复杂的模型可能是有益的; 如果没有足够的数据,简单的模型可能更有用。

2. 实例解析

2.1. 实例描述

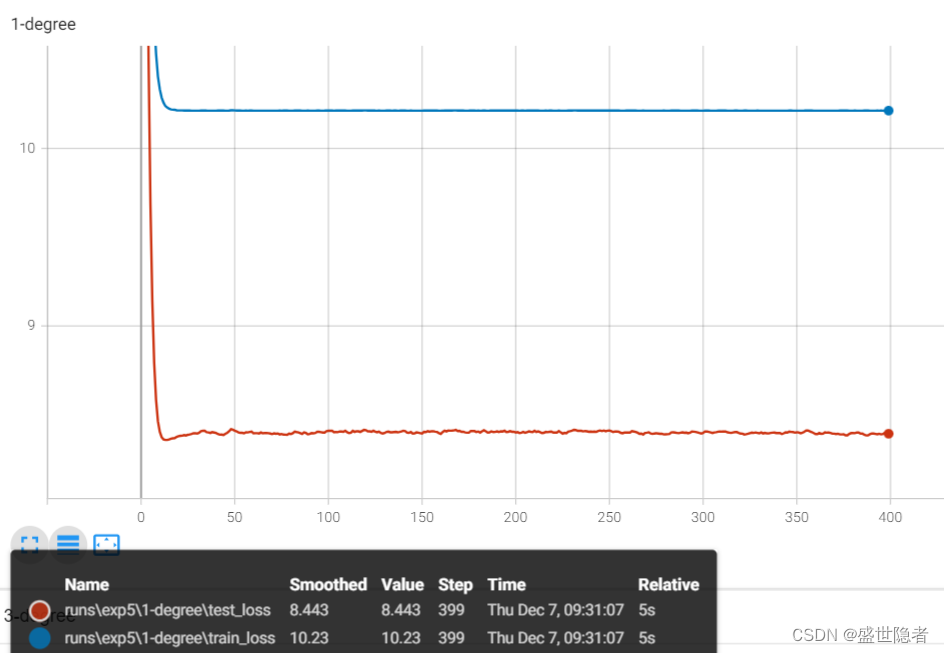
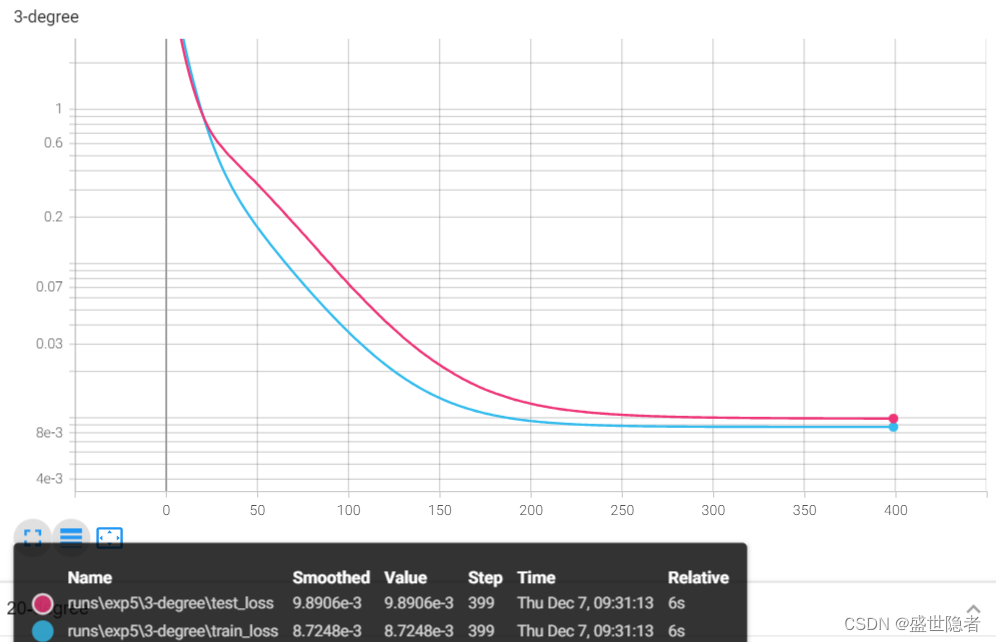
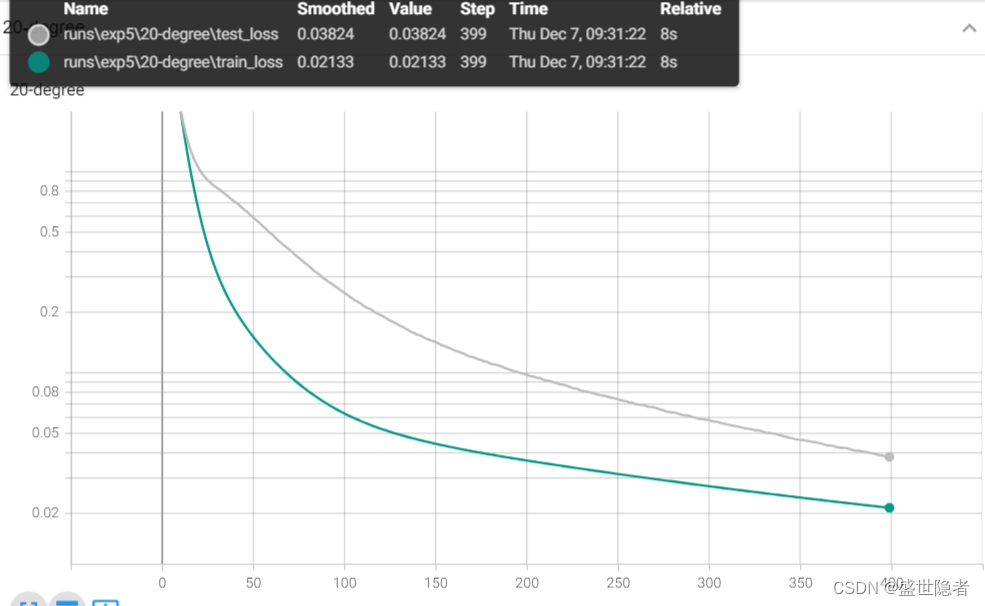
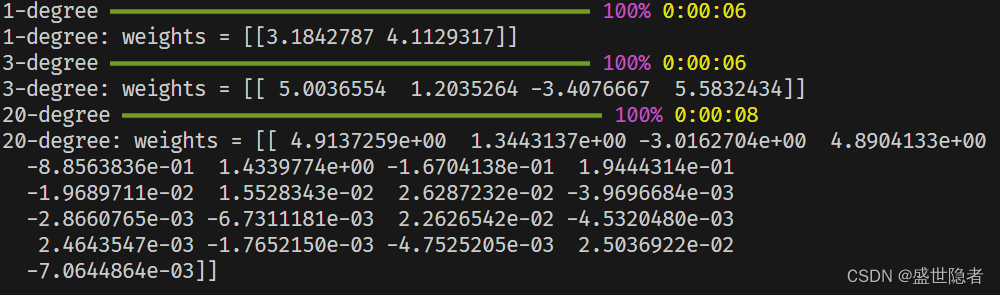
使用以下三阶多项式来生成训练和测试数据 y = 5 + 1.2 x − 3.4 x 2 2 ! + 5.6 x 3 3 ! + ϵ where  ϵ ∼ N ( 0 , 0. 1 2 ) . y = 5 + 1.2x - 3.4\frac{x^2}{2!} + 5.6 \frac{x^3}{3!} + \epsilon \text{ where } \epsilon \sim \mathcal{N}(0, 0.1^2). y=5+1.2x−3.42!x2​+5.63!x3​+ϵ where ϵ∼N(0,0.12).并用1阶(线性模型)、3阶、20阶多项式拟合。

2.2. 代码实现

2.2.1. 完整代码

import os
import numpy as np
import math, torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from tensorboardX import SummaryWriter
from rich.progress import trackdef evaluate_loss(dataloader, net, criterion):"""评估模型在指定数据集上的损失"""num_examples = 0loss_sum = 0.0with torch.no_grad():for X, y in dataloader:X, y = X.cuda(), y.cuda()loss = criterion(net(X), y)num_examples += y.shape[0]loss_sum += loss.sum()return loss_sum / num_examplesdef load_dataset(*tensors):"""加载数据集"""dataset = TensorDataset(*tensors)return DataLoader(dataset, batch_size, shuffle=True)if __name__ == '__main__':# 全局参数设置num_epochs = 400batch_size = 10learning_rate = 0.01# 创建记录器def log_dir():root = "runs"if not os.path.exists(root):os.mkdir(root)order = len(os.listdir(root)) + 1return f'{root}/exp{order}'writer = SummaryWriter(log_dir())# 生成数据集max_degree = 20             # 多项式最高阶数n_train, n_test = 100, 100  # 训练集和测试集大小true_w = np.zeros(max_degree+1)true_w[0:4] = np.array([5, 1.2, -3.4, 5.6])features = np.random.normal(size=(n_train + n_test, 1))np.random.shuffle(features)poly_features = np.power(features, np.arange(max_degree+1).reshape(1, -1))for i in range(max_degree+1):poly_features[:, i] /= math.gamma(i + 1)  # gamma(n)=(n-1)!labels = np.dot(poly_features, true_w)labels += np.random.normal(scale=0.1, size=labels.shape)    # 加高斯噪声服从N(0, 0.01)poly_features, labels = [torch.as_tensor(x, dtype=torch.float32) for x in [poly_features, labels.reshape(-1, 1)]]def loop(model_degree):# 创建模型net = nn.Linear(model_degree+1, 1, bias=False).cuda()nn.init.normal_(net.weight, mean=0, std=0.01)criterion = nn.MSELoss(reduction='none')optimizer = torch.optim.SGD(net.parameters(), lr=learning_rate)# 加载数据集dataloader_train = load_dataset(poly_features[:n_train, :model_degree+1], labels[:n_train])dataloader_test = load_dataset(poly_features[n_train:, :model_degree+1], labels[n_train:])# 训练循环for epoch in track(range(num_epochs), description=f'{model_degree}-degree'):for X, y in dataloader_train:X, y = X.cuda(), y.cuda()loss = criterion(net(X), y)optimizer.zero_grad()loss.mean().backward()optimizer.step()writer.add_scalars(f"{model_degree}-degree", {"train_loss": evaluate_loss(dataloader_train, net, criterion),"test_loss": evaluate_loss(dataloader_test, net, criterion),}, epoch)print(f"{model_degree}-degree: weights =", net.weight.data.cpu().numpy())for model_degree in [1, 3, 20]:loop(model_degree)writer.close()

2.2.2. 输出结果
权重

  • 采用1阶多项式(线性模型)拟合
    1
  • 采用3阶多项式拟合
    3
  • 采用20阶多项式拟合
    20

本文来自互联网用户投稿,该文观点仅代表作者本人,不代表本站立场。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如若转载,请注明出处:http://www.tpcf.cn/news/204510.html

如若内容造成侵权/违法违规/事实不符,请联系多彩编程网进行投诉反馈email:809451989@qq.com,一经查实,立即删除!

相关文章

跨地域组网挑战之如何实现数据传输无缝连接?

全球化是当今商业领域的主要趋势,许多行业都迅速扩展到跨国和跨地区运营。软件开发领域也不例外,为了利用全球资源和降低成本,越来越多的软件开发公司将团队分布在不同地理位置,而这也面临着实时回传开发数据至总部服务器的企业组…

要求CHATGPT高质量回答的艺术:提示工程技术的完整指南—第 7 章:让我们想一想 提示语

要求CHATGPT高质量回答的艺术:提示工程技术的完整指南—第 7 章:"让我们想一想 "提示语 让我们想一想 "提示语是一种用于鼓励 ChatGPT 生成具有反思性和沉思性文字的技巧。 让我们想一想 "提示语的提示公式是 “让我们想一想”&am…

【C++】Boost库LexicalCast模块介绍与使用

Boost库LexicalCast模块 文章目录 Boost库LexicalCast模块介绍使用基础API自定义类型转换 介绍 lexical_cast库进行”字面值“之间的通用转换 头文件 #include<boost/lexical_cast.hpp>使用 基础API lexical_cast boost::lexical_cast可以在各种基本类型中转换 #i…

计算两个结构的差

平面上有6个点&#xff0c;以6a1的方式运动 1 1 1 1 - - - 1 - - - 1 现在有一个点逃逸&#xff0c;剩下的5个点将如何运动&#xff1f; 2 2 2 3 - - - 3 - - - 3 将6a1的6个点减去1个点&#xff0c;只有两种可能&#xff0c;或者变成5a2&#xff0c…

SpringBoot的配置加载优先级

目录 一、背景分析 二、学习资源 三、具体使用 四、一些小技巧 方式一 方式二 一、背景分析 SpringBoot项目在打包之后&#xff0c;其配置文件就在jar包内&#xff0c;如果没有<配置文件优先级>这个机制&#xff0c;那么项目打成jar包之后&#xff0c;如果启动项目…

视频监控管理平台/智能监测/检测系统EasyCVR智能地铁监控方案,助力地铁高效运营

近日&#xff0c;关于全国44座城市开通地铁&#xff0c;却只有5座城市赚钱的新闻冲上热搜。地铁作为城市交通的重要枢纽&#xff0c;是人们出行必不可少的一种方式&#xff0c;但随着此篇新闻的爆出&#xff0c;大家也逐渐了解到城市运营的不易&#xff0c;那么&#xff0c;如何…

HTML 块级元素与行内元素有哪些以及注意、总结

行内元素和块级元素是HTML中的两种元素类型&#xff0c;它们在页面中的显示方式和行为有所不同。 块级元素&#xff08;Block-level Elements&#xff09;&#xff1a; 常见的块级元素有div、p、h1-h6、ul、ol、li、table、form等。 块级元素会独占一行&#xff0c;即使没有…

Linux下超轻量级Rust开发环境搭建:一、安装Rust

Rust语言在国内逐步开始流行&#xff0c;但开发环境的不成熟依然困扰不少小伙伴。 结合我个人的使用体验&#xff0c;推荐一种超轻量级的开发环境&#xff1a;Rust Helix Editor。运行环境需求很低&#xff0c;可以直接在Linux终端里进行代码开发。对于工程不是太过庞大的Rus…

目标检测——SPPNet算法解读

论文&#xff1a;Spatial Pyramid Pooling in Deep Convolutional Networks for Visual Recognition 作者&#xff1a;Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun 链接&#xff1a;https://arxiv.org/abs/1406.4729 目录 1、算法概述2、Deep Networks with Spatia…

share pool的组成

share pool的组成 3块区域&#xff1a;free,library cache,row cache 通过查看v$librarycache视图&#xff0c;可以监控library cache的活动情况&#xff0c;进一步衡量share pool设置是否合理; 其中reloads列&#xff0c;表示对象被重新加载的次数&#xff0c;在一个设置合…

代码随想录算法训练营第30天|● 332.重新安排行程 ● 51. N皇后 ● 37. 解数独 ● 总结

332. 重新安排行程 困难 相关标签 相关企业 给你一份航线列表 tickets &#xff0c;其中 tickets[i] [from(i), to(i)] 表示飞机出发和降落的机场地点。请你对该行程进行重新规划排序。 所有这些机票都属于一个从 JFK&#xff08;肯尼迪国际机场&#xff09;出发的先生&#…

logback日志打印操作人

logback日志打印操作人 自定义拦截器 package com.demo.dv.net.config;import com.demo.dv.net.common.domain.UserInfo; import com.demo.dv.net.common.utils.CurrentUserUtil; import org.slf4j.MDC; import org.springframework.stereotype.Component; import org.spring…

适用于 Windows 的 10 个顶级分区管理器软件

您想要对硬盘驱动器或 USB 驱动器进行分区的原因可能有多种。许多用户希望对其外部和内部硬盘驱动器进行分区以有效地管理数据。为了处理分区&#xff0c;Windows为用户提供了一个内置的分区管理工具。 Windows 用户可以通过磁盘管理面板对任何驱动器进行分区。然而&#xff0…

哪种超声波清洗眼镜不伤镜片?超声波什么牌子好?眼镜清洗机推荐

戴眼镜的朋友就能够感同身受&#xff0c;眼镜佩戴一天真的特别容易脏&#xff0c;灰尘或者是脸部出汗出油等&#xff0c;让耳机惨不忍睹&#xff01;对于眼镜清洗的方式也有很多种&#xff0c;那么到底哪种清洗方式才是真正有效果并且不伤眼镜的呢&#xff1f;跟随笔者的脚步来…

电商控制台系统商品模块的处理

电商项目&#xff08;前台&#xff09;&#xff1a; 登陆 注册&#xff08;安全&#xff0c;网页版&#xff09; &#xff08;审核机制&#xff09; 外部功能&#xff1a; check审核机制 Uncheck未通过机制 findUserByCheck()一条一条展示用户 findUser() 批量获取用户(分页…

安装Kuboard管理K8S集群

目录 第一章.安装Kuboard管理K8S集群 1.安装kuboard 2.绑定K8S集群&#xff0c;完成信息设定 3.内网安装 第二章.kuboard-spray安装K8S 2.1.先拉镜像下来 2.2.之后打开后&#xff0c;先熟悉功能&#xff0c;注意版本 2.3.打开资源包管理&#xff0c;选择符合自己服务器…

Flowable 7.0.0 release发布

更多nbcio-boot功能请看演示系统 gitee源代码地址 后端代码&#xff1a; https://gitee.com/nbacheng/nbcio-boot 前端代码&#xff1a;https://gitee.com/nbacheng/nbcio-vue.git 在线演示&#xff08;包括H5&#xff09; &#xff1a; http://122.227.135.243:9888 更多…

Python-Opencv图像处理的小坑

1.背景 最近在做一点图像处理的事情&#xff0c;在做处理时的cv2遇到一些小坑&#xff0c;希望大家遇到的相关的问题可以注意&#xff01;&#xff01; 2. cv2.imwrite保存图像 cv2.imwrite(filename, img, [params]) filename&#xff1a;需要写入的文件名&#xff0c;包括路…

快速排序并不难

快速排序的核心框架是“二叉树的前序遍历对撞型双指针”。我们在《一维数组》一章提到过”双指针思路“&#xff1a;在处理奇偶等情况时会使用两个游标&#xff0c;一个从前向后&#xff0c;一个是从后向前来比较&#xff0c;根据结果来决定继续移动还是停止等待。快速排序的每…

医院信息系统源码,采用JAVA编程,支持跨平台部署应用,满足一级综合医院(专科二级及以下医院500床)的日常业务应用

医院HIS系统源码&#xff0c;HIS系统全套源码&#xff0c;支持电子病历4级&#xff0c;自主版权 his医院信息系统内设门诊/住院医生工作站、门诊/住院护士工作站。各工作站主要功能依据职能要求进行研发。如医生工作站主要功能为编辑电子病历、打印、处理医嘱&#xff1b;护士工…