内存数据库 Redis7—— Redis 基本命令
- 三、Redis 基本命令(下)
- 3.8 benchmark 测试工具
- 3.9 简单动态字符串SDS
- 3.10 集合的底层实现原理
- 3.11 BitMap 操作命令
- 3.12 HyperLogLog 操作命令
- 3.13 Geospatial 操作命令
- 3.14 发布/订阅命令
- 3.15 Redis 事务
- 四、Redis 持久化
- 五、Redis 主从集群
- 六、Redis 分布式系统
- 七、Redis 缓存
- 八、Lua脚本详解
- 九、分布式锁
数据库系列文章:
关系型数据库:
- MySQL —— 基础语法大全
- MySQL —— 进阶
非关系型数据库:
- Redis 的安装与配置
三、Redis 基本命令(下)
3.8 benchmark 测试工具
⭐️ 3.8.1、简介
在Redis 安装完毕后会自动安装一个 redis-benchmark 测试工具,其是一个压 力测试工具,用于测试 Redis 的性能。
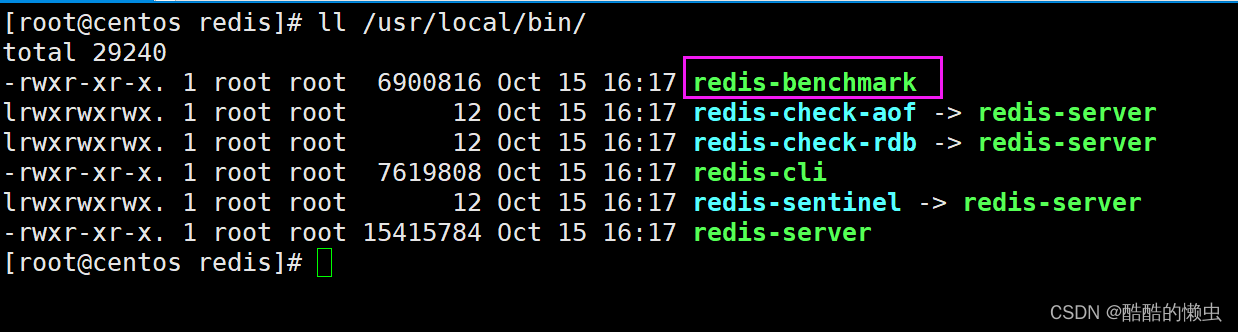
通过 redis-benchmark --help 命令可以查看到其用法:

- 其选项 options 非常多,下面通过例子来学习常用的 options 的用法。
⭐️ 3.8.2、测试1
(1) 命令解析
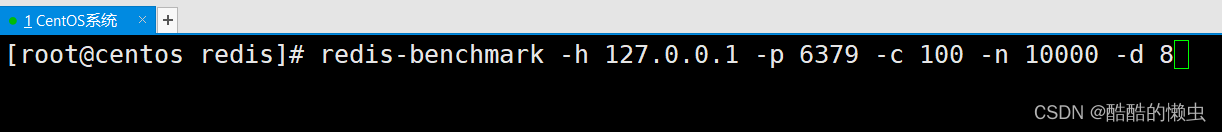
以上命令中选项的意义:
-h:指定要测试的 Redis 的IP,若为本机,则可省略-p:指定要测试的 Redis 的port,若为6379,则可省略-c:指定模拟有客户端的数量,默认值为50-n:指定这些客户端发出的请求的总量,默认值为100000-d:指定测试get/set命令时其操作的value的数据长度,单位字节,默认值为3。在测试其它命令时该指定没有用处。
以上命令的意义是,使用 100 个客户端连接该 Redis ,这些客户端总共会发起 100000个请求,
set/get的value为 8 字节数据。
(2) 测试结果分析
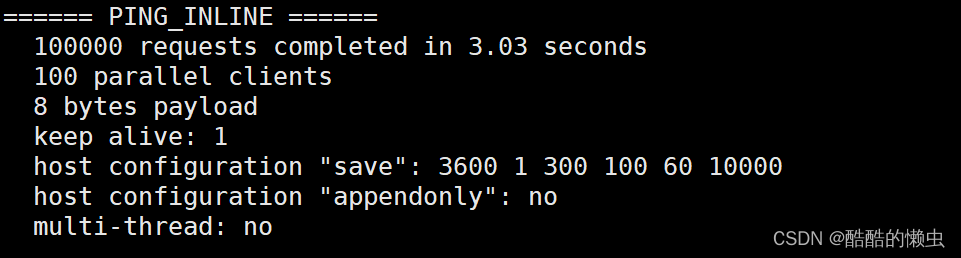
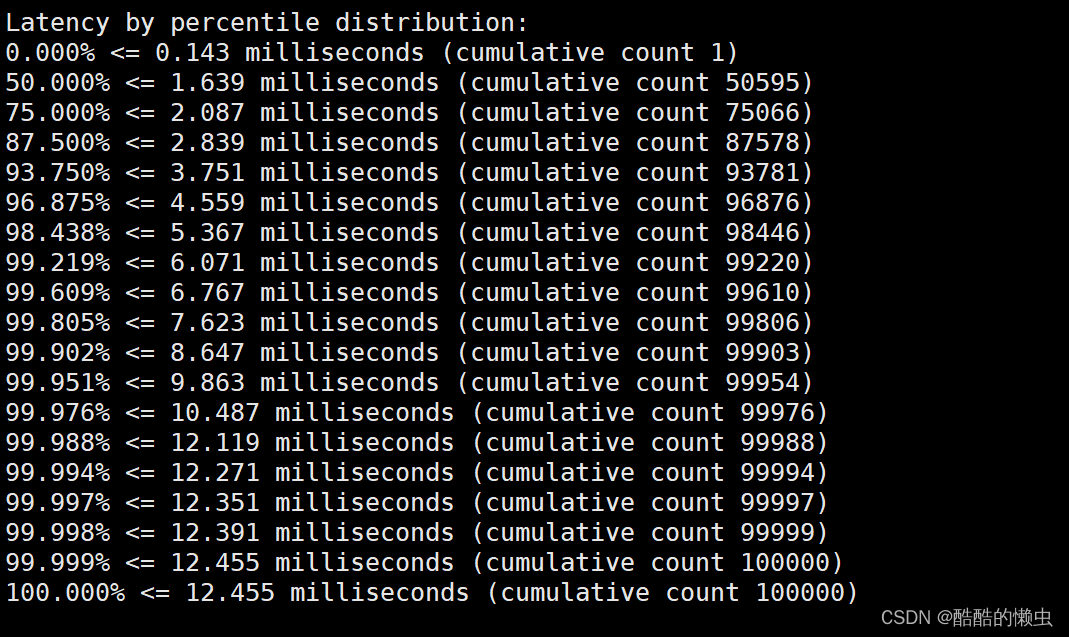
该命令会逐个测试所有Redis 命令,每个命令都会给出一份测试报告,每个测试报告由四部分构成:
A、 测试环境报告
- 首先就是测试环境:
B、 延迟百分比分布
- 这是按照百分比进行的统计报告:每完成一次剩余测试量的
50%就给出一个统计数据。
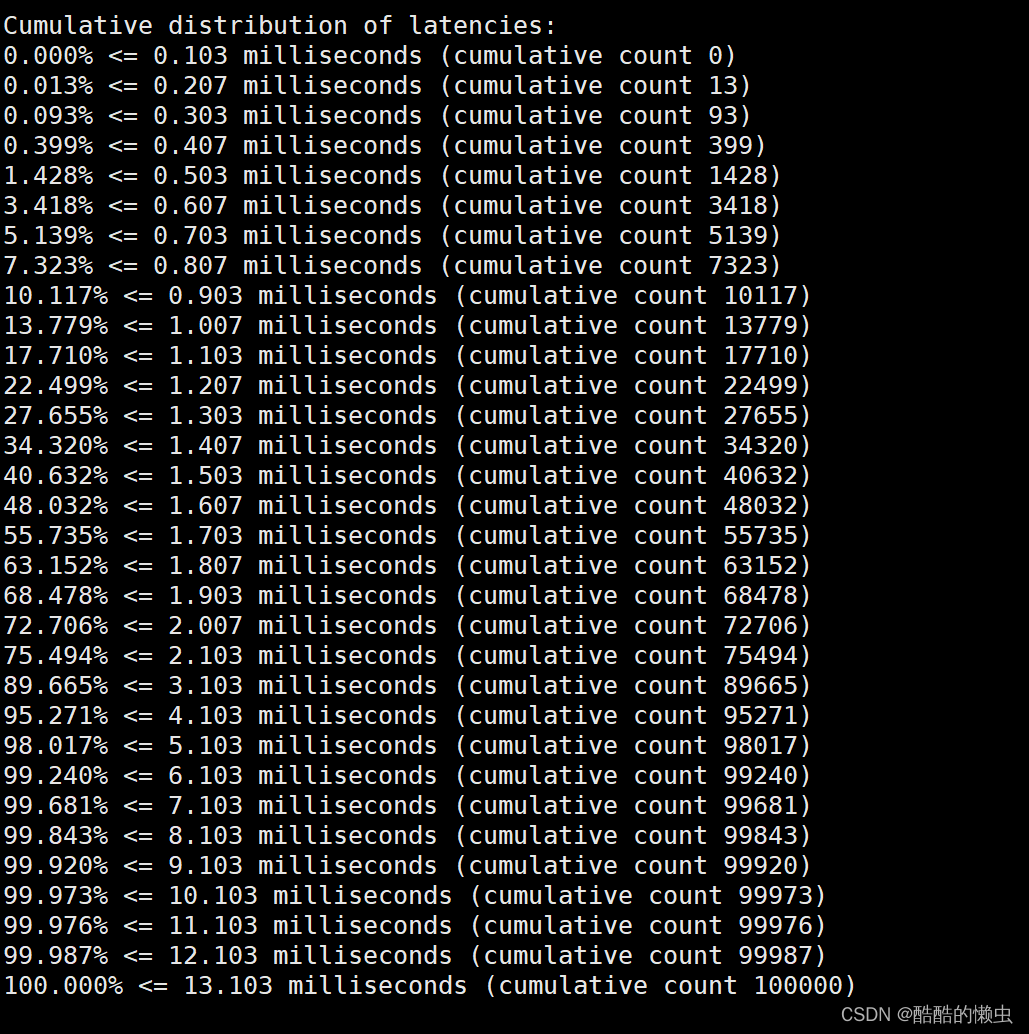
C、 延迟的累积分布
- 这是按照时间间隔统计的报告:基本是每
0.1毫秒统计一次。
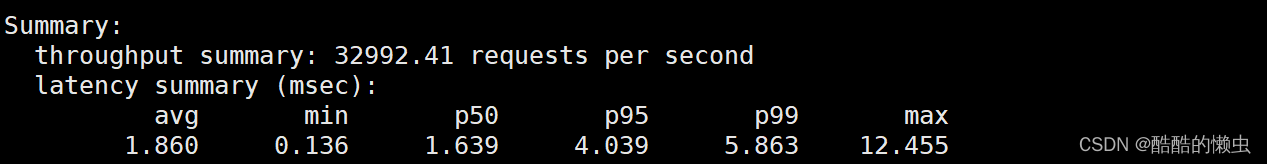
D、 总述报告
- 这是总述性报告。
⭐️ 3.8.3、测试2
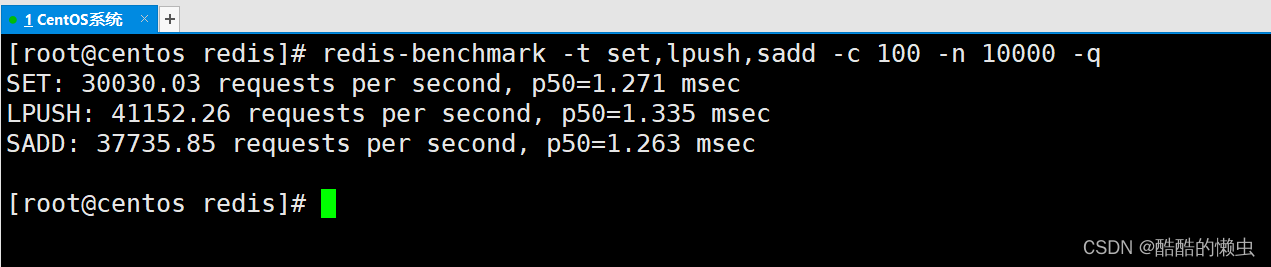
以上命令中选项的意义:
-t:指定要测试的命令,多个命令使用逗号分隔,不能有空格-q:指定仅给出总述性报告
3.9 简单动态字符串SDS
⭐️ 3.9.1、SDS简介
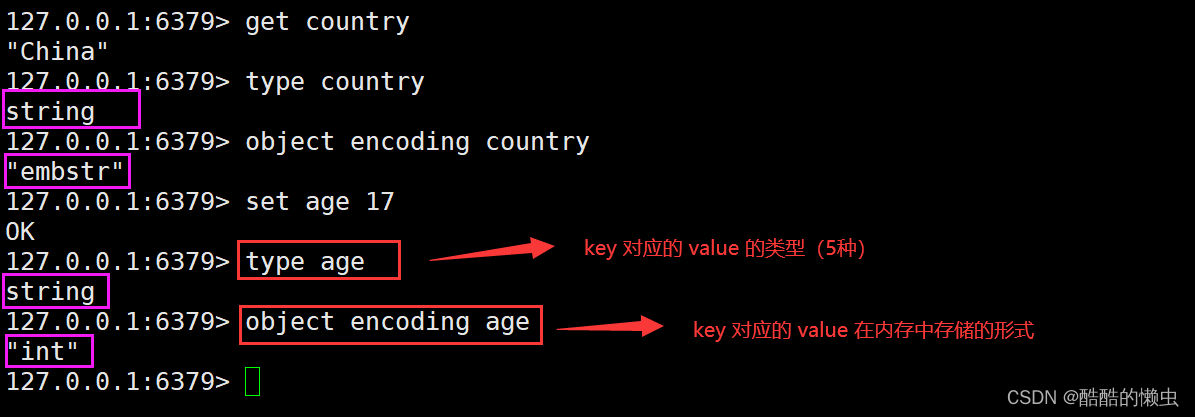
无论是Redis 的 Key 还是 Value ,其基础数据类型都是字符串。例如 Hash 型 Value 的field 与 value 的类型、 List 型、 Set 型、 ZSet 型 Value 的元素的类型等都是字符串。虽然 Redis是使用标准 C 语言开发的,但并没有直接使用 C 语言中传统的字符串表示,而是自定义了一种字符串。这种字符串本身的结构比较简单,但功能却非常强大,称为 简单动态字符串,Simple Dynamic String ,简称 SDS 。
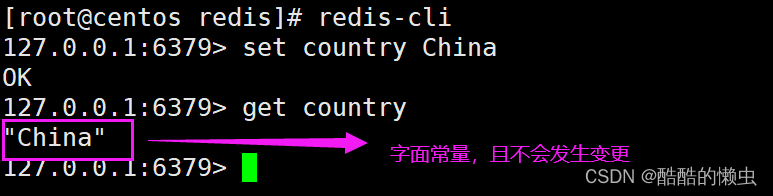
注意,Redis 中的所有字符串并不都是 SDS ,也会出现 C 字符串。 C 字符串只会出现在字符串 “字面常量” 中,并且 该字符串不可能发生变更。
redisLog(REDIS_WARNNING, "sdfsfsafsafds");
⭐️ 3.9.2、SDS结构
SDS不同于 C 字符串。 C 字符串本身是一个以双引号括起来,以空字符 '\0' 结尾的字符序列。但 SDS 是一个结构体,定义在 Redis 安装目录下的 src/sds.h 中:
struct sdshdr {//字节数组,用于保存字符串char buf[];// buf[]中已使用字节数量,称为 SDS 的长度int len;// buf[]中尚未使用的字节数量int free;
}
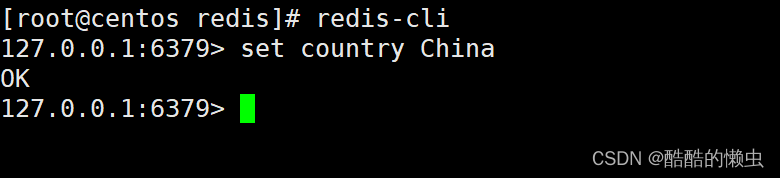
例如执行 SET country "China" 命令时,键 country 与 值 China 都是 SDS 类型的,只不过一个是 SDS 的变量,一个是 SDS 的字面常量。
- China 在内存中的结构如下:
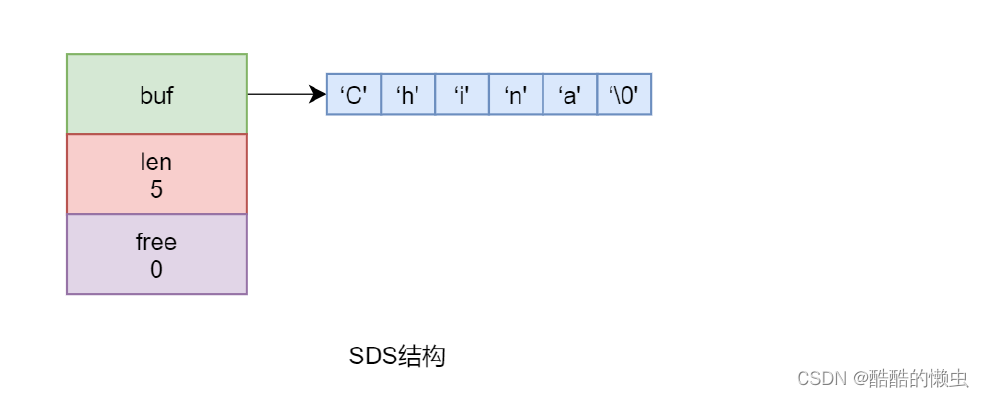
通过以上结构可以看出, SDS 的 buf 值实际是一个 C 字符串,包含空字符 '\0' 共占 6 个字节。但 SDS 的 len 是不包含空字符 '\0' 的。
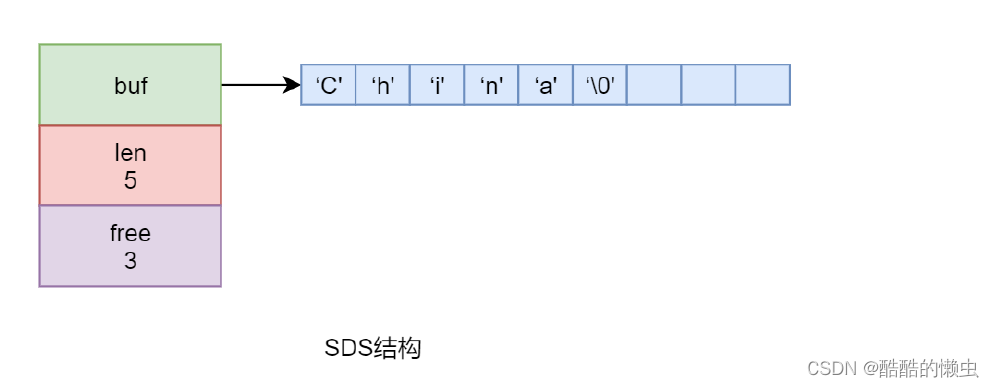
- 该结构与前面不同的是,这里有 3 字节未使用空间。
⭐️ 3.9.3、SDS的优势
C字符串使用 Len+1 长度的字符数组来表示实际长度为 Len 的字符串,字符数组最后以空字符 '\0' 结尾,表示字符串结束。这种结构简单,但不能满足 Redis 对字符串 功能性、安全性 及 高效性 等的要求。
(1) 防止 字符串长度获取 性能瓶颈
对于C 字符串,若要获取其长度,则必须要通过遍历整个字符串才可获取到的。对于超长字符串的遍历,会成为系统的 性能瓶颈。
但,由于SDS 结构体中直接就存放着字符串的长度数据,所以对于获取字符串长度需要消耗的系统性能,与字符串本身长度是无关的,不会成为 Redis 的性能瓶颈。
(2) 保障二进制安全
C字符串中只能包含符合某种编码格式的字符,例如 ASCII 、 UTF-8 等,并且除了字符串末尾外,其它位置是不能包含空字符 '\0' 的,否则该字符串就会被程序误解为提前结束。故而在图片、音频、视频、压缩文件、 office 文件等二进制数据的。
但 SDS 不是以空字符 '\0' 作为字符串结束标志的,其是通过 len 属性来判断字符串是否结束的。所以,对于程序处理 SDS 中的字符串数据,无需对数据做任何限制、过滤、假设,只需读取即可。数据写入的是什么,读到的就是什么。
(3) 减少内存再分配次数
SDS 采用了 空间预分配策略 与 惰性空间释放策略 来避免内存再分配问题。
空间预分配策略是指,每次SDS 进行空间扩展时,程序不但为其分配所需的空间,还会为其分配额外的未使用空间(以空间换时间),以减少内存再分配次数。而额外分配的未使用空间大小取决于空间扩展后 SDS 的 len 属性值。
- 如果
len属性值 小于1M,那么分配的未使用空间free的大小与len属性值 相同。 - 如果
len属性值 大于等于1M,那么分配的未使用空间free的大小固定是1M。
SDS对于空间释放采用的是惰性空间释放策略。该策略是指, SDS 字符串长度如果缩短,那么多出的未使用空间将暂时不释放,而是增加到 free 中。以使后期扩展 SDS 时减少内存再分配次数。
如果要释放 SDS 的未使用空间,则可通过 sdsRemoveFreeSpace() 函数来释放。
(4) 兼容 C 函数
Redis 中提供了很多的 SDS 的 API ,以方便用户对 Redis 进行二次开发。为了能够兼容 C 函数, SDS 的底层数组 buf[] 中的字符串仍以空字符 '\0' 结尾。
现在要比较的双方,一个是SDS ,一个是 C 字符串,此时可以通过 C 语言函数
strcmp(sds_str->buf, c_str)
⭐️ 3.9.4、常用的SDS操作函数
下表列出了一些常用的SDS 操作函数及其功能描述。
| 函数 | 功能描述 |
|---|---|
| sdsnew() | 使用指定的 C 字符串创建一个 SDS |
| sdsempty() | 创建一个不包含任何字符串数据的SDS |
| sdsdup() | 创建一个指定 SDS 的副本 |
| sdsfree() | 释放指定的SDS |
| sdsclear() | 清空指定 SDS 的字符串内容 |
| sdslen() | 获取指定SDS 的已使用空间 len 值 |
| sdsavail() | 获取指定 SDS 的未使用空间 free 值 |
| sdsMakeRoomFor() | 使指定的SDS 的 free 空间增加指定的大小 |
| sdsRemoveFreeSpace() | 释放指定 SDS 的 free 空间 |
| sdscat() | 将指定的C 字符串拼接到指定 SDS 字符串末尾 |
| sdscatsds() | 将指定的 SDS 的字符串拼接到另一个指定 SDS 字符串末尾 |
| sdscpy() | 将指定的C 字符串复制到指定的 SDS 中,覆盖原 SDS 字符串内容 |
| sdsgrouzero() | 扩展 SDS 字符串到指定长度。这个扩展是使用空字符 '\0' 填充 |
| sdsrange() | 截取指定SDS 中指定范围内的字符串 |
| sdstrim() | 在指定 SDS 中删除所有指定 C 字符串中出现的所有字符 |
| sdsemp() | 对比两个给定的SDS 字符串是否相同 |
| sdstolow() | 将指定 SDS 字符串中的所有字母变为小写 |
| sdstoupper() | 将指定SDS 字符串中的所有字母变为大写 |
3.10 集合的底层实现原理
Redis 中对于 Set 类型的底层实现,直接采用了 hashTable 。但对于 Hash 、 ZSet 、 List 集合的底层实现进行了特殊的设计,使其保证了 Redis 的高性能。
⭐️ 3.10.1、两种实现的选择
对于 Hash 与 ZSet 集合,其底层的实现实际有两种:压缩列表 zipList ,与跳跃列表 skipList 。
这两种实现对于用户来说是透明的,但用户写入不同的数据,系统会自动使用不同的实现。只有同时满足以配置文件 redis.conf 中相关集合 元素数量阈值 与 元素大小阈值 两个条件,使用的就是压缩列表 zipList ,只要有一个条件不满足使用的就是跳跃列表 skipList 。例如,对于
ZSet 集合中这两个条件如下:
- 集合元素个数小于
redis.conf中zset-max-ziplist-entries属性的值,其默认值为128 - 每个集合元素大小都小于
redis.conf中zset-max-ziplist-value属性的值,其默认值为64 字节
⭐️ 3.10.2、zipList
(1) 什么是 zipList
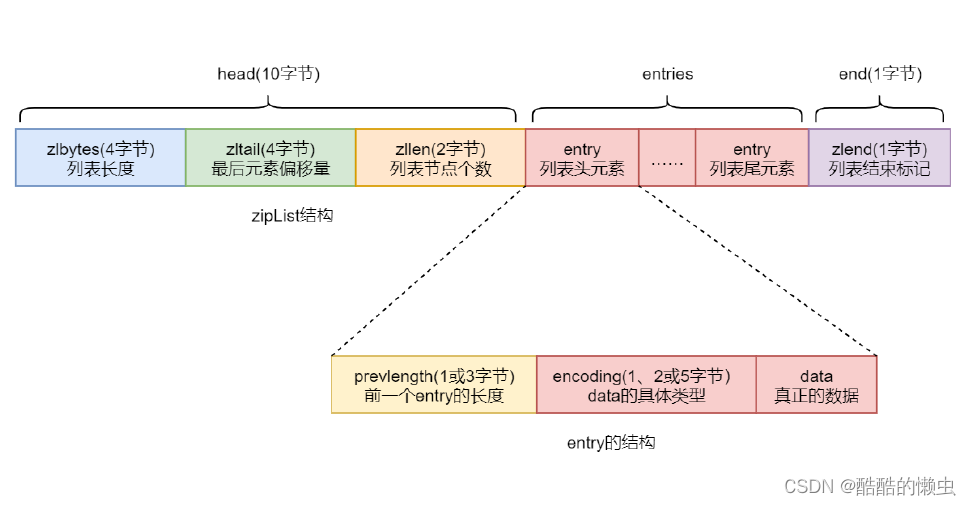
zipList,通常称为压缩列表 是一个经过 特殊编码 的用于 存储 字符串或整数 的双向链表。
其底层数据结构由三部分构成: head 、 entries 与 end 。这三部分在内存上是连续存放的。
(2) head
head 又由三部分构成:
zlbytes占 4 个字节,用于存放zipList列表整体数据结构所占的字节数,包括zlbytes本身的长度。zltail占 4 个字节,用于存放zipList中最后一个entry在整个数据结构中的偏移量(字节)。该数据的存在可以快速定位列表的尾entry位置,以方便操作。zllen占 2 字节,用于存放列表包含的entry个数。由于其只有 16 位,所以zipList最多可以含有的entry个数为 2 16 − 1 = 65535 2^{16} - 1 = 65535 216−1=65535 个。
(3) entries
entries 是真正的列表,由很多的列表元素 entry 构成。由于不同的元素类型、数值的不同,从而导致每个 entry 的长度不同。
每个 entry 由三部分构成:
prevlength该部分用于记录上一个entry的长度,以实现 逆序遍历 。默认长度为 1 字节,只要上一个entry的长度 <254 字节,prevlength就占 1 字节,否则其会自动扩展为 3 字节长度。encoding该部分用于标志后面的data的具体类型。如果data为整数类型,encoding固定长度为1 字节。如果data为字符串类型,则encoding长度可能会是1 字节、2 字节或5 字节。data字符串不同的长度,对应着不同的encoding长度。data:真正存储的数据。数据类型只能是整数类型或字符串类型。不同的数据占用的字节长度不同。
(4) end
end 只包含一部分,称为 zlend。占1 个字节,值固定为 255,即二进制位为全1,表示一个 zipList 列表的结束。
⭐️ 3.10.3、listPack
对于ziplist,实现复杂,为了逆序遍历,每个 entry 中包含前一个 entry 的长度,这样会导致在 ziplist 中间修改或者插入entry 时需要进行级联更新。在高并发的写操作场景下会极度降低 Redis 的性能。为了实现更紧凑、更快的解析,更简单的实现,==重写==实现了ziplist,并命名为listPack。
在Redis 7.0 中,已经将 zipList 全部替换为了 listPack,但为了兼容性,在配置中也保留了 zipList 的相关属性。
(1) 什么是 listPack
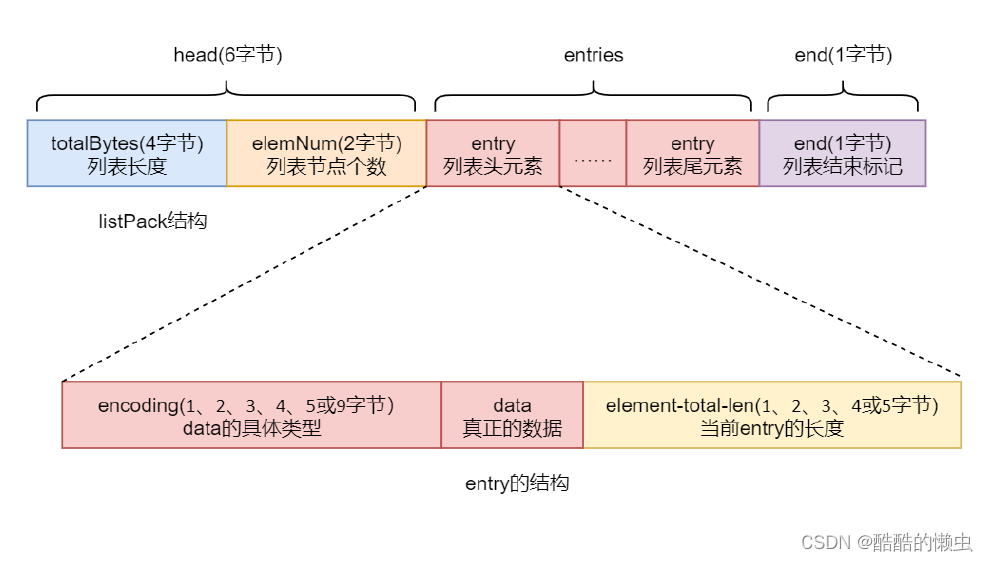
listPack 也是一个经过 特殊编码 的用于 存储 字符串或整数 的双向链表。其底层数据结构也由三部分构成:head、entries 与 end,且这三部分在内存上也是连续存放的。
listPack 与 zipList 的重大区别在 head与每个 entry 的结构上,表示列表结束的 end 与 zipList 的 zlend 是相同的,占一个字节,且8 位全为1。
(2) head
head 由两部分构成:
totalBytes:占 4 个字节,用于存放listPack列表整体数据结构所占的字节数,包括totalBytes本身的长度。elemNum:占 2 字节,用于存放列表包含的entry个数。其意义与zipList中zllen的相同。
与 zipList 的 head 相比,没有了记录最后一个 entry 偏移量的 zltail 。
(3) entries
entries 也是 listPack 中真正的列表,由很多的列表元素 entry 构成。由于不同的元素类型、数值的不同,从而导致每个 entry 的长度不同。但与 zipList 的 entry 结构相比, listPack的 entry 结构发生了较大变化。
其中最大的变化就是没有了记录前一个 entry 长度的 prevlength ,而增加了记录当前 entry 长度的 element-total-len 。而这个改变仍然可以实现 逆序遍历 ,但却避免了由于在列表中间修改或插入 entry 时引发的级联更新 。
每个 entry 仍 由三部分构成:
encoding: 该部分用于标志后面的data的具体类型。如果data为整数类型,encoding长度可能会是 1 、 2 、 3 、 4 、 5 或 9 字节。不同的字节长度,其标识位不同。如果data为字符串类型,则encoding长度可能会是 1 、 2 或 5 字节。data字符串不同的长度,对应着不同的encoding长度。data:真正存储的数据。数据类型只能是整数类型或字符串类型。不同的数据占用的字
节长度不同。element-total-len: 该部分用于记录当前entry的长度,用于实现 逆序遍历 。由于其特殊的记录方式,使其本身占有的字节数据可能会是 1 、 2 、 3 、 4 或 5 字节。
⭐️ 3.10.4、skipList
(1) 什么是 skipList
skipList,跳跃列表,简称跳表 是一种 随机化 的数据结构,基于 并联 的链表,实现简单,查找 效率较高 。简单 来说跳表也是链表的一种,只不过它在链表的基础上增加了跳跃功能。也 正是这个跳跃功能,使得在查找元素时,能够提供 较高的效率 。
(2) skipList 原理
假设有一个带头尾结点的有序链表。
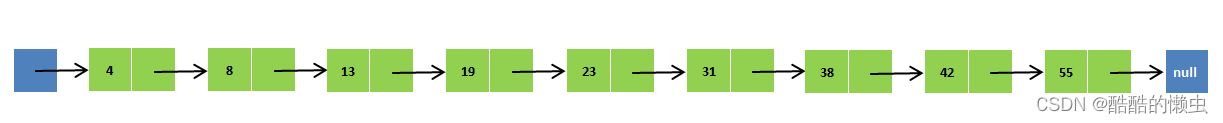
在该链表中,如果要查找某个数据,需要从头开始逐个进行比较,直到找到包含数据的那个节点,或者找到第一个比给定数据大的节点,或者找到最后尾结点,后两种都属于没有找到的情况。同样,当我们要插入新数据的时候,也要经历同样的查找过程,从而确定插入位置。
为了提升查找效率,在偶数结点上增加一个指针,让其指向下一个偶数结点。
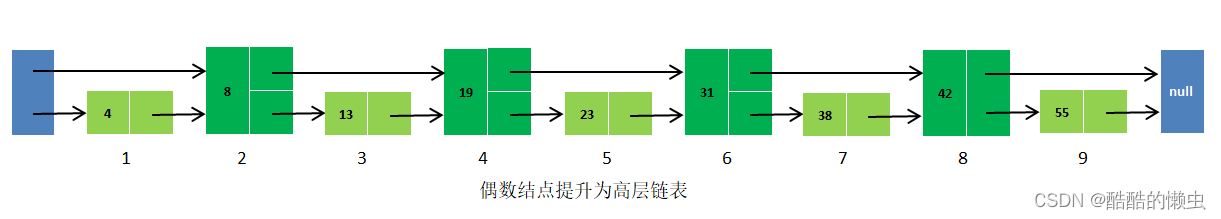
这样所有偶数结点就连成了一个新的链表(简称高层链表),当然,高层链表包含的节点个数只是原来链表的一半。此时再想查找某个数据时,先沿着高层链表进行查找。 当遇到第一个比待查数据大的节点时,立即从 该大节点的前一个节点 回到原 链表中进行查找。例如若想插入一个数据 2 0 则先在( 8 19 31 42 )的链表中查找,找到第一个比 20 大的节
点 31 ,然后再在高层链表中找到 31 节点的前一个节点 19 ,然后再在原链表中获取到其下一个节点值为 23 。比 20 大,则将 20 插入到 19 节点与 23 节点之间。若插入的是 25 ,比节点23 大,则插入到 23 节点与 31 节点之间。
该方式明显可以减少比较次数,提高查找效率。如果链表元素较多,为了进一步提升查找效率,可以将原链表构建为三层链表,或再高层级链表。
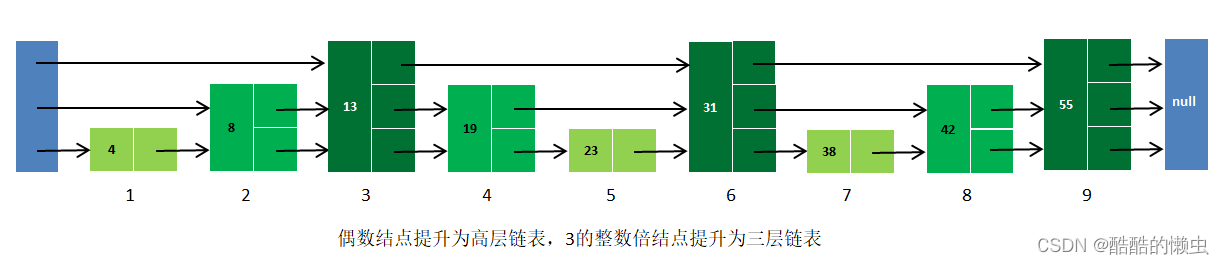
层级越高,查找效率就会越高 。
(3) 存在的问题
这种对链表分层级的方式从原理上看确实提升了查找效率,但在实际操作时就出现了问题:由于固定序号的元素拥有固定层级,所以列表元素出现增加或删除的情况下,会导致列表整体元素层级大调整,但这样势必会大大降低系统性能。
例如,对于划分两级的链表,可以规定奇数结点为高层级链表,偶数结点为低层级链表。对于划分三级的链表,可以按照节点序号与 3 取模结果进行划分。但如果插入了新的节点,或删除的原来的某些节点,那么定会按照原来的层级划分规则进行重新层级划分,那么势必会大大降低系统性能。
(4) 算法优化
为了避免前面的问题, skipList 采用了随机分配层级方式。即在确定了总层级后,每添加一个新的元素时会自动为其随机分配一个层级。这种随机性就解决了节点序号与层级间的固定关系问题。
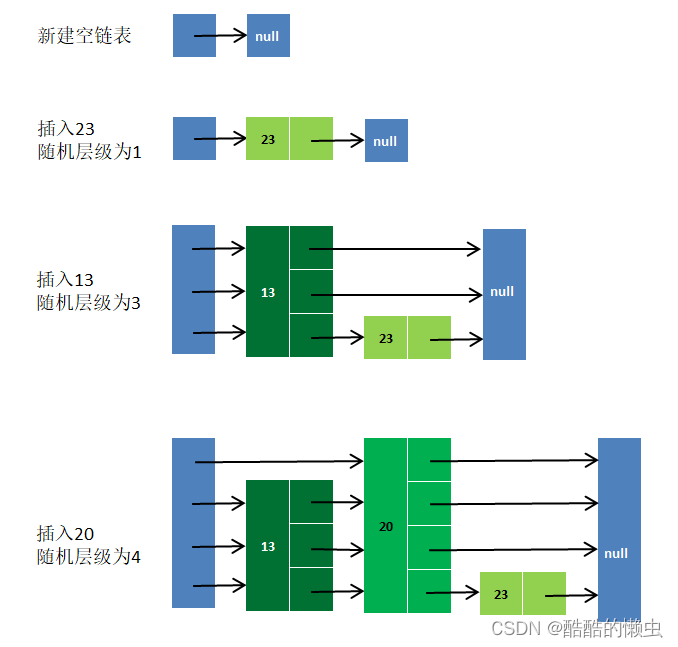
上图演示了列表在生成过程中为每个元素随机分配层级的过程。从这个 skiplist 的创建和插入过程可以看出,每一个节点的层级数都是随机分配的,而且新插入一个节点不会影响到其它节点的层级数。只需要修改插入节点前后的指针,而不需对很多节点都进行调整。这就降低了插入操作的复杂度。
skipList指的就是除了最下面第 1 层链表之外,它会产生若干层稀疏的链 表,这些链表里面的指针跳过了一些节点 ,并 且越高层 级 的链表跳过的节点越多。在查找数据的时先在高层 级 链表中进行查找,然后逐层降低,最终 可能会 降到第 1 层链表 来精确地确定数据位置。在这个过程中由于 跳过了一些节点,从而加快了查找速度。
⭐️ 3.10.5、quickList
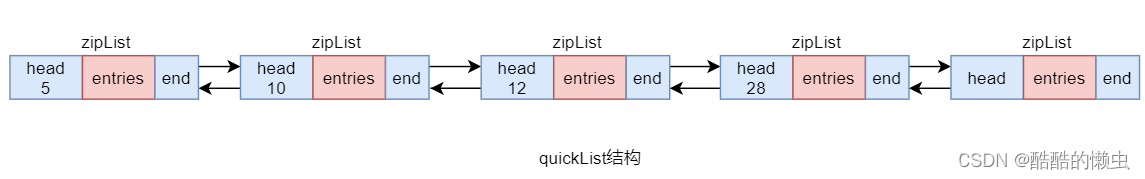
(1) 什么是 quickList
quickList,快速列表 quickList 本身是一个双向无循环 链表,它的每一个节点都是一个 zipList 。从 Redis3.2 版本开始,对于 List 的底层实现,使用 quickList 替代了 zipList 和 linkedList 。
zipList 与 linkedList 都存在有明显不足,而 quickList 则 对它们进行了改进 :吸取了 zipList 和 linkedList 的优点,避开了它们的不足。
quickList 本质上是 zipList 和 linkedList 的混合体 。 其 将 linkedList 按段切分,每一段使用 zipList 来紧凑存储 若干真正的数据元素 ,多个 zipList 之间使用双向指针串接起来。 当然,对于每个 zipList 中最多可存放多大容量的数据元素,在配置文件中通过 list-max-ziplist-size 属性可以指定。
(2) 检索操作
为了更深入的理解 quickList 的工作原理,通过对检索、插入、删除等操作的实现分析来加深理解。
对于 List 元素的检索,都是以其索引 index 为依据的。 quickList 由一个个的 zipList 构成,每个 zipList 的 zllen 中记录的就是当前 zipList 中包含的 entry 的个数,即包含的真正数据元素的个数。根据要检索元素的 index ,从 quickList 的头节点开始,逐个对 zipList 的 zllen 做 sum求和,直到找到第一个求和后 sum 大于 index 的 zipList ,那么要检索的这个元素就在这个 zipList 中。
(3) 插入操作
由于 zipList 是有大小限制的,所以在 quickList 中插入一个元素在逻辑上相对就比较复杂一些。假设要插入的元素的大小为 insertBytes ,而查找到的插入位置所在的 zipList 当前的大小为 zlBytes ,那么具体可分为下面几种情况:
- 情况一:当
insertBytes + zlBytes <= list-max-ziplist-size时 直接插入到zipList中相应位置即可 - 情况二:当
insertBytes + zlBytes > list-max-ziplist-size,且插入的位置位于该zipList的首部位置,此时需要查看该zipList的前一个zipList的大小prev_zlBytes。- 若
insertBytes + prev_zlBytes <= list-max-ziplist-size时,直接将元素插入到前一个zipList的尾部位置即可 - 若
insertBytes + prev_zlBytes > list-max-ziplist-size时,直接将元素自己构建为一个新的zipList,并连入quickList中
- 若
- 情况三:当
insertBytes + zlBytes > list-max-ziplist-size,且插入的位置位于该zipList的尾部位置,此时需要查看该zipList的后一个zipList的大小next_zlBytes。- 若
insertBytes + next_zlBytes <= list-max-ziplist-size时,直接将元素插入到后一个zipList的头部位置即可 - 若
insertBytes + next_zlBytes > list-max-ziplist-size时,直接将元素自己构建为一个新的zipList,并连入quickList中
- 若
- 情况四:当
insertBytes + zlBytes > list-max-ziplist-size,且插入的位置位于该zipList的中间位置,则将当前zipList分割为两个zipList连接入quickList中,然后将元素插入到分割后的前面zipList的尾部位置。
(4) 删除操作
对于删除操作,只需要注意一点,在相应的 zipList 中删除元素后,该 zipList 中是否还有元素。如果没有其它元素了,则将该 zipList 删除,将其前后两个 zipList 相连接。
⭐️ 3.10.6、key与value 中元素的数量
前面讲述的Redis 的各种特殊数据结构的设计,不仅极大提升了 Redis 的性能,并且还使得 Redis 可以支持的 key 的数量、集合 value 中可以支持的元素数量可以非常庞大。
- Redis 最多可以处理 2 32 2^{32} 232 个 key (约 42 亿) ),并且在实践中经过测试,每个 Redis 实例至少可以处理 2.5 亿个
key。 - 每个
Hash、List、Set、ZSet集合 都可以包含 2 32 2^{32} 232 个元素。
3.11 BitMap 操作命令
⭐️ 3.11.1、BitMap简介
⭐️ 3.11.2、setbit
⭐️ 3.11.3、getbit
⭐️ 3.11.4、bitcount
⭐️ 3.11.5、bitpos
⭐️ 3.11.6、bitop
⭐️ 3.11.7、应用场景
3.12 HyperLogLog 操作命令
⭐️ 3.12.1、HyperLogLog简介
⭐️ 3.12.2、pfadd
⭐️ 3.12.3、pfcount
⭐️ 3.12.4、pfmerge
⭐️ 3.12.5、应用场景
3.13 Geospatial 操作命令
⭐️ 3.13.1、Geospatial简介
⭐️ 3.13.2、geoadd
⭐️ 3.13.3、geopos
⭐️ 3.13.4、geodist
⭐️ 3.13.5、geohash
⭐️ 3.13.6、georadius
⭐️ 3.13.7、georadiusbymember
⭐️ 3.13.8、应用场景
3.14 发布/订阅命令
⭐️ 3.14.1、消息系统
⭐️ 3.14.2、subscribe
⭐️ 3.14.3、psubscribe
⭐️ 3.14.4、publish
⭐️ 3.14.5、unsubscribe
⭐️ 3.14.6、punsubscribe
⭐️ 3.14.7、pubsub
3.15 Redis 事务
⭐️ 3.15.1、Redis 事务特性
⭐️ 3.15.2、Redis 事务实现
⭐️ 3.15.3、Redis 事务异常处理
⭐️ 3.15.4、Redis 事务隔离机制
四、Redis 持久化
🚀🚀🚀 Redis 持久化 快速食用:---------------------------------------------------------------------------------------------------------------------------------------------------------------------------->


