目录
Collection简介
Collection的遍历方式
迭代器遍历
增强for遍历
Lambda表达式遍历
List集合
List集合的遍历方式
列表迭代器遍历以及普通for循环
数据结构
栈
队列
数组
链表
单向链表
双向链表
二叉树
遍历方式
普通二叉树
二叉查找树
平衡二叉树
旋转机制
红黑树
ArrayList集合底层原理
LinkedList集合的底层原理
泛型深入
JDK5之前
JDK5之后
泛型的定义
泛型类
泛型方法
泛型接口
泛型的继承
泛型的通配符
Set集合
HashSet实现类
底层原理
LinkedHashSet底层原理
TreeSet
应用场景
本篇文章是我听b站阿伟老师讲课的一个总结。
Collection简介
Collection接口:单列接口(单列集合的祖宗接口,它的功能是全部单列集合都可以继承使用的。)
Map接口:双列集合(下一期讲)
红色边框是接口,蓝色边框表示implement接口的类
Collection接口:List接口和Set接口继承Collection接口
List接口:有三个实现类:ArrayList、LinkedList、Vector
Set接口:有两个实现类:HashSet、TreeSet;同时在HashSet中,LinkedHashSet又继承于它
List系列集合:添加的元素是有序、可重复、有索引
Set系列集合:添加的元素是无序、不重复、无索引
常见方法
public boolean add(E e):把给定的对象添加到当前集合中
public void clear ():清空集合中所有的元素
public boolean remove (E e):把给定的对象在当前集合中删除
public boolean contains (Object obj):判断当前集合中是否包含给定的对象
public boolean isEmpty():判断当前集合是否为空
public int size():返回集合中元素的个数/集合
注意:
Set没有索引不能通过普通for来进行遍历。
普通for遍历只有list接口的实现类能用(因为它有索引)。
Collection的遍历方式
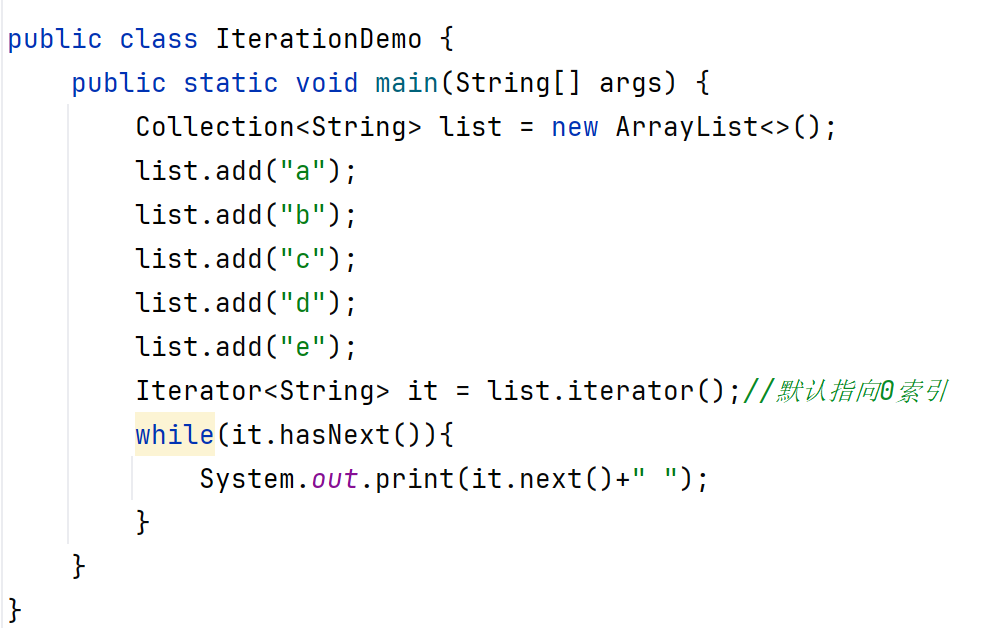
迭代器遍历
迭代器不依赖索引。
迭代器在java中有一个类是Iterator,迭代器是集合专用的遍历方式。
Collection集合获取迭代器的方法:Iterator<E> iterator() 返回迭代器对象,默认指向当前集合的0索引。
Iterator中的常用方法:
boolean hasNext() 判断当前位置是否有元素,有元素返回true,没有元素返回false
E next() 获取当前位置的元素,并将迭代器对象移向下一个位置。
举例:
细节:
1、如果指针已经指向如上代码元素e后面的数,e后面没有数字,还要强行获取当前元素,就会报错NoSuchElementException.
2、迭代器遍历完毕,指针不会复位。(如果还要遍历集合第二遍,只能重新获取一个迭代器)
3、循环中只能用一次next方法。(因为如果在一个循环中有两次或者多次next方法时,如果在第一次或者前几次用next方法已经遍历结束了,在下一次next方法就会报错,因为没有元素了)
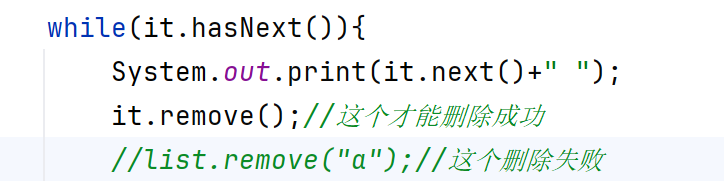
4、迭代器遍历时,不能用集合的方式进行增加或者删除。
增强for遍历
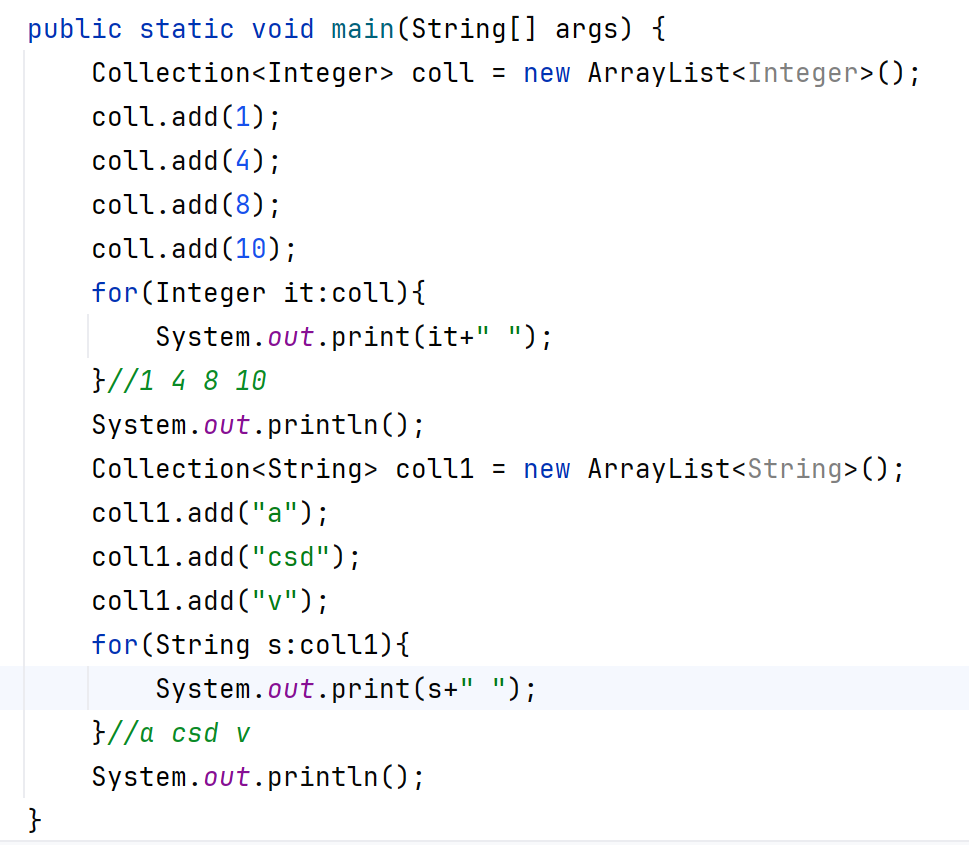
增强for的底层就是迭代器,为了简化迭代器的代码书写的。
它是JDK5之后出现的,内部原理就是一个Iterator迭代器。
所有的单列集合和数组才能用增强for进行遍历
格式:
for(元素的数据类型 变量名:数组或者集合){......}
细节:
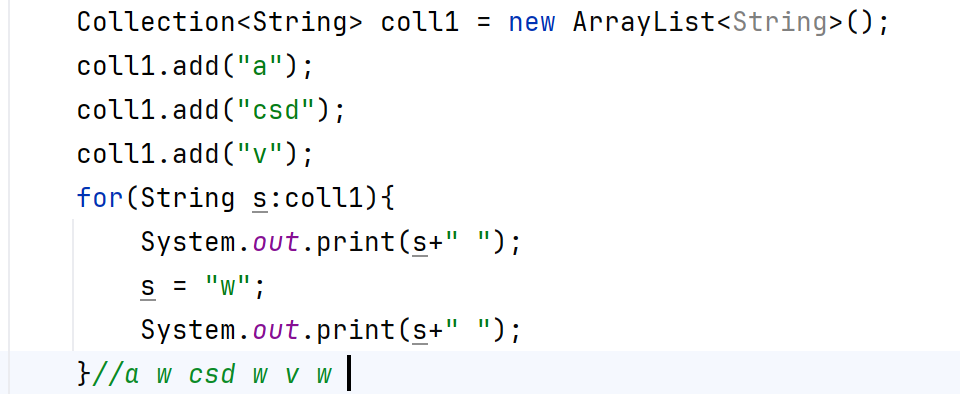
修改增强for中的变量(例如如上代码的it、s),不会改变集合中原本的数据,他只是一个接收集合或数组中数据的变量而已。
Lambda表达式遍历
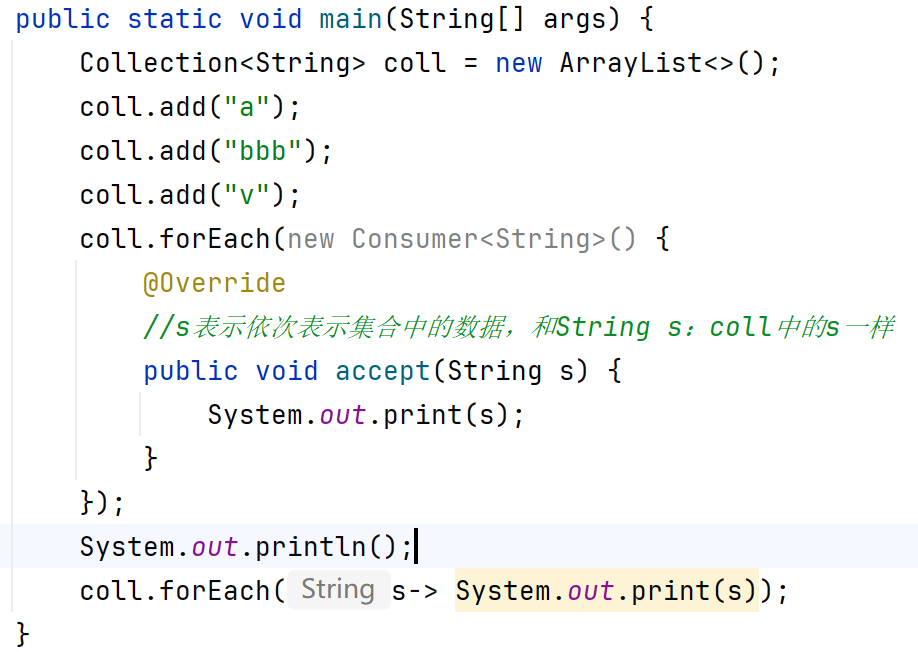
利用的方法:default void forEach(Consumer<? super T> action):
Consumer是一个函数类接口
List集合
特点:
有序:存和取的元素顺序一致。
有索引:可以通过索引操作元素。
可重复:存储的元素可以重复。
Collection的方法List都继承了;List集合因为有索引,所以多了很多索引操作的方法。
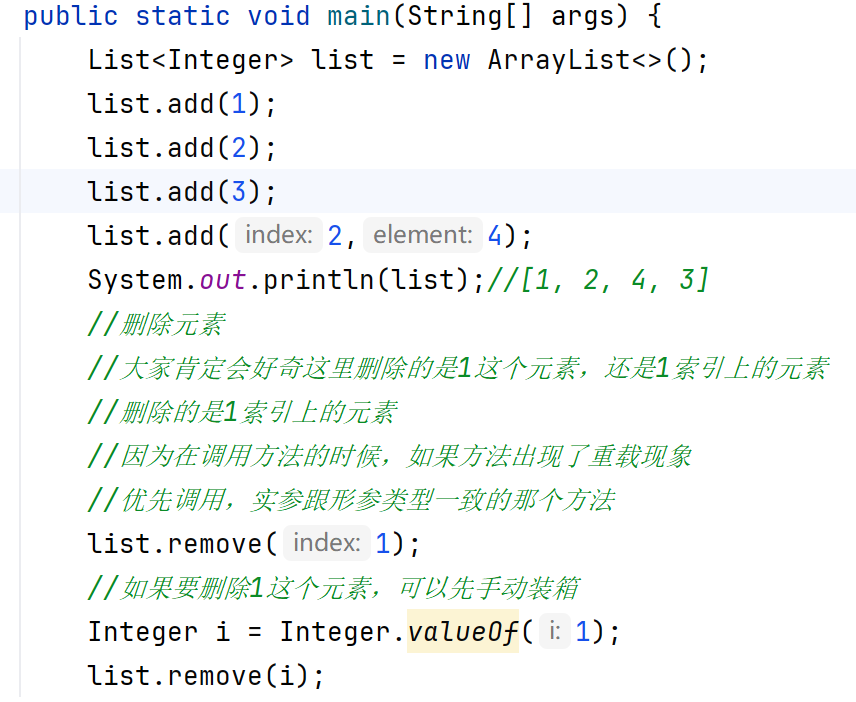
void add(int index,E element) 在此集合中的指定位置插入指定的元素
E remove(int index) 删除指定索引处的元素,返回被删除的元素
E set (int index,E element) 修改指定索引处的元素,返回被修改的元素
E get(int index) 返回指定索引处的元素
List集合的遍历方式
List接口继承于Collection,所以上边讲的Collection接口的遍历方式在List中同样适用,但是List也有它自己独特的遍历方式。
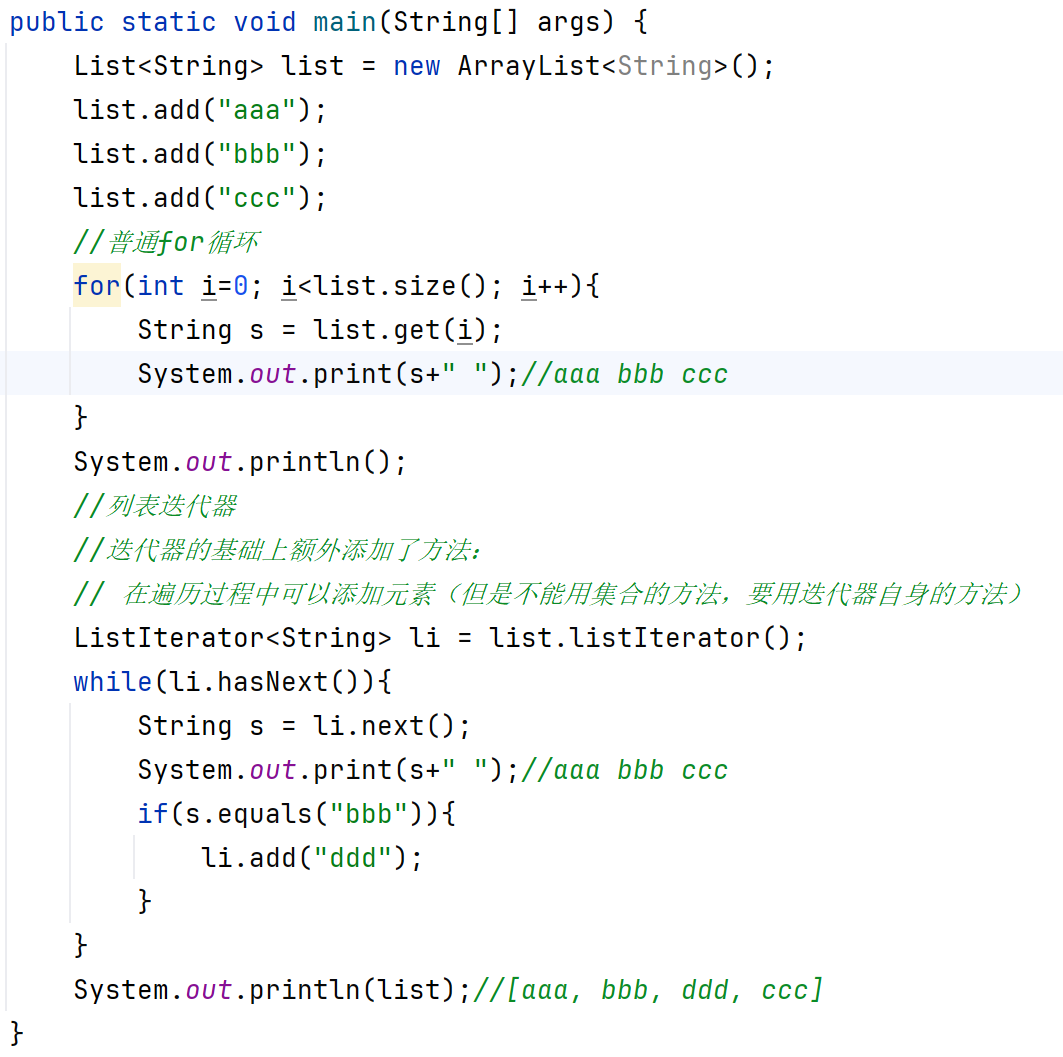
列表迭代器遍历以及普通for循环
列表迭代器遍历(他自己独特的遍历方式)
普通for循环(因为List集合存在索引)
数据结构
数据结构是计算机底层存储、组织数据的方式。是指数据之间是以什么方式排列在一起。
数据结构是为了更加方便的管理和使用数据,需要结合具体的业务场景来进行选择。
一般情况下,精心选择的数据结构可以带来更高的运行或者存储效率。
栈
先进后出
队列
先进先出
数组
查询速率快(有索引、地址值来查询),删除元素和添加元素效率低(查询快,增删慢)
链表
单向链表
查询慢,无论查询那个数据都要从头开始找;增删快。
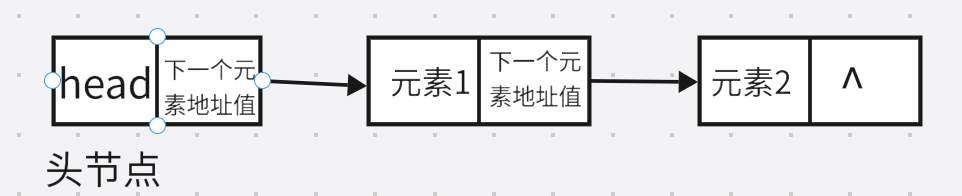
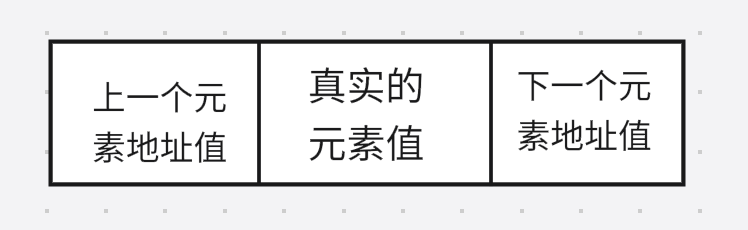
每一个元素都被称为结点,每一个节点都是一个独立的对象,在内存中是不连续的,每个结点包含数据值和下一个结点的地址值。
链表有头节点
双向链表
头结点的上一个元素地址值为空,尾结点的下一个元素地址值为空
可以提高查询效率,不仅可以从前往后查询,还可以从后往前查询
当题目要求查第几个元素时,如果离头结点比较近那么就从前往后查,如果离尾结点比较近,就从后往前查
二叉树
二叉树中,任意节点的度<=2
遍历方式
所有的二叉树都可以用这个遍历方式
前序遍历:
从根节点开始,按照当前节点,左子节点,右子节点的顺序开始遍历
中序遍历:
从最左边的节点开始,按照左子节点,当前节点,右子节点的顺序开始遍历
后序遍历:
从最左边的节点开始,按照左子节点,右子节点,当前节点的顺序开始遍历
层序遍历:
从根节点开始,一层一层的遍历(从左到右)
普通二叉树
查找很慢
二叉查找树
又叫二叉排序树或者二叉搜索树
任意节点左子树上的值都小于当前节点
任意节点右子树上的值都大于当前节点
添加节点时,小的存左边,大的存右边,一样的不存
查找也是一样的原理。
弊端:如果添加的元素时按升序或者降序添加时,他就只有右子树或者左子树。这样查询效率就会很慢。因此,如果要使左右子树差不多高,就涉及到了平衡二叉树。
平衡二叉树
任意节点左右字数高度差不超过1(由二叉查找树演变而来,本质也是个二叉查找树)
怎么保证树的平衡?
旋转机制
触发时机:当添加一个节点之后,该树不再是一颗平衡二叉树
左旋(逆时针)
确定支点:从添加的结点开始,不断的往父节点找不平衡的节点
找到后,把支点左旋,变成左子节点
如果支点存在左子树,那么这个左子树,肯定介于支点的父节点以及支点之间,他自然而然的变成支点父节点的右子树;支点的父节点变为支点的左子树。
右旋(顺时针)
和左旋原理一样,只不过反过来就可以了
需要旋转的四种情况:
1、左左:当根节点左子树的左子树有节点插入,导致二叉树不平衡(一次右旋)
2、左右:当根节点左子树的右子树有节点插入,导致二叉树不平衡(先局部左旋,再整体右旋)
3、右右:当根节点右子树的右子树有节点插入,导致二叉树不平衡(一次左旋)
4、右左:当根节点右子树的左子树有节点插入,导致二叉树不平衡(先局部右旋,再整体左旋)
红黑树
增删改查性能都很好
是一种自平衡的二叉查找树。(之前被叫做二叉查找B数)
特殊的二叉查找树;但是不是高度平衡的;条件:特有的红黑规则
红黑规则:
1、每一个节点要么是红色,要么是黑色。
2、根节点必须是黑色
3、如果一个节点没有子节点或者父节点,则该节点相应的指针属性值为Nil,这些Nil视为叶节点,每个叶节点(Nil)是黑色的。
4、如果某一个节点是红色,那么它的子节点必须是黑色(不能出现两个红色节点相连的情况)
5、对于每一个节点,从该节点到其所有后代叶节点的简单路径上,均包含相同数目的黑色节点。
添加节点时,默认添加节点的颜色是红色的,这样效率更高。
添加时:如果是根节点,直接变为黑色
非根节点:父节点是黑色:不需要进行任何操作
父节点是红色:1、叔叔红色:1)将“父”设为黑色,将“叔叔”设为黑色
2)将“祖父”设为“红色”
3)如果祖父为根,再将根变回黑色
4)如果祖父非根,将祖父设置为当前节点再进行其他判断
2、叔叔黑色,当前节点为父的右孩子:把父设置为当前节点并左旋,再进行判断
2、叔叔黑色,当前节点为父的左孩子:1)将“父”设为“黑色”
2)将“祖父”变为“红色”3)以祖父为支点进行右旋
ArrayList集合底层原理
扩容机制:
1、利用空参构造的集合,在底层创建一个默认长度为0的数组。
2、添加第一个元素时,底层会创建一个新的长度为10的数组。
这个数组的名字叫做:elementDate;size来记录数组里面的元素个数,以及下一个要存入的数的索引。
3、当又存满时,会再次创建一个新数组,把原来的元素都拷贝到新数组当中,新数组扩容1.5倍。
4、当又存满了,第一种情况:会再次扩容1.5倍。
第二种情况:如果一次添加多个元素(比如addAll方法的list2.addAll(list1)在一个集合中添加另一个集合的所有元素),1.5倍还放不下,则新创建数组的长度为实际长度为基准。
这两种情况,都会创建一个新的数组,开拷贝旧数组的元素,用copyOf()方法(Arrays类中的一个静态方法)拷贝。新数组的名字和旧数组一样。
LinkedList集合的底层原理
底层数据结构是双链表,查询慢,增删快,但是如果操作的是首尾元素,数据也是极快的。
LinkedList本身提供了很多直接操作首尾元素的特有API
public void addFirst(E e)在该列表开头插入指定的元素
public void addLast (E e):将指定的元素追加到此列表的末尾
public E getFirst():返回此列表中的第一个元素
public E getLast):返回此列表中的最后一个元素
public E removeFirst():从此列表中删除并返回第一个元素
public E removeLast):从此列表中删除并返回最后一个元素
可以自己去API看看Collection接口中的add方法源码。
泛型深入
泛型是JDK5中引入的特性,可以在编译阶段约束操作的数据类型,并进行检查。
泛型的格式:<数据类型>
注意:泛型只能支持引用数据类型
JDK5之前
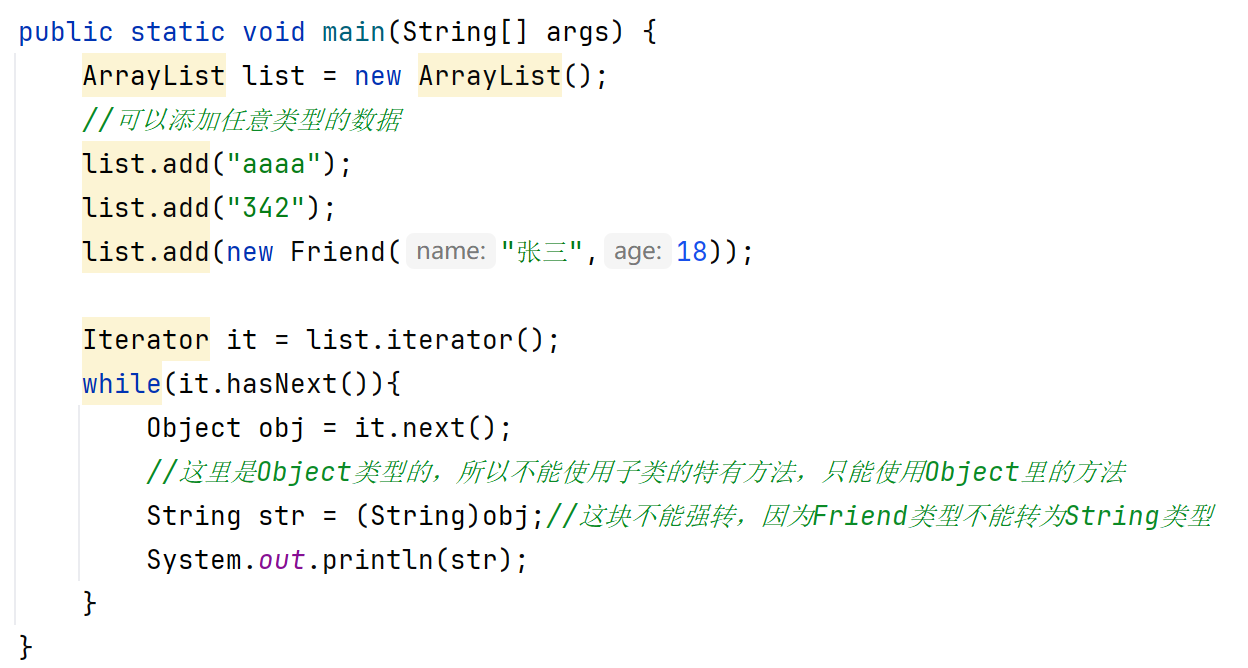
没有泛型
JDK5之后
泛型的好处:统一数据类型
扩展:Java中的泛型是伪泛型(比如集合的泛型String类型的,那么加入这个集合时,会检验是不是String,但是加入进去之后,就会变成Object类型的,但当外面要获取数据时,底层就会把Object按照泛型强转为String类型)(当在Java文件中编译的时候这个泛型会显示出来,但在它转成字节码class文件时,这个泛型就会消失)
泛型不能写基本数据类型
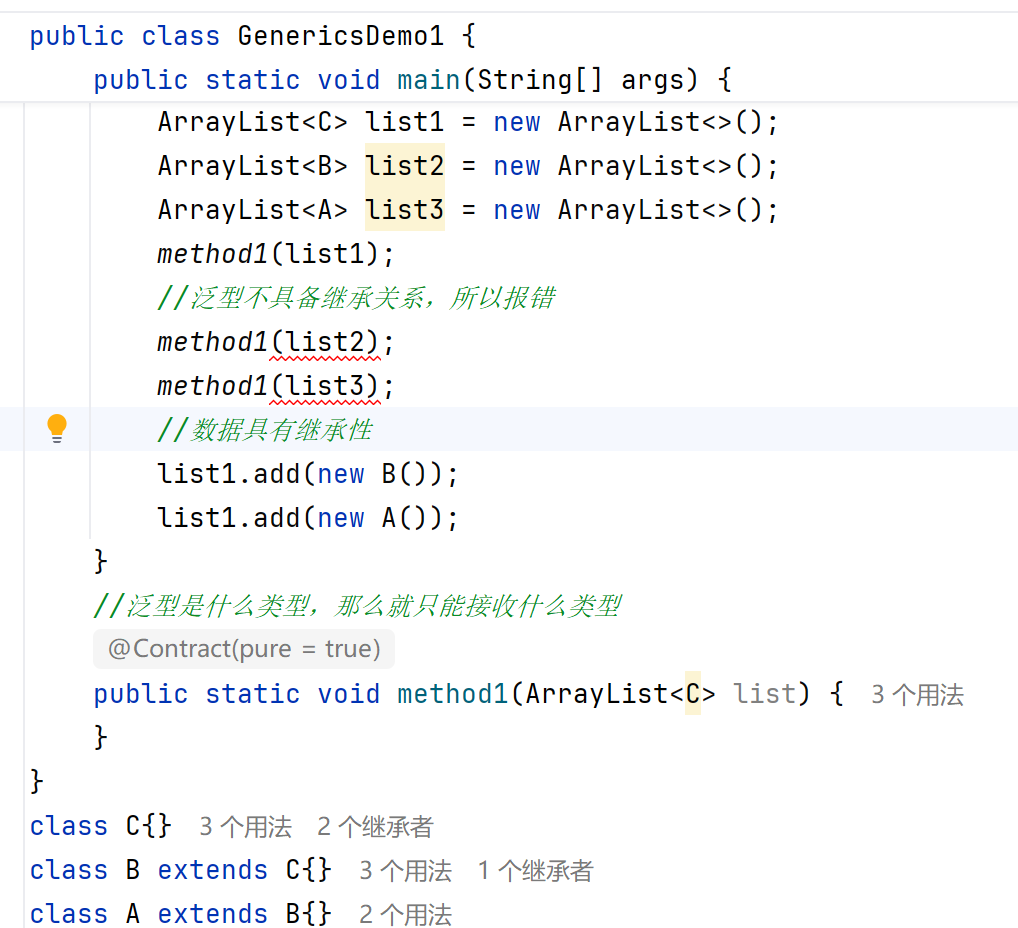
指定泛型的具体类型后,传递数据时,可以传入该类类型或者子类类型。
如果不写泛型默认是Object
泛型的定义
类后面——泛型类、方法上面——泛型方法、接口后面——泛型接口
泛型类
当一个类中,某个变量的数据类型不确定时,就可以定义带有泛型的类
格式:修饰符 class 类名<类型>{}
举例:public class ArrayList<E>{}我们在使用的时候比如ArrayList<String> list = new ArrayList<>();这时这个E就确定为String类型
这个E可以理解为变量,不是用来记录数据的,而是记录数据的类型,可以写成T、E、K、V等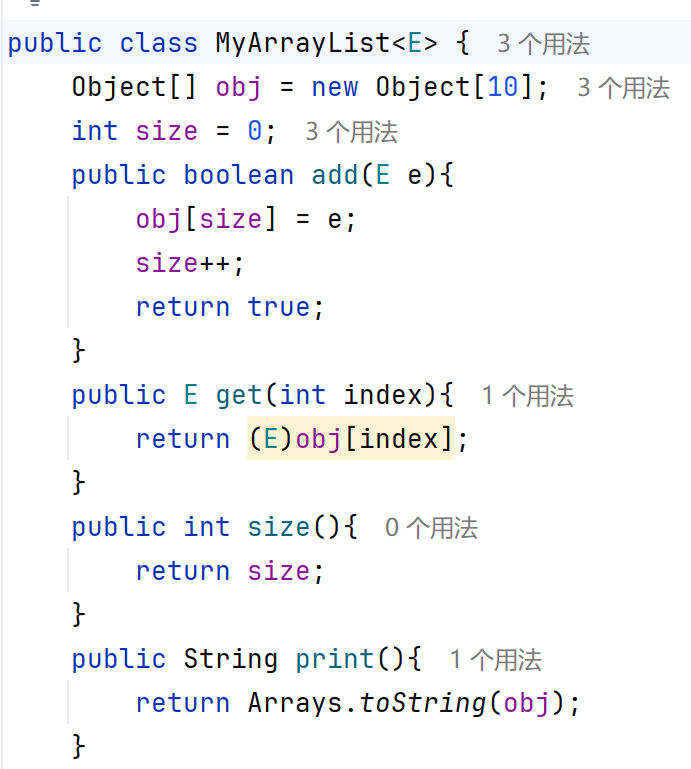
泛型方法
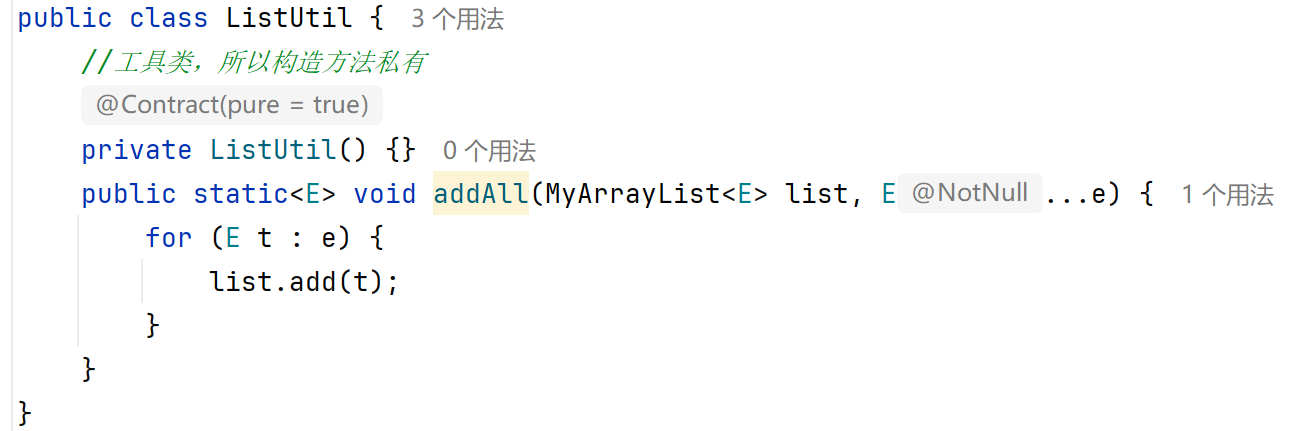
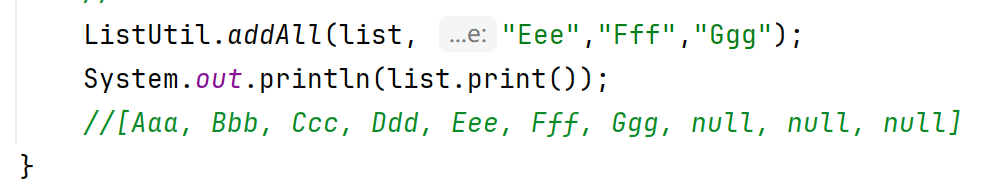
方法中形参类型不确定时,可以使用类名后面定义的泛型<E>
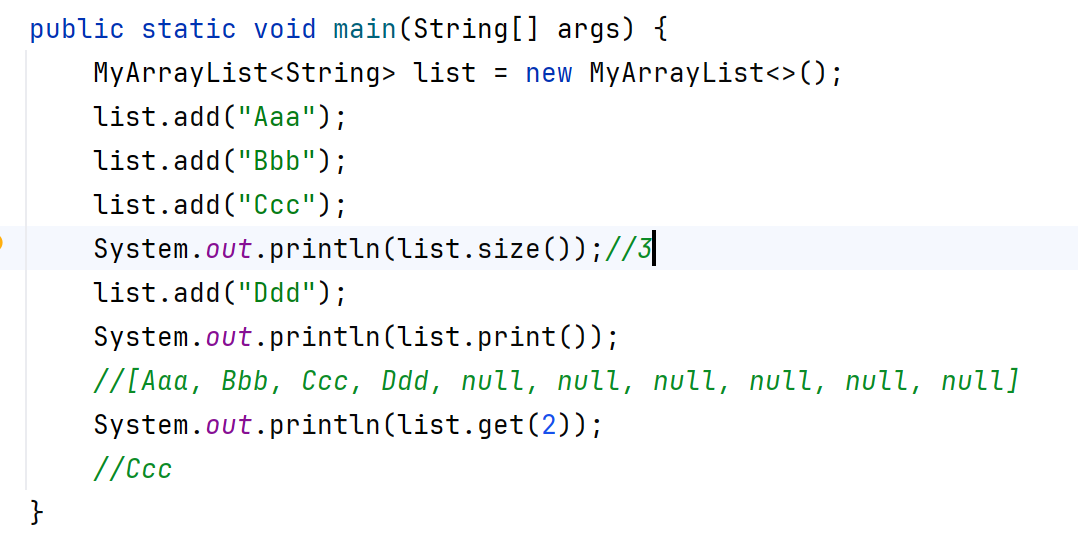
方法一:使用类名后面定义的泛型(所有方法都能使用)
如上代码便是这种方法一。
方法二:在方法申明上定义自己的泛型(只能在本方法上使用)
格式:修饰符<类型> 返回值类型 方法名(类型 变量名){}
举例:public<K> void swim(K k){}
K可以理解为变量,不是用来记录数据的,而是记录数据的类型,可以写成T、E、K、V等
泛型接口
格式:修饰符 interface 接口名<类型>{}
举例:public interface List<E>{}
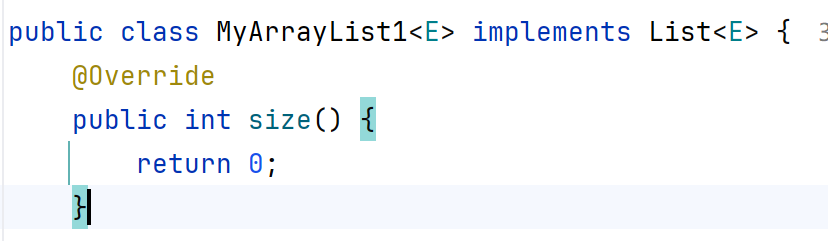
如何使用一个带泛型的接口
方法一:实现类给出具体的类型

方法二:实现类延续泛型,创建对象再确定
泛型的继承
泛型不具备继承性,但是数据具备继承性
泛型的通配符
对于以上,如果我们非要让他能够传递A,B,C三种继承类型时,该怎么办?
有人会想到:
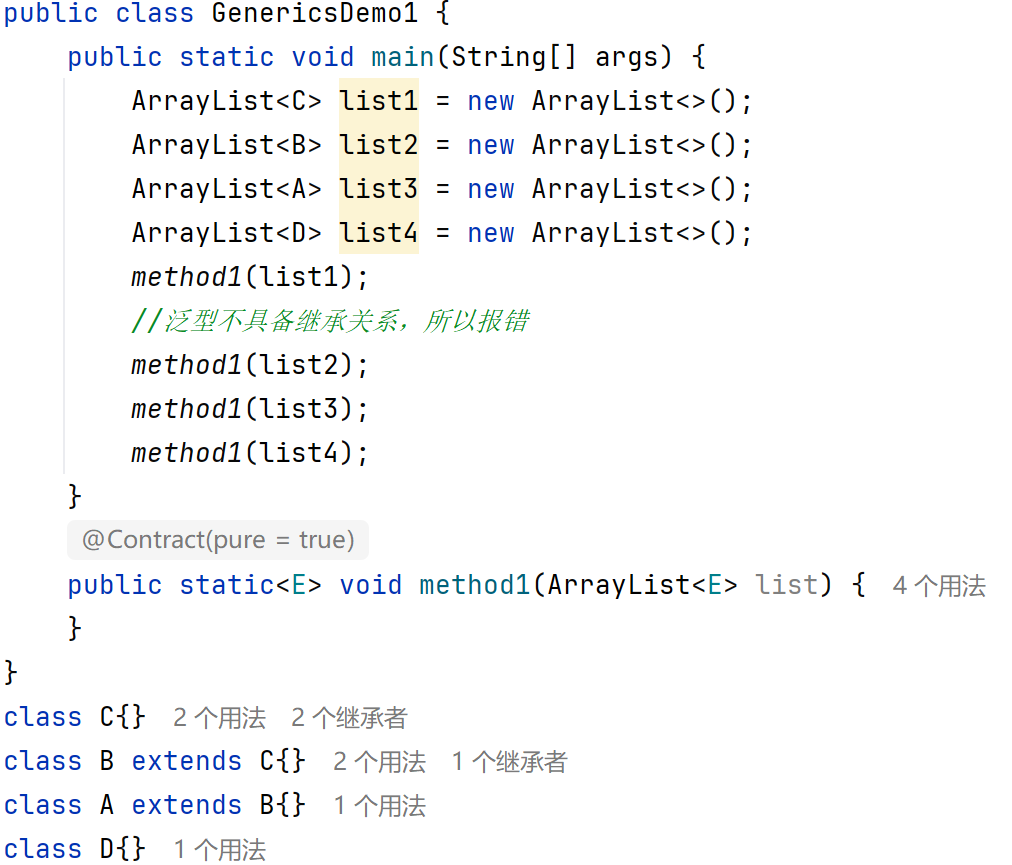
这个虽然能传递,但是D类型他不在继承之内,也可以传递,他可以传递任何类型。
这时就能传递通配符
?也表示不确定的类型,它可以进行类型的限定
?extends E:表示可以传递E或者E所有的子类类型
?super E:表示可以传递E或者E所有的父类类型
只传问号时,和上面代码一个意思,也可以传递D:
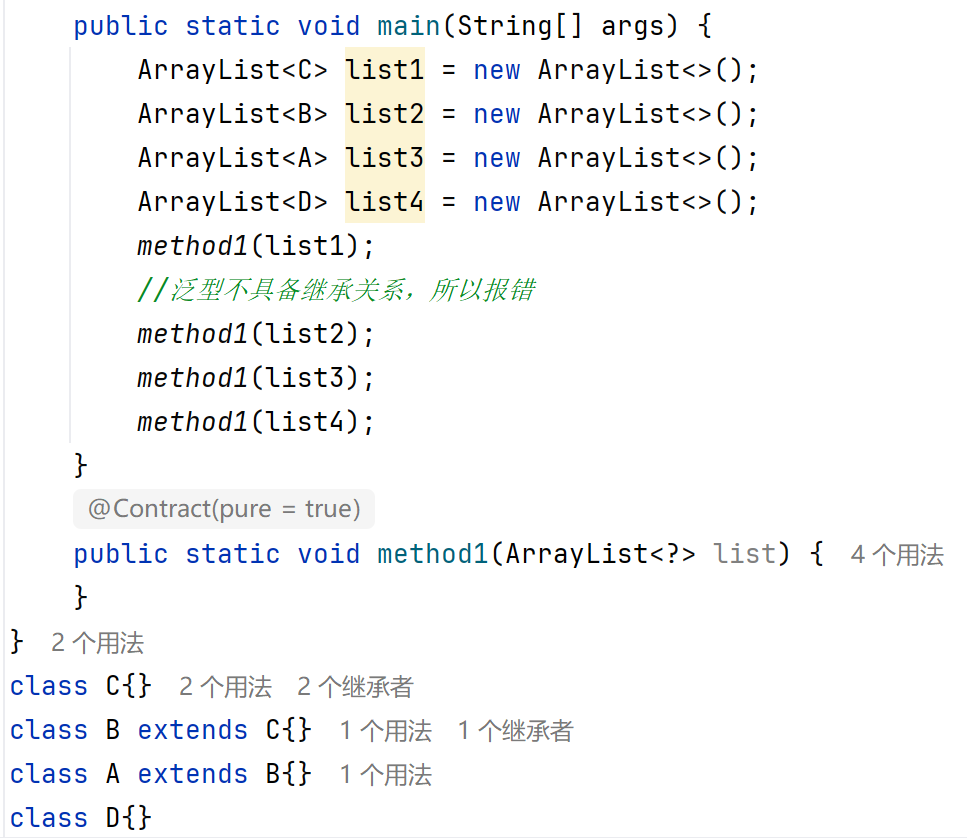
其他两种情况
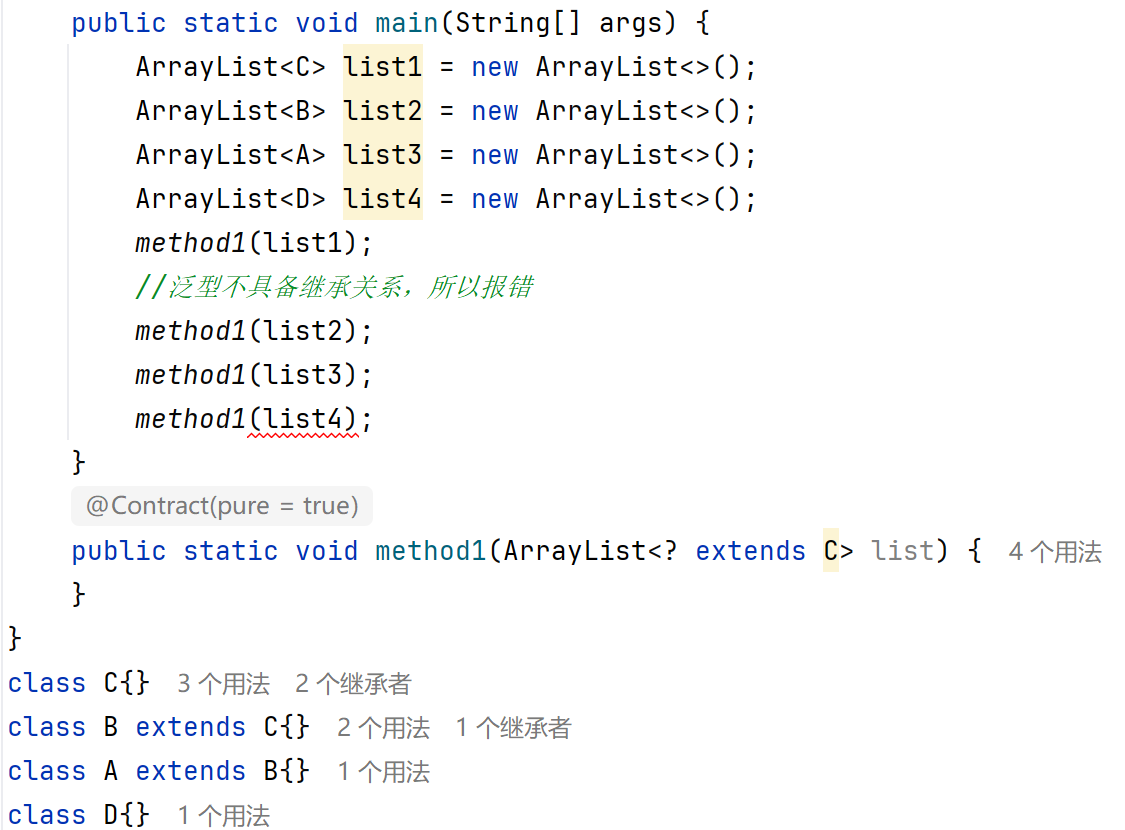
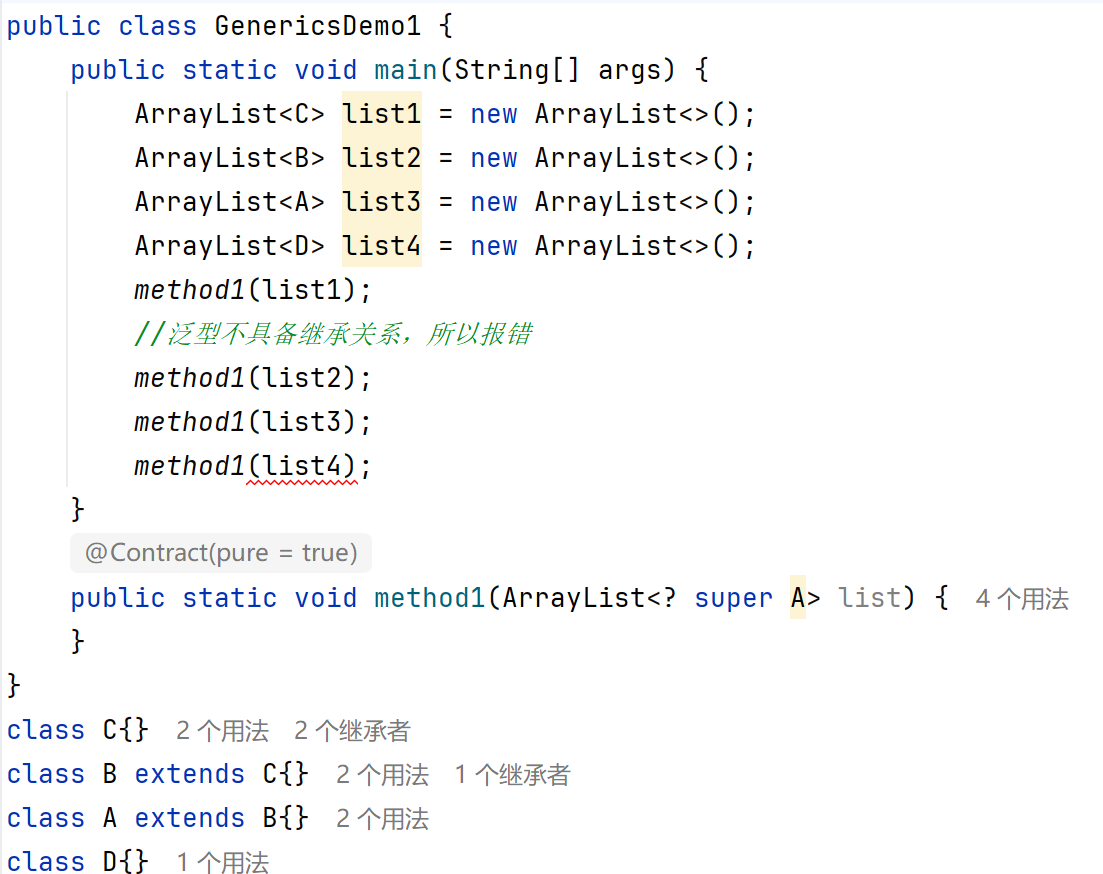
Vector已经被淘汰了,就不讲了。
Set集合
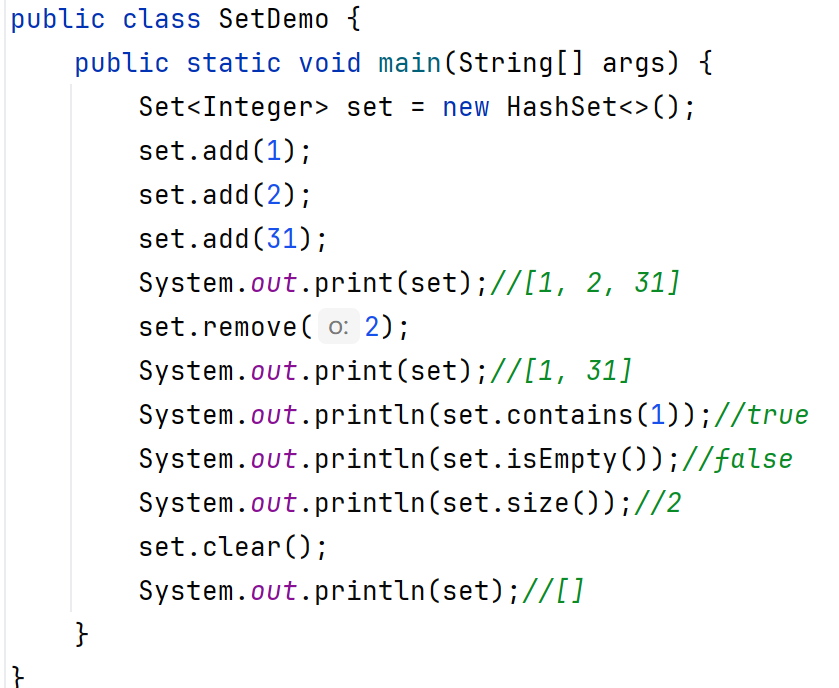
Set接口的方法上基本上与Collection的API一致
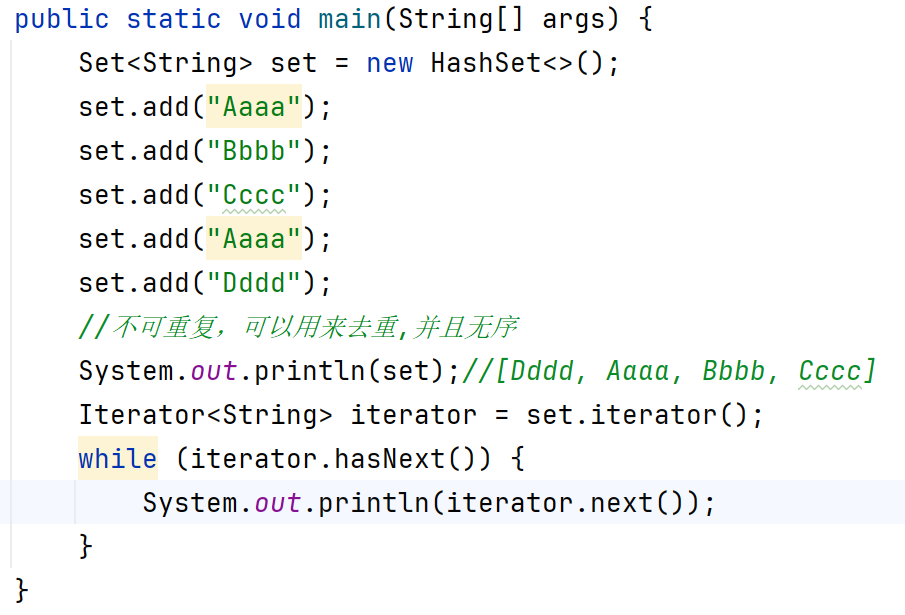
特点:
无序:存取顺序不一致,假如存是1234,那么取就可能是2431、1342等等。
不重复:可以去除重复。
无索引:没有带索引的方法,不能使用普通for循环遍历,也不能通过索引来获取元素。
只可以通过迭代器遍历、增强for遍历、Lambda表达式遍历
实现类
HashSet:无序、不重复、无索引
LinkedHashSet:有序、不重复、无索引
TreeSet:可排序、不重复、无索引
示例Set接口继承Collection接口中的方法
HashSet实现类
HashSet集合底层采取哈希表存储数据;哈希表是一种对于增删改查数据性能都较好的结构。
哈希表的组成:JDK8之前:数组+链表;JDK8之后:数组+链表+红黑树
哈希值
1、根据hashCode方法算出来的int类型的整数
2、该方法定义在Object类中,所有对象都可以调用,默认使用地址值进行计算
3、一般情况下,会重写hashCode方法,利用对象内部的属性值计算哈希值
对象的哈希值特点
1、如果没有重写hashCode方法,不同对象计算出的哈希值是不同的
2、如果已经重写hashcode方法,不同的对象只要属性值相同,计算出的哈希值就是一样的
3、在小部分情况下,不同的属性值或者不同的地址值计算出来的哈希值也有可能一样。(哈希碰撞)
Alt+Insert键系统自动重写hashCode(),equals()两个方法。
底层原理
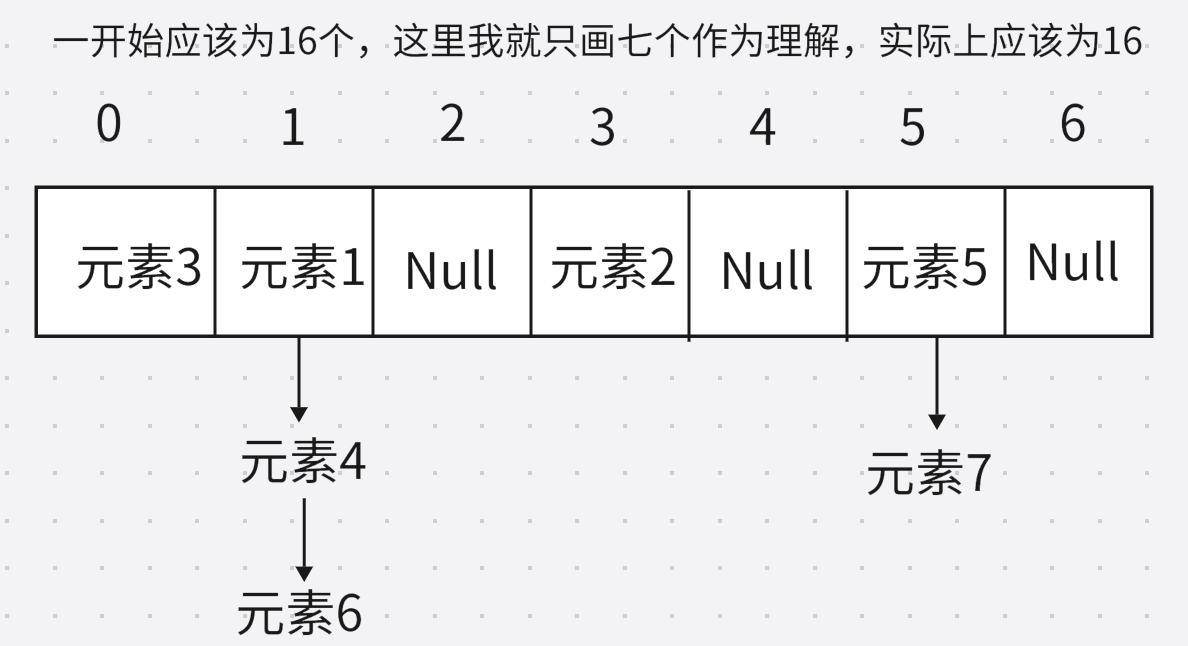
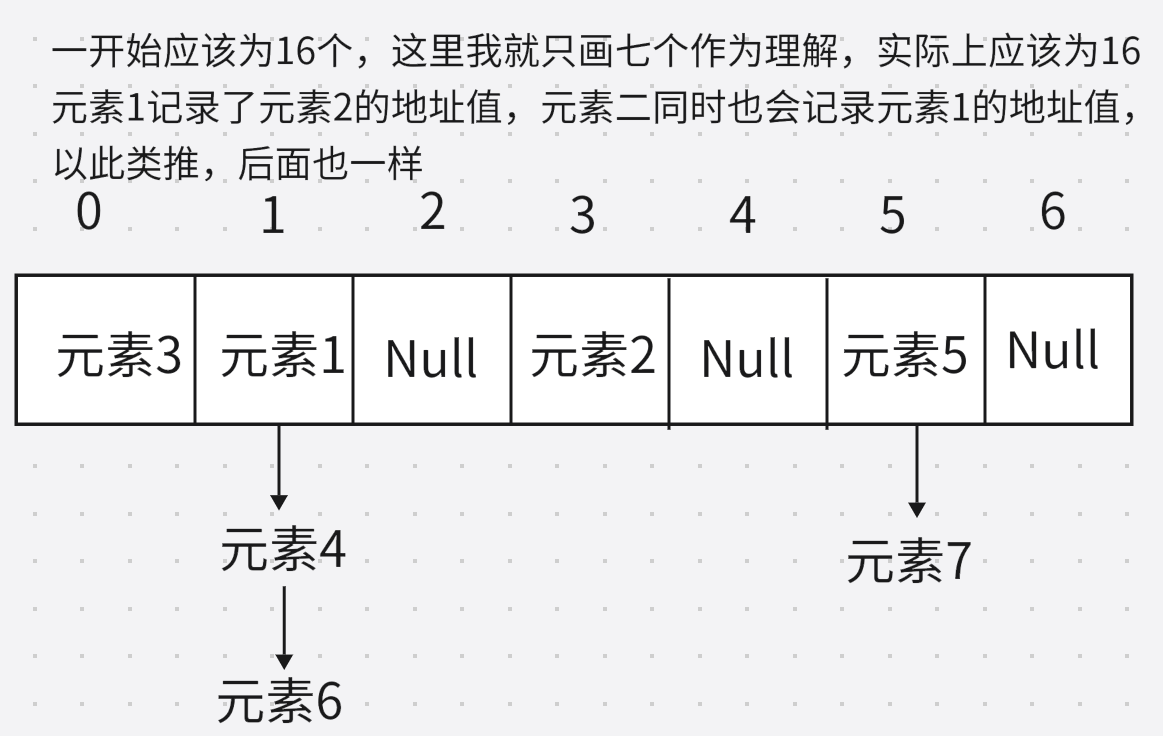
1、创建一个默认长度为16,默认加载因子0.75的数组,数组名table(HashSet<String> set = new HashSet<>();)
2、根据元素的哈希值跟数组的长度计算出应存入的位置(int index=(数组长度-1)&哈希值)
3、判断当前位置是否为null,如果是null直接存入
4、如果位置不为null,表示有元素,则调用equals方法比较属性值
5、一样时不存 不一样时存入数组,形成链表
JDK8以前:新元素存入数组,老元素挂在新元素下面
JDK8以后:新元素直接挂在老元素下面
解释:当存入16*0.75=12个元素时,数组会自动扩容为两倍16->32。当链表长度大于8并且数组长度大于等于64,那么当前长度大于8的链表会自动转为红黑树。
如果集合中存储的时自定义对象(比如Student、Teacher,因为这样才能保证去重,重写方法按照属性值来判断是否重复,如果按照地址值的话,无法保证去重;String、Integer在java底层已经重写好了,我们直接用就可以),必须要重写hasCode和equals方法。
HashSet为什么存和取顺序不一样?
会从0索引开始,一个一个进行遍历,如果有索引中有链表,会把链表遍历结束,再开始下一个索引。
HashSet为什么没有索引?
因为是数组+链表+红黑树混合组成。
HashSet是利用什么机制保证数据去重的?
利用hashCode方法与equals方法保证的
LinkedHashSet底层原理
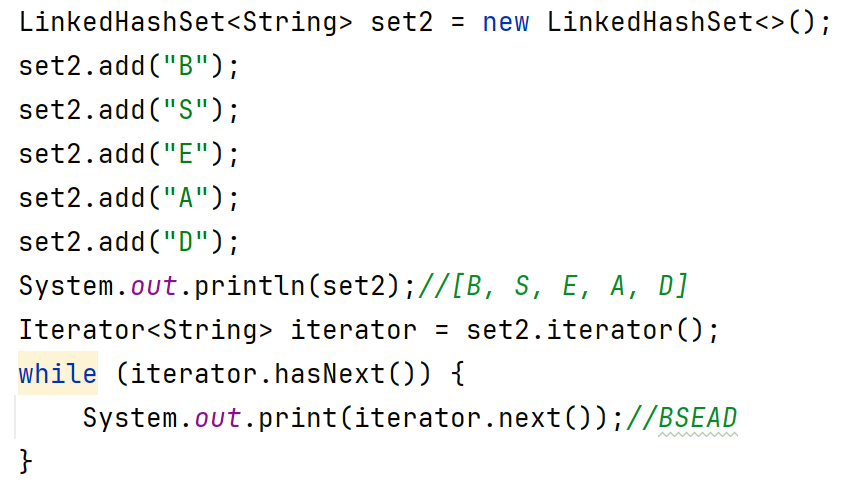
有序:保证存储和取出的元素顺序一致。
原理:底层依然是哈希表,只是每个元素又额外的多了一个双链表的机制记录存储的顺序。
TreeSet
可排序:默认从小到大排序。
TreeSet底层基于红黑树的数据结构实现排序的,增删改查性能都较好。
对于数值类型:Integer、Double等,默认从小到大排列
对于字符、字符串类型:按照字符在ASCll码表中的数字升序排列。
字符串里面内容比较多,从首字母的ASCll值开始挨个比较(一样时比较第二个),和字符长度无关。
对于自定义类型:
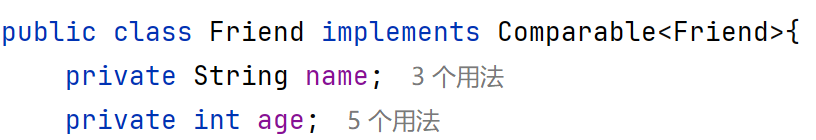
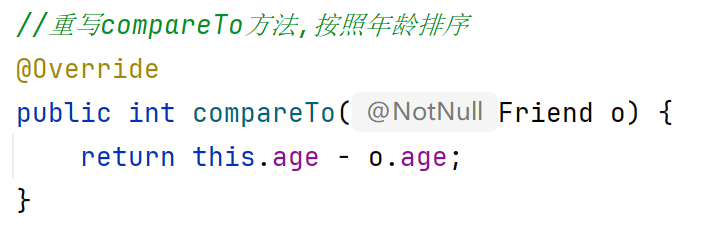
方式一:默认排序/自然排序:Javabean类实现Comparable接口指定比较规则
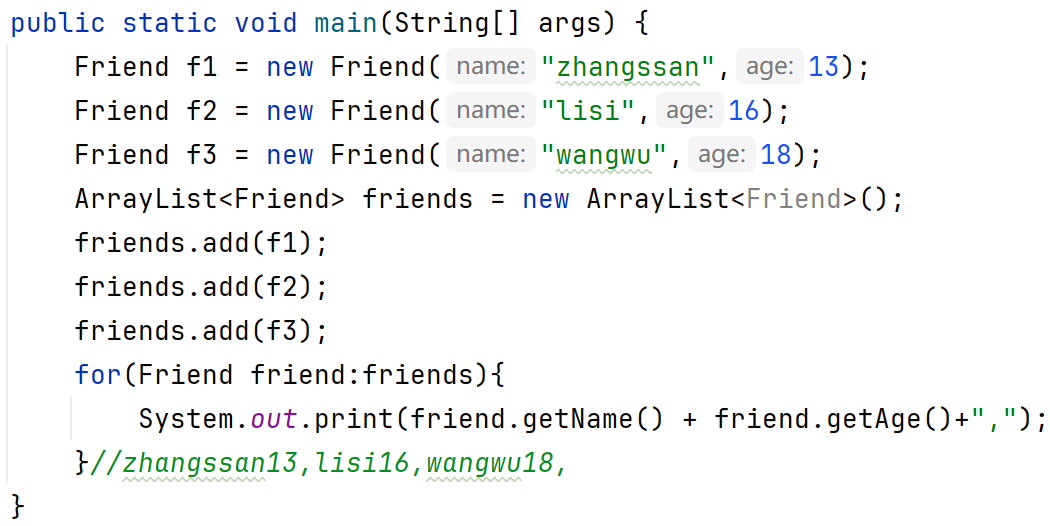
重写compareTo方法的o表示当前红黑树的根节点对象,this表示要插入的对象。如果年龄小插左边发现已经又对象了,那么底层会继续调用compareTo方法,以此类推,如果添加进去发现不满足红黑树,那么会按照红黑树规则来调整成红黑树。
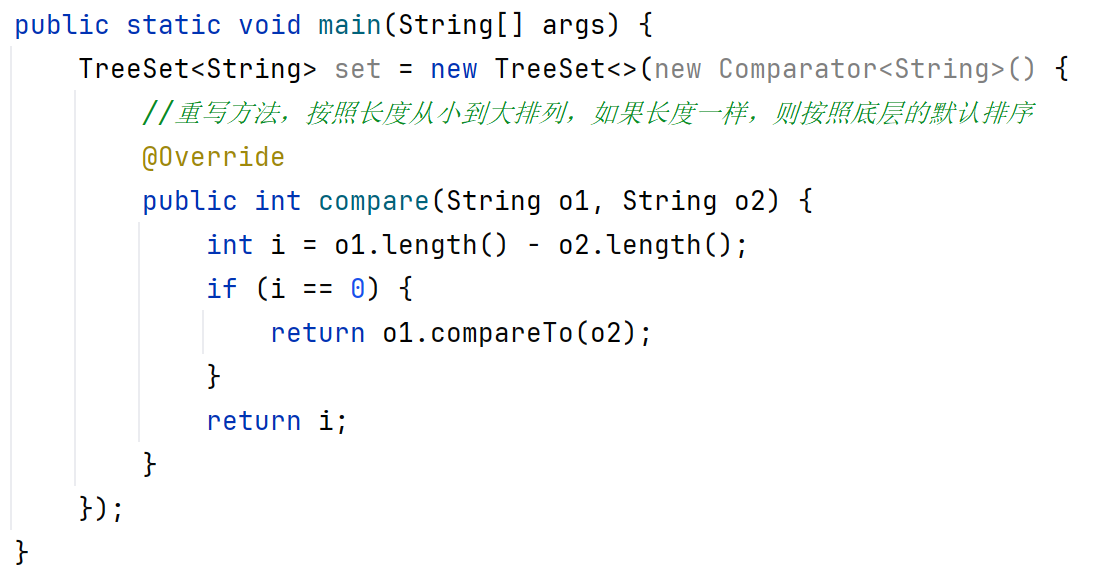
方式二:比较器排序:创建TreeSet对象时,传递比较器Comparator指定规则。
使用规则:默认使用方式一,如果方式一不满足需求,那么才会使用方式二。(比如像String与Integer这两个类像重写排序规则)(如果方式一与方式二同时存在,系统会用方式二)
应用场景
1. 如果想要集合中的元素可重复:用ArrayList集合,基于数组的。(用的最多)
2. 如果想要集合中的元素可重复,而且当前的增删操作明显多于查询:用LinkedList集合,基于链表的。
3. 如果想对集合中的元素去重:用HashSet集合,基于哈希表的。(用的最多)
4. 如果想对集合中的元素去重,而且保证存取顺序:用LinkedHashSet集合,基于哈希表和双链表,效率低于HashSet。
5. 如果想对集合中的元素进行排序:用TreeSet集台,基于红黑树。


教程:从加载到球面映射)


