三、Hadoop1.X及其组件的深度剖析

作者:IvanCodes
日期:2025年5月7日
专栏:Hadoop教程

一、Hadoop 1.X 概述

(一)概念

Hadoop 是 Apache 开发的分布式系统基础架构,用 Java 编写,为集群处理大型数据集提供编程模型,是海量数据存储与计算的开源框架。狭义指Hadoop软件,广义代表大数据生态。Hadoop 1.x 含两大核心:MapReduce 和 HDFS。HDFS 负责分布式存储,MapReduce 负责数据计算。

(二)特点
在这里插入图片描述
在这里插入图片描述

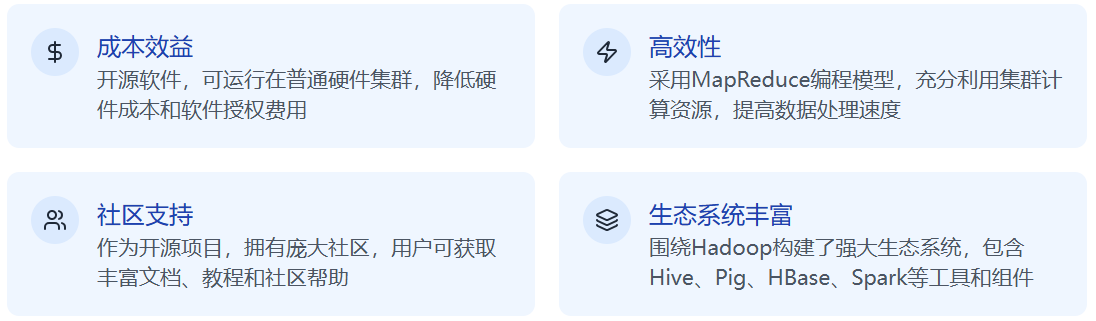
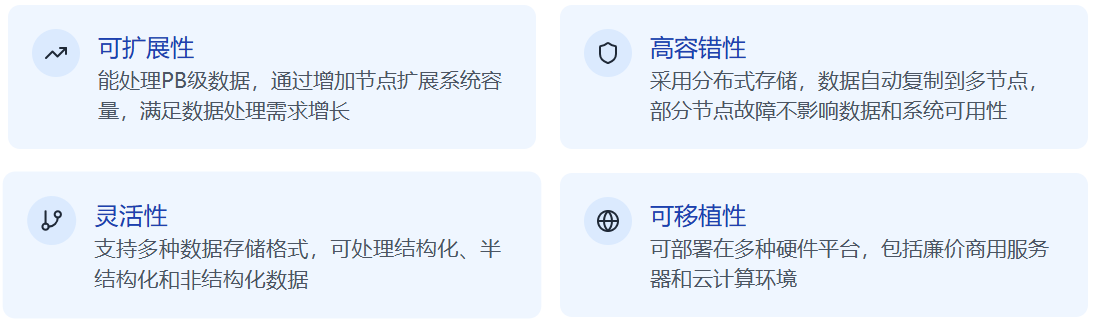
  1. 可扩展性:能处理PB级数据,通过增减节点灵活伸缩。
  2. 高容错性:数据副本机制,部分节点故障不影响系统可用性。
  3. 成本效益:开源,运行于普通硬件,降低软硬件成本。
  4. 高效性:MapReduce并行处理,计算向数据移动,减少网络开销。
  5. 灵活性:支持多种数据格式(结构化、半结构化、非结构化)。
  6. 可移植性:基于Java,可部署于多平台(本地、云)。
  7. 社区支持:庞大活跃的开源社区,资源丰富。
  8. 生态丰富:围绕Hadoop有众多工具(Hive, Pig, HBase, Spark等)。

(三)工作原理

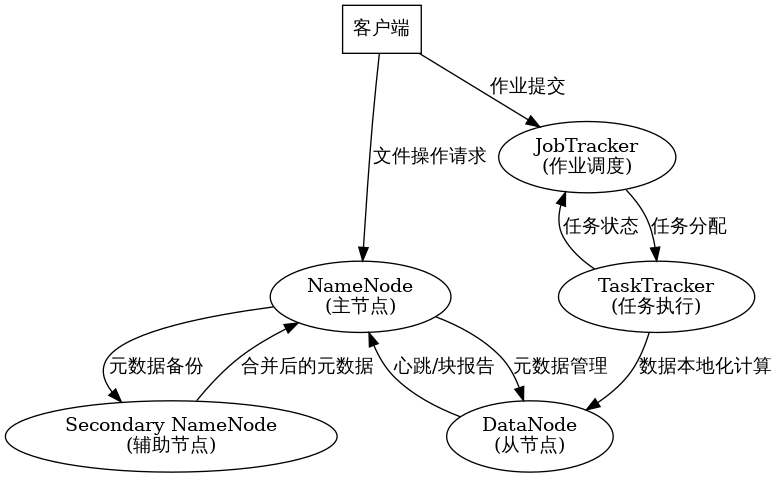
Hadoop 1.x 采用主从架构。核心进程包括:NameNode (HDFS主)、DataNode (HDFS从)、JobTracker (资源管理与作业调度)、TaskTracker (执行任务)。用户提交作业后,JobTracker 调度并将任务分配给TaskTracker。数据存储于HDFS,NameNode管理元数据,DataNode存储实际数据块。
请添加图片描述

(四)发展历史

在这里插入图片描述

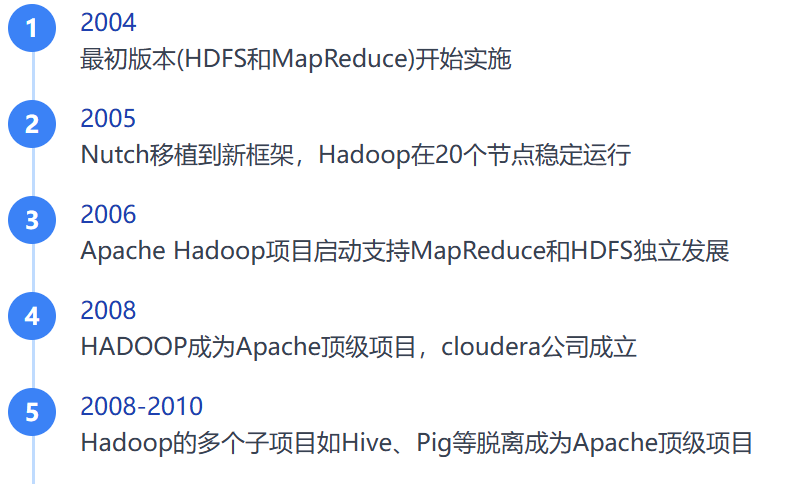
  1. 起源:源于Nutch搜索引擎项目扩展性需求。受Google的GFS和MapReduce论文启发,Nutch开发者实现了HDFS和MapReduce,后剥离成Hadoop。
  2. 发展:2006年Apache Hadoop项目启动,雅虎大力支持。 2008年成Apache顶级项目,Cloudera成立推动商业化。后续生态日渐繁荣,众多公司开始应用。

二、Hadoop 1.X 核心组件

(一)HDFS

1. 概念

HDFS (Hadoop分布式文件系统)是Hadoop数据存储的基础。它高度容错,运行于廉价硬件,通过流式数据访问支持高吞吐量,适合大型数据集。

2. 特点
  • 大文件存储:适合TB、PB级大文件。
  • 分块存储:大文件切块(默认64M),多副本(默认3个)存不同机器,提高读写效率和容错性。
  • 流式访问:“一次写入,多次读取”,不支持文件随机修改,仅支持追加。
  • 廉价硬件:可在普通PC搭建集群。
  • 高容错:副本机制确保节点故障时数据不丢失。
3. 工作原理

HDFS采用Master-Slave架构,含一个NameNode(主)和多个DataNode(从)。

  • NameNode:管理文件系统命名空间(元数据:文件名、目录、块位置等),控制客户端访问。元数据存内存并持久化到磁盘(fsimage, edits log)。
  • DataNode:实际存储文件数据块及校验和。向NameNode注册并周期性发送心跳和块报告。
  • Secondary Namenode:辅助NameNode,定期合并fsimage和edits log,减轻NameNode压力,可能减少宕机时数据丢失。
4. 发展历史

HDFS 的设计思想 深受 Google 的分布式文件系统 GFS 的启发。如前所述,Nutch 项目的核心开发者 Doug Cutting 等人借鉴 GFS 的理念实现了 HDFS,并将其作为 Hadoop 不可或缺的一部分。在 Hadoop 的整个发展过程中,HDFS 也经历了持续的改进和优化,以不断提高其性能、可靠性和可扩展性。

(二)MapReduce

1. 概念

MapReduce是分布式计算框架,第一代离线数据计算引擎,处理TB、PB级数据。核心思想是计算分Map和Reduce两阶段。

2. 特点
  • 分而治之:Map阶段并行局部处理,Reduce阶段并行全局汇总。
  • 移动计算:计算程序移至数据节点,减少网络I/O。
3. 工作原理
  • 输入切片:文件逻辑切片(InputSplit),每Split一Map Task。
  • Map阶段:Map Task处理输入数据,输出中间键值对。
  • Shuffle阶段:Map中间结果 复制、排序、分组到Reduce Task。
  • Reduce阶段:Reduce Task汇总相同key的中间值,输出最终结果。
4. 发展历史

MapReduce 的思想根源于 Google 在 2004年发表的著名论文《MapReduce: Simplified Data Processing on Large Clusters》。在 Hadoop 1.x 版本中,MapReduce 不仅承担了分布式数据计算的核心角色,其内部的 JobTracker 组件还同时负责了集群的资源管理和作业调度。这种设计使得 MapReduce 框架显得比较臃肿,并且限制了 Hadoop 集群只能运行 MapReduce 类型的任务。从 Hadoop 2.x 版本开始,官方对 MapReduce 的功能进行了拆分,引入了独立的资源管理框架 YARN。此后,MapReduce (通常称为 MapReduce on YARN 或 MRv2) 仅专注于其作为分布式数据计算引擎的核心职责。

三、Hadoop 1.X 组件关联分析

(一)组件关联图说明
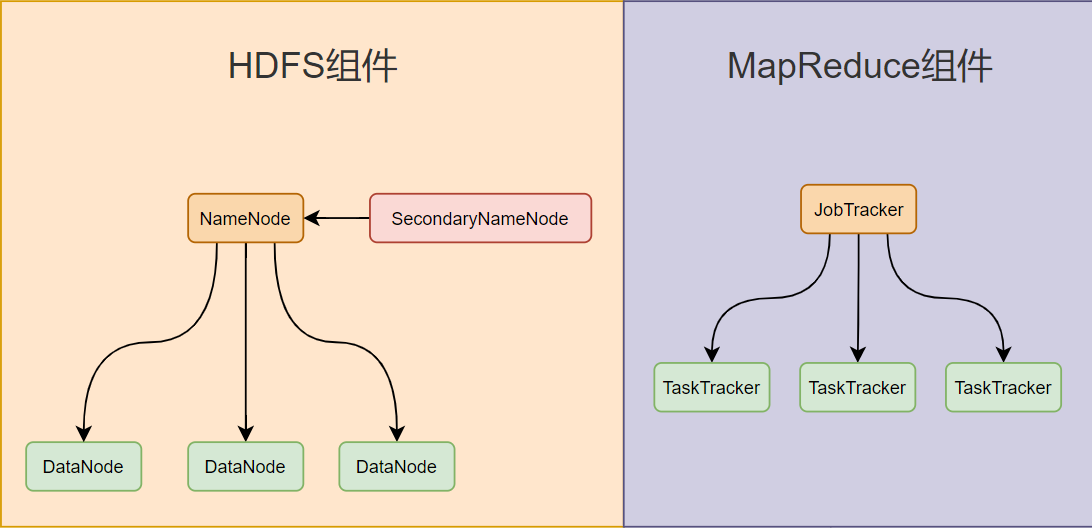
在这里插入图片描述

(二)协同工作机制

HDFS和MapReduce在Hadoop1.X中紧密协作。
HDFS为MapReduce提供数据存储。NameNode提供元数据,DataNode存储数据块。MapReduce的Map Task从DataNode读取数据。
MapReduce利用HDFS数据进行计算。Map Task局部处理,Reduce Task全局汇总。JobTracker负责资源管理和作业调度,将任务分配给TaskTracker,考虑数据本地性。

例如,日志分析:日志存HDFS。MapReduce作业启动,JobTracker将Map Task分配到数据节点。Map Task局部分析。Shuffle后,Reduce Task汇总,结果写回HDFS。

四、Hadoop 1.X 与其他版本的对比

Hadoop 1.x vs Hadoop 2.x

  • YARN引入:最核心区别。Hadoop 2.x引入YARN,分离资源管理与计算,支持多种计算框架(Spark等),不再局限于MapReduce。
  • 存储与容错:Hadoop 2.x支持纠删码,比1.x的3副本方案更节省存储。
  • 单点故障:Hadoop 1.x的NameNode和JobTracker存在单点故障。Hadoop 2.x引入HA机制解决此问题,提高集群可靠性。

本文来自互联网用户投稿,该文观点仅代表作者本人,不代表本站立场。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如若转载,请注明出处:http://www.tpcf.cn/diannao/82078.html

如若内容造成侵权/违法违规/事实不符,请联系多彩编程网进行投诉反馈email:809451989@qq.com,一经查实,立即删除!

相关文章

Java中字符转数字的原理解析 - 为什么char x - ‘0‘能得到对应数字

前言 在Java编程中,我们经常需要将字符形式的数字转换为实际的数值。有很多方法可以实现这一转换,比如使用Integer.parseInt()或Character.getNumericValue()等方法。但有一种简便且高效的方式是直接使用char - 0运算,本文将详细解析这种方法…

第5讲、Transformer 编码器(Encoder)处理过程详解

🔍 Transformer 编码器(Encoder)处理过程详解 Transformer Encoder 是一个由 N 层(一般为 6 层)堆叠而成的模块结构。每一层的本质是两个核心子模块: 多头自注意力(Multi-Head Self-Attention…

SWiRL:数据合成、多步推理与工具使用

SWiRL:数据合成、多步推理与工具使用 在大语言模型(LLMs)蓬勃发展的今天,其在复杂推理和工具使用任务上却常遇瓶颈。本文提出的Step-Wise Reinforcement Learning(SWiRL)技术,为解决这些难题带…

【Windows 常用工具系列 22 -- vscode markdown preview 字体大小设置】

文章目录 解决办法 解决办法 打开设置(快捷键 Ctrl , 。或者左下角图标齿轮 ⚙)搜索设置选项 Markdown › Preview: Font Size控制 Markdown 预览中使用的字号(以像素为单位)。 推荐阅读 https://blog.csdn.net/yanglsbb/article/details/127306685

【风控】模型监控和异常处理

在风控模型的全生命周期中,模型监控与异常处理是保障模型持续、稳定、可靠运行的关键环节。本指南旨在提供系统化、可落地的监控指标、预警策略及异常处置流程,帮助团队快速定位、响应并修复线上模型问题,最大限度降低风险。 1.模型监控与预…

第4章 递推法

4.1 递推法概述 设计思想: 递推法(Recurrence Method)通过已知的初始条件和递推关系,逐步推导出问题的最终结果,常用于序列计算和分阶段问题求解。 示例:猴子和桃子问题 题目描述: 猴子每天吃…

可视化魔法指南

🎨 ECharts数据可视化魔法指南 🌟 ECharts:数据的艺术画笔 #mermaid-svg-ARwFHUrXBJ03Gpo9 {font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}#mermaid-svg-ARwFHUrXBJ03Gpo9 .error-icon{fill:#552222;}#mermaid-svg-ARwFHUr…

SpringBoot学生宿舍管理系统开发实现

概述 一款基于SpringBoot框架开发的学生宿舍管理系统完整项目,该系统包含管理员、学生、宿管员和维修员四大角色模块,功能完善,非常适合作为设计或二次开发的基础项目。 主要内容 5.1 管理员功能模块 管理员登录界面采用验证码验证机制&a…

同步 / 异步、阻塞 / 非阻塞

前言 同步异步,在计算机科学中是一个非常重要的概念。作为一位软件开发工程师,我们每天都在和同步和异步打交道。 同步 同步-阻塞,顾名思义,就是同步和阻塞。调用方法后,必须等到结果返回,才能继续执行别…

AOP封装进行批量的数据查询并填充

在我们日常的项目开发中,我们经常会遇到这样的问题。我们有一张用户表,用户表中有用户ID和用户名称。我们其他表中会记录我们当前操作人的ID,一般,我们会记录一个创建人ID和修改人ID。那么,这个时候问题来了&#xff0…

Java学习手册:数据库事务相关知识

一、事务的概念与特性 概念 :事务是数据库中一系列操作的集合,这些操作要么全部成功,要么全部失败,是一个不可分割的工作单位。例如,在银行转账系统中,从一个账户扣款和向另一个账户存款这两个操作必须作为…

java复杂度,包装类,泛型解析

如何衡量代码的好坏? 评价代码的好坏我们使用算法效率来判断,而算法效率分两种: 算法效率: 第一种是时间效率,第二种是空间效率,时间效率被称为时间复杂度,⽽空间效率被称作空间复杂度。 时间…

基于 SpringBoot + Vue 的校园管理系统设计与实现

一、项目简介 本系统以校园组织管理为主线,结合用户权限分离机制与模块化设计,实现对“单位类别、单位、通知推送、投票信息、用户回复”等内容的全流程管理,广泛适用于教育局、高校及下属组织的信息管理工作。 🎯 项目亮点&…

iOS蓝牙技术实现及优化

以下是针对2025年iOS蓝牙技术实现的核心技术要点的深度解析,结合当前iOS 18(推测版本)的最新特性与开发实践,分模块结构化呈现: 一、硬件与协议层适配 BLE 5.3 支持 iOS 18默认支持蓝牙5.3协议,需注意&…

Qt 中实现观察者模式(Observer Pattern)

在 Qt 中实现**观察者模式(Observer Pattern)通常利用其内置的信号与槽(Signals & Slots)**机制,这是最符合 Qt 设计哲学的方式。以下是详细实现方法和关键点: —### 1. 观察者模式的核心思想- Subject(被观察者):维护一个观察者列表,在状态变化时通知观察者。- …

写程序,统计两会政府工作报告热词频率,并生成词云

import jieba from collections import Counter from wordcloud import WordCloud import matplotlib.pyplot as pltdef generate_wordcloud():try:# 读取文本文件with open(E:\\桌面\\s.txt, r, encodingutf-8) as file:text file.read()# 中文分词words jieba.lcut(text)# …

【Science Advances】普林斯顿大学利用非相干光打造可重构纳米光子神经网络

(导读 ) 人工智能对计算性能需求剧增,电子微处理器发展受功耗限制。光学计算有望解决这些问题,光学神经网络(ONNs)成为研究热点,但现有 ONNs 因设计缺陷,在图像分类任务中精度远低于现代电子神经网络&#…

gin + es 实践 01

项目结构说明 目录结构概览 Go-ES 项目采用领域驱动设计(DDD)架构,目录结构清晰,各层次职责分明。以下是项目的主要目录结构: go-es/ ├── cmd/ # 应用程序入口 │ └── api/ …

如何构建直播美颜SDK?从美颜API调用逻辑到GPU优化实战

随着短视频和直播行业的爆发,美颜SDK已成为各大直播平台的“标配”。从基础的磨皮、美白,到如今的AI滤镜、虚拟形象,这些功能的背后都离不开高效的美颜SDK支持。那么,如何构建一款性能优越、体验流畅的直播美颜SDK呢?本…

高组装导轨的特点

高组装导轨通常是四列式单圆弧齿形接触直线导轨,具有整合化的结构设计,适用于重负荷和精密应用。与其它直线导轨高组装导轨提升了负荷与刚性能力,具备四方向等负载特色和自动调心功能,能够吸收安装面的装配误差,达到高…