任务一 理解OpenStack计算服务
1.1 •什么是Nova
• Nova是OpenStack中的计算服务项目 ,计算虚拟机实例生命周期的所有活动都由 Nova 管理 。
• Nova 提供统一的计算资源 服务。
• Nova 需要下列 OpenStack 服务的 支持。
Ø Keystone :为所有的 OpenStack 服务提供身份管理和认证。
Ø Glance :提供计算用的镜像库 。
Ø Neutron :负责配置管理计算实例启动时的虚拟或物理网络连接。
Ø Placement :负责跟踪云中可用的资源 库存。
1.2 •Nova所用的虚拟化技术
• KVM——通用的开放虚拟化技术。
• Xen —— 部署 最快速、最安全、开源的虚拟化软件 技术。
• Linux 容器 —— 在 单一 Linux 主机上提供多个隔离的 Linux 环境的操作系统级虚拟化技术 。
• Hyper- vare ——Microsoft 公司推出的企业级虚拟化解决方案 。
• VMware ESXi ——VMware 用于 创建和运行虚拟机和虚拟 设备的产品。
• Baremetal 与 Ironic—— 传统 的物理机服务 。
1.3 •Nova的系统架构
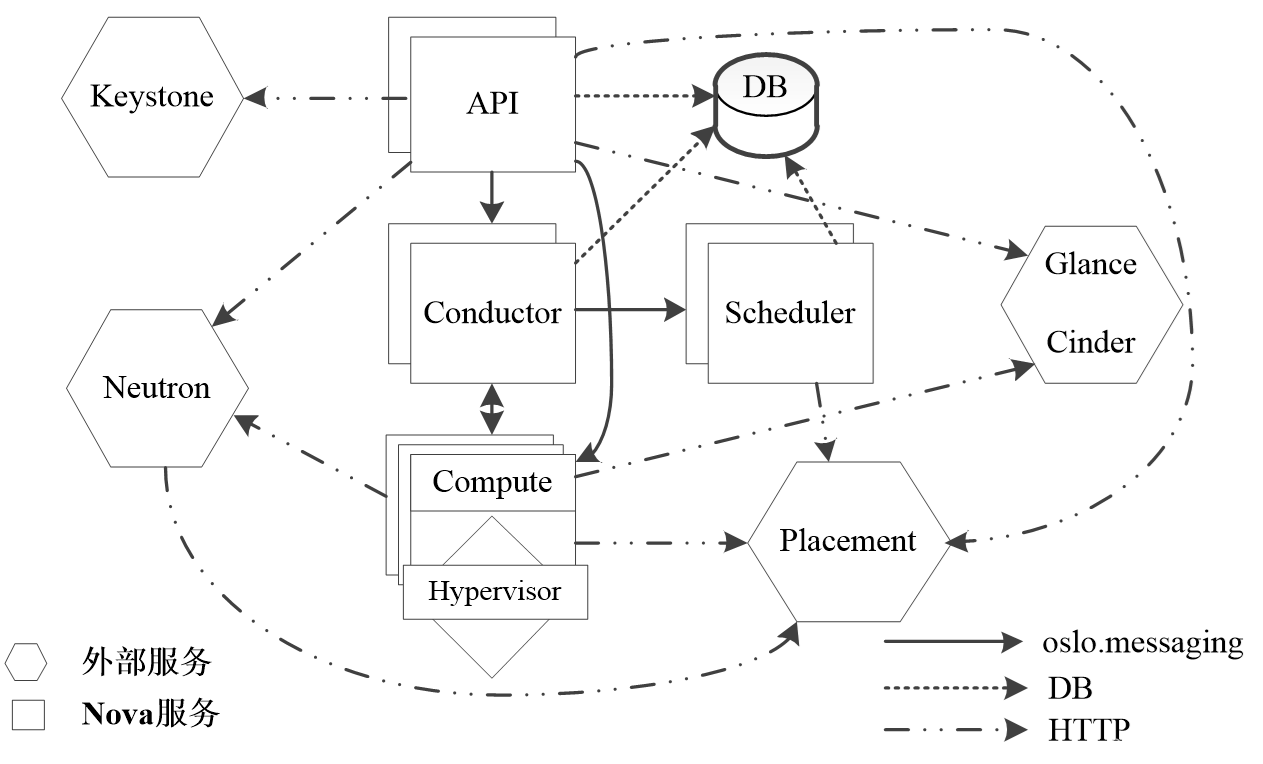
1.4 •虚拟机实例化流程
(1)用户执行Nova客户端提供的用于创建虚拟机实例的命令。
(2)API组件将请求转换为AMQP消息之后加入消息队列,通过消息队列调用Conductor组件。
(3)Conductor组件从消息队列中接收到虚拟机实例化请求消息后,进行一些准备工作。
(4)Conductor组件通过消息队列通知Scheduler组件选择一个合适的计算节点来创建虚拟机实例。
(5)Conductor组件从Scheduler组件处得到合适的计算节点信息后,通过消息队列通知Compute组件实现虚拟机实例的创建。
1.5 •验证Nova服务
• 查看 当前运行的 Nova 服务。
[root@node-a ~]# systemctl status *nova*.service
Ø openstack -nova- scheduler.service —— 计算 调度子 服务
Ø openstack -nova- compute.service —— 计算 子 服务
Ø openstack -nova- conductor.service —— 处理 需要调度的请求的子 服务
Ø openstack -nova- novncproxy.service —— 为 通过 VNC 连接访问正在运行的虚拟机实例提供一个 代理
1.6 •试用计算服务的API
• Nova 支持 3 个 API 端点
Ø / :列出可用的版本。
Ø / v2 :计算 API 的第 1 个版本,可进行扩展。
Ø / v2.1 :除了使用 Microversion (小版本)之外,与 v2 版本相同。
• 列出 所有可用的主版本列表。
curl -s -H "X-Auth-Token: $OS_TOKEN" http://localhost:8774/
• 试用 API
(1)请求一个demo项目作用域的令牌。
(2)导出环境变量OS_TOKEN,将其值设置为上述操作获取的令牌ID。
(3)尝试通过Nova API v2.1获取当前实例列表。
curl -s -H "X-Auth-Token: $OS_TOKEN" http://localhost:8774/v2.1/servers
任务二 创建和管理虚拟机实例
2.1 •nova-api服务
• nova-api服务接收和响应来自最终用户的计算API请求。
• 最终 用户不会直接发送 RESTful API 请求,而是通过 OpenStack 命令行、仪表板和其他需要跟 Nova 交换的组件 使用 API 。
•nova-api是外部访问并使用Nova提供的各种服务的唯一途径 ,也是客户端和 Nova 之间的中间层 。
2.2 •nova-scheduler服务
• nova-scheduler 服务解决 选择启动虚拟机实例的计算节点的问题 。
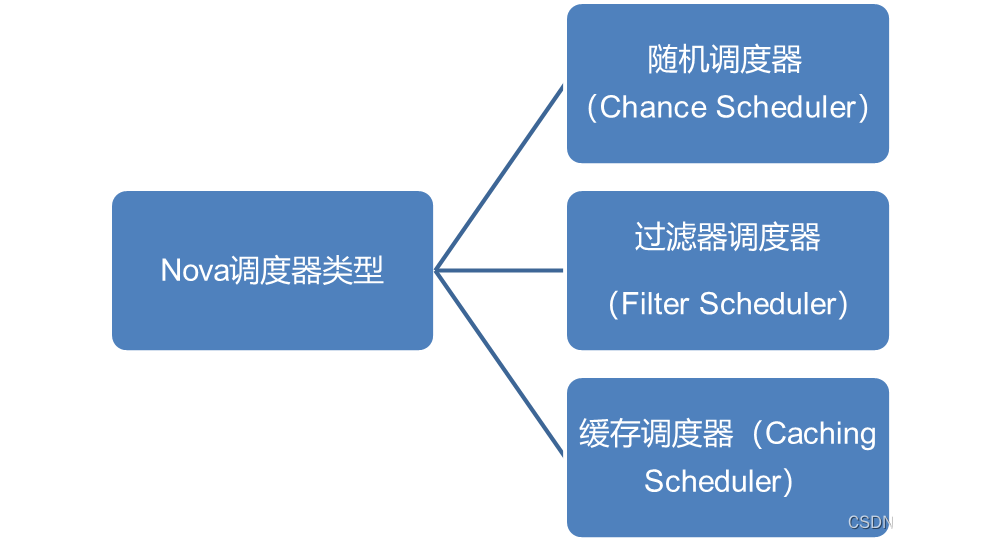
• nova-scheduler 服务按照 实例类型去选择合适的计算节点 。
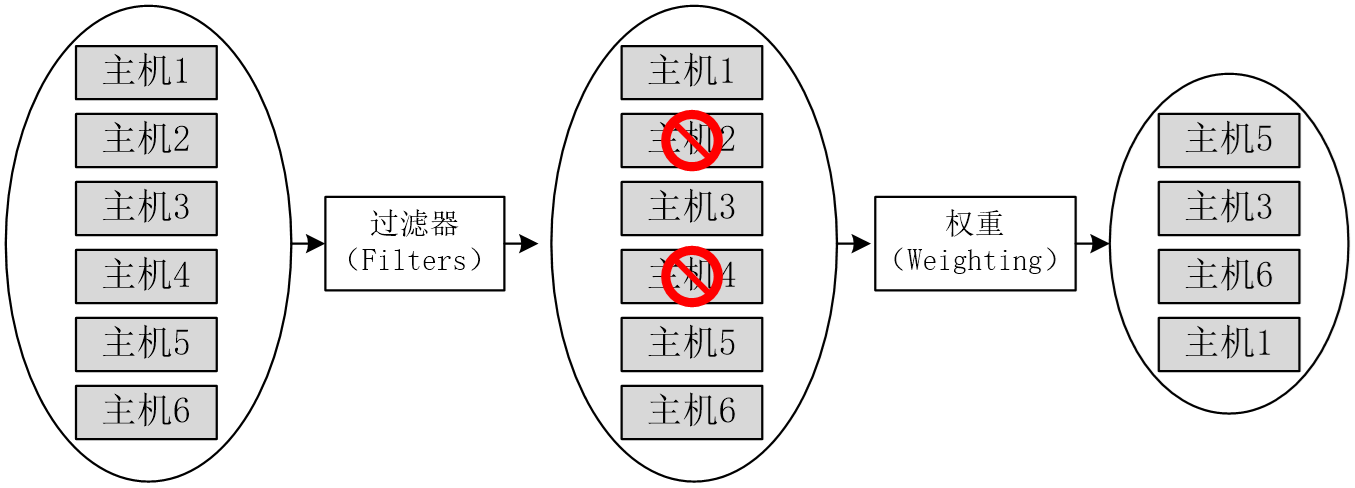
• ( 2 )过滤器调度器调度过程。过滤器调度器的调度过程分为两个阶段。第 1 个阶段通过指定的过滤器选择满足条件的计算节点(运行 nova-compute 服务的主机),例如内存使用率低于 50% ,可以使用多个过滤器依次进行过滤。第 2 个阶段对过滤之后的主机列表进行权重计算并排序,选择最优(权重值最大)的计算节点来创建虚拟机实例。
• 这里展示调度过程的一个实例,如图 6-2 所示。刚开始有 6 个可用的计算节点主机,通过多个过滤器层层过滤,将主机 2 和主机 4 排除了。剩下的 4 个主机再通过计算权重与排序,按优先级从高到低依次为主机 5 、主机 3 、主机 6 和主机 1 ,主机 5 权重值最高,最终入选。
•
• 图 6-2 过滤调度器调度过程
• ( 3 )过滤器。当过滤器调度器需要执行调度操作时,会让过滤器对计算节点进行判断,返回 True (真)或 False (假)。 / etc /nova/ nova.conf 配置文件中的 scheduler_available_filters 选项用于配置可用的过滤器,默认所有 Nova 内置的过滤器都可以用于执行过滤操作。
• scheduler_available_filters = nova.scheduler.filters.all_filters
• 另外还有一个 scheduler_default_filters 选项用于指定 nova-scheduler 服务要使用的过滤器,其默认值如下。
• scheduler_default_filters = RetryFilter , AvailabilityZoneFilter , RamFilter , DiskFilter , ComputeFilter , ComputeCapabilitiesFilter , ImagePropertiesFilter , ServerGroupAntiAffinityFilter , ServerGroupAffinityFilter
• 过滤器调度器将按照选项值列表中的顺序依次过滤。各过滤器的简介如表 6-1 所示。
•
• 表 6-1 Nova 内置的过滤器
• 过滤器 说明
• RetryFilter (再审过滤器) 用于过滤掉之前已经调度过的节点
• AvailabilityZoneFilter (可用区域过滤器) 用于将不属于指定可用区域的计算节点过滤掉。为提高容灾性和提供隔离服务,可以将计算节点划分到不同的可用区域中
• RamFilter (内存过滤器) 根据可用内存来调度,将不能满足实例类型内存需求的计算节点过滤掉
• DiskFilter (磁盘过滤器) 根据可用磁盘空间来调度,将不能满足实例类型磁盘需求的计算节点过滤掉
• CoreFilter (核心过滤器) 根据可用 CPU 核心来调度,将不能满足实例类型 vCPU 需求的计算节点过滤掉
• ComputeFilter (计算过滤器) 只有 nova-compute 服务正常工作的计算节点才能够被 nova-scheduler 服务调度,这是必选的过滤器
• ComputeCapabilitiesFilter (计算能力过滤器) 根据计算节点的特性来过滤
• ImagePropertiesFilter (镜像属性过滤器) 根据所选镜像的属性来过滤
• ServerGroupAntiAffinityFilter (服务器组反亲和性过滤器) 要求尽量将虚拟机实例分散部署到不同的计算节点上
• ServerGroupAffinityFilter (服务器组亲和性过滤器) 要求尽量将虚拟机实例部署到同一个计算节点上
•
• ( 4 )权重计算。 nova-scheduler 服务可以使用多个过滤器依次进行过滤,过滤之后的节点再通过计算权重选出最合适的能够部署虚拟机实例的节点。如果有多个计算节点通过了过滤,那么最终选择哪个节点还需要进一步确定。可以为这些主机计算权重值并进行排序,得到一个最佳的计算节点。这个过程需要调用指定的各种 Weighter 模块,得出主机的权重值。
• 所有的权重实现模块位于 nova/scheduler/weights 目录下。目前 nova-scheduler 的默认权重实现模块是 RAMWeighter ,根据计算节点空闲的内存量来计算权重值,空闲内存越多,权重越大,虚拟机实例将被部署到当前空闲内存最多的计算节点上。
• 过滤器 调度器调度 过程
第1阶段:通过指定的过滤器选择满足条件的计算节点。
第2阶段:对过滤之后的主机列表进行权重计算并排序,选择最优的计算节点来创建虚拟机实例。
• 过滤器
Ø RetryFilter (再审过滤器 )
Ø AvailabilityZoneFilter (可用区域过滤器 )
Ø RamFilter (内存过滤器 )
Ø DiskFilter (磁盘过滤器 )
Ø CoreFilter (核心过滤器 )
Ø ComputeFilter (计算过滤器 )
Ø ComputeCapabilitiesFilter (计算能力过滤器 )
Ø ImagePropertiesFilter (镜像属性过滤器 )
Ø ServerGroupAntiAffinityFilter (服务器组反亲和性过滤器 )
Ø ServerGroupAffinityFilter (服务器组亲和性过滤器 )
• 权重计算
Ø nova-scheduler 服务可以使用多个过滤器依次进行过滤,过滤之后的节点再通过计算权重选出最合适的能够部署虚拟机实例的节点 。
Ø 所有的权重实现模块位于 nova/scheduler/weights 目录下 。
Ø 目前 nova-scheduler 的默认权重实现模块是 RAMWeighter ,根据计算节点空闲的内存量来计算权重 值。
2.3 •nova-compute服务
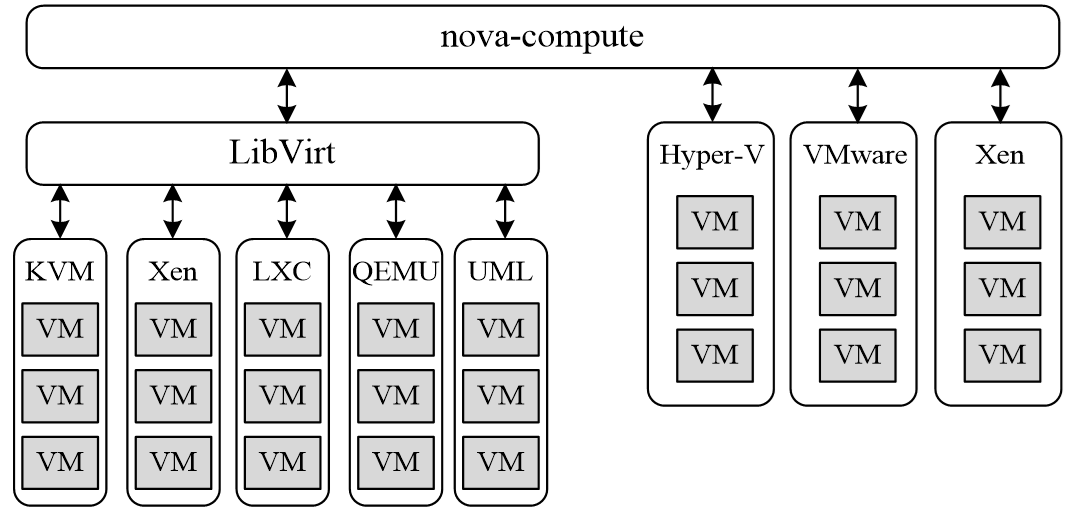
• nova-compute 在计算节点上运行,负责管理节点上的虚拟机实例 。
• 创建 虚拟机实例最终需要与 Hypervisor 打交道。 Hypervisor 以驱动形式 在 OpenStack 系统中实现即插即 用。
nova-compute与Hypervisor一起实现OpenStack对虚拟机实例生命周期的管理。
2.4 •nova-conductor服务
• nova-conductor 服务对数据库进行操作。
• nova-conductor 作为 nova-compute 服务与数据库之间交互的中介,避免了直接访问由 nova-compute 服务创建的云数据库 。
• nova-conductor 将 nova-compute 与数据库分离之后提高了 Nova 的可伸缩性 。
• nova-conductor 方便升级。
2.5 •Nova计算服务与Placement放置服务
• OpenStack 从 Stein 版本开始 将 Placement API 作为 一个独立的项目,提供的是放置服务,用于满足计算服务和其他任何服务的资源选择和使用的管理需求。
• nova-compute 中的 Nova 资源跟踪器负责创建对应于运行资源跟踪器的计算主机资源提供者 记录。
• nova-scheduler 负责为工作负载选择合适的目标主机。
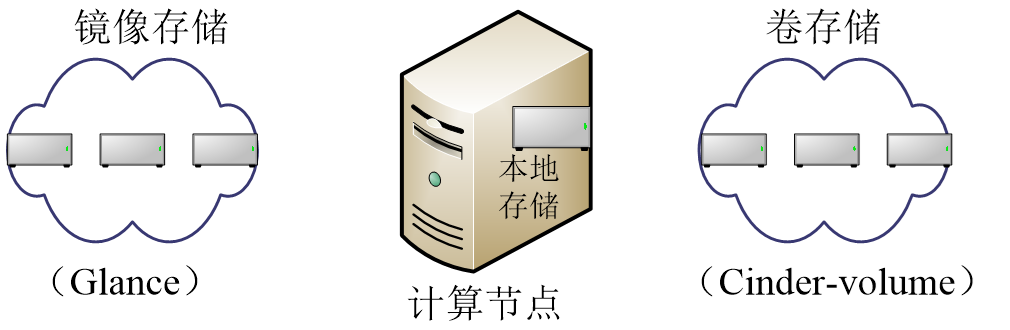
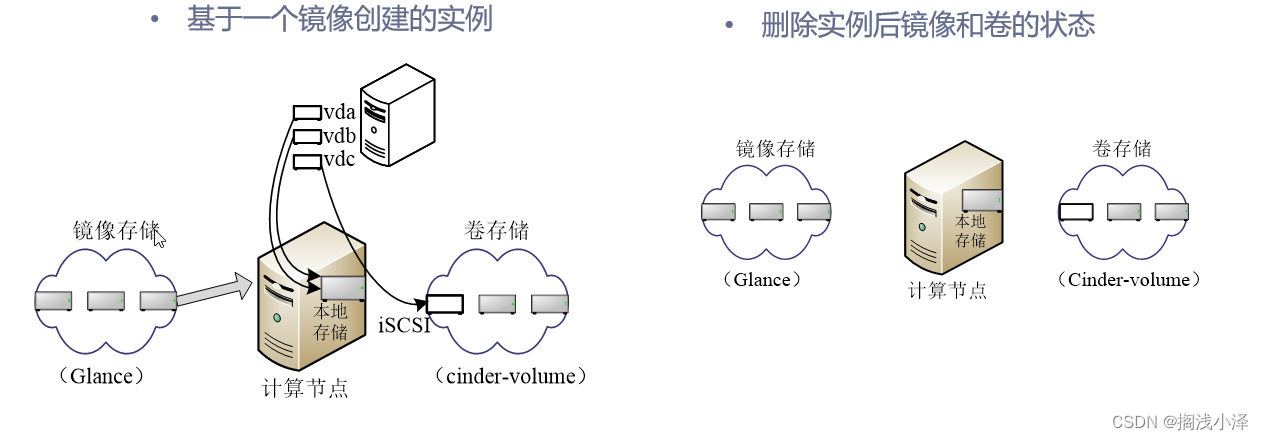
2.6 •镜像和实例的关系
• 实例是在云中的计算节点上运行的虚拟机个体 。
• 虚拟机镜像为 虚拟机文件系统提供模板 。
• 对 实例所做的任何改变都不会影响基础镜像 。
• 计算 服务控制实例、镜像的存储和管理。
• 未运行虚拟机实例的基础镜像状态
2.7 •命令行的实例创建用法
• 查看 所需的前提 条件
Ø openstack flavor list # 列出可用的实例类型
Ø openstack image list # 列出可用的镜像
Ø openstack network list # 列出可用的网络
Ø openstack security group list # 列出可用的安全组
openstack keypair list #列出可用的密钥对
• 创建实例命令
openstack server create
(--image <镜像> | --volume <卷>)
--flavor <实例类型>
[--security-group <安全组>]
[--key-name <密钥对>]
[--property <服务器属性>]
[--file <目的文件名=源文件名>]
[--user-data <实例注入文件信息>]
[--availability-zone <域名>]
[--block-device-mapping <块设备映射>]
[--nic <net-id=网络ID,v4-fixed-ip=IP地址,v6-fixed-ip=IPv6地址,port-id=端口UUID,auto,none>]
[--network <网络>]
[--port <端口>]
[--hint <键=值>]
[--config-drive <配置驱动器卷>|True]
[--min <创建实例最小数量>]
[--max <创建实例最大数量>]
[--wait]
<实例名>
2.8 •命令行的实例管理用法
(1)获取列表
openstack server list
(2)查看实例详情
openstack server show [--diagnostics] <实例名或ID >
(3)启动实例
openstack server start <实例名或ID> [<实例名或ID > ...]
(4)暂停实例及恢复
openstack server [pause | unpause] <实例名或ID> [<实例名或ID > ...]
(5)挂起实例及恢复
openstack server [suspend | resume] <实例名或ID> [<实例名或ID > ...]
(6)废弃实例及恢复
openstack server [shelve | unshelve]<实例名或ID> [<实例名或ID > ...]
(7)关闭实例
openstack server stop <实例名或ID> [<实例名或ID > ...]
(8)重启实例
openstack server reboot [--hard | --soft] [--wait] <实例名或ID>
(9)调整实例大小
openstack server resize [--flavor <flavor> | --confirm | --revert] [--wait] <实例名或ID>
(10)删除实例
openstack server delete <实例名或ID> [<实例名或ID > ...]
(11)修改实例
openstack server set [--name <新名称>] [--root-password] [--property <键=值>]
[--state <状态>] <实例名或ID>
2.9 •生成密钥对
• 创建 一个名为“ demo-pub” 的公钥。
openstack keypair create --public-key ~/.ssh/id_rsa.pub demo-pub
• 查看 当前的密钥对列表,列表中显示每个密钥对的名称和对应的指纹。
openstack keypair list
• 查看 指定密钥对的详细信息。
openstack keypair show demo-key
• 加上 --public-key 选项则仅显示指定密钥对的公钥。
openstack keypair show --public-key demo-key
• 使用 openstack keypair delete 命令可删除指定密钥对。
任务三 注入元数据实现虚拟机实例个性化配置
3.1 •元数据注入
• 通过 向虚拟机实例注入元数据 信息完成 个性化配置工作 。
• 元数据 信息分成两大 类
Ø 元数据 —— 结构化数据,以键值对形式注入虚拟机 实例。
Ø 用户数据 —— 非 结构化数据,通过文件或脚本的方式进行注入,支持多种文件 格式。
• 注入 机制分为 两种
Ø 元数据 服务 机制。
Ø 配置 驱动器机制 。
• SSH 密钥 注入 的 实现过程
(1)OpenStack创建一个SSH密钥对。
(2)创建虚拟机实例时选择该SSH密钥对。
(3)用户可以用该SSH密钥对的私钥直接登录实例。
3.2 •元数据服务机制
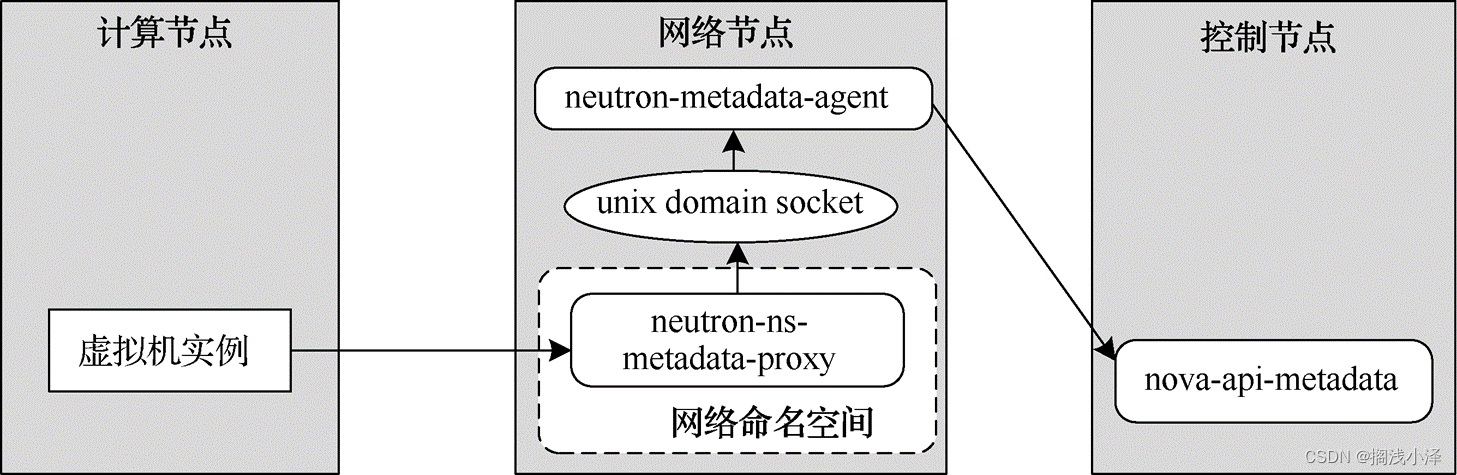
• 元数据 服务的 架构
• 虚拟机 实例通过元数据服务获取元数据的大致 流程
(1)虚拟机实例通过项目网络将元数据请求发送到neutron-ns-metadata-proxy。
(2)neutron-ns-metadata-proxy通过unix domain socket将请求发送给neutron- metadata-agent。
(3)neutron-metadata-agent通过内部管理网络将请求转发给nova-api-metadata。
(4)获取的元数据被原路返回给发出请求的虚拟机实例。
3.3 •配置驱动器机制
• 配置 驱动器主要用于配置虚拟机实例的网络 信息。
• 配置 驱动器是一个特殊的文件系统。
• 配置驱动器的具体实现会根据 Hypervisor 和具体配置 有所不同。
• 使用配置驱动器对计算主机和镜像都有一定的要求 。
• 启用 配置驱动器, 可在 执行 openstack server create 命令创建虚拟机实例时使用 --config-drive true 选项,也在 / etc /nova/ nova.conf 配置文件中 设置 force_config_drive =true 。
3.4 •向虚拟机实例注入用户数据
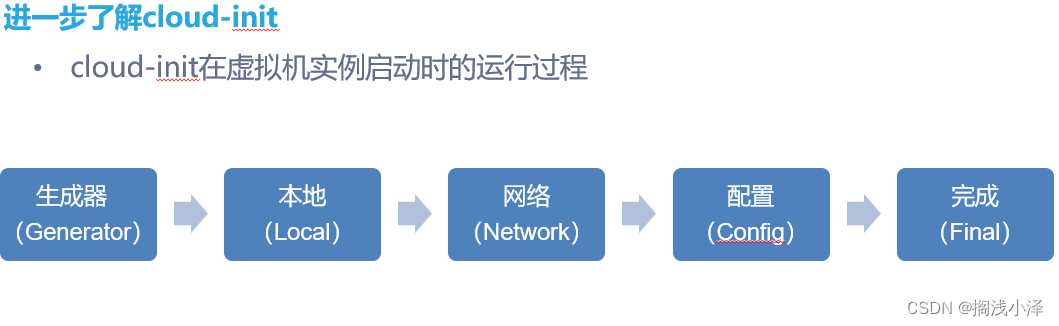
• 在脚本中使用 cloud- config 指令,利用 cloud- init 的 cc_set_passwords.py 模块为用户设置密码并启用密码登录方式。
• 需要传入的脚本示例
#cloud-config #cloud-init会读取它开头的数据,这一行一定要写上
chpasswd:
list: |
root:abc123 #设置root密码
fedora:abc123 #设置默认用户fedora的密码
expire: false #密码不过期
ssh_pwauth: true #启用SSH密码登录(默认只能通过SSH密钥登录)
3.5 •验证元数据服务机制
• 实例 可通过 http://169.254.169.254 访问元数据服务 。
• 元数据 服务支持两套 API
Ø OpenStack 元数据 API
Ø EC2 兼容的 API
• 获取 元数据 API 所支持的版本列表。
curl http://169.254.169.254/openstack
• 进一步 获取其中最新版本( latest )的元数据文件目录。
curl http://169.254.169.254/openstack/latest
• 查看 meta_data.json 文件的内容并以 JSON 格式 显示。
curl http://169.254.169.254/openstack/latest/meta_data.json | python -m json.tool
• 访问用户数据。
curl http://169.254.169.254/openstack/latest/user_data
3.6 •验证配置驱动器机制
• 通过 SSH 登录该实例 ,将 配置 驱动器挂载 到 / mnt /config 目录。
[fedora@fedora-newvm ~]$ su root #切换到root身份操作
Password:
[root@fedora-newvm fedora]# mkdir -p /mnt/config #创建挂载目录
[root@fedora-newvm fedora]# mount /dev/disk/by-label/config-2 /mnt/config #挂载配置驱动器
mount: /mnt/config: WARNING: device write-protected, mounted read-only.
[root@fedora-newvm fedora]# exit #退出root身份操作
exit
• 执行 mount 命令查看当前挂载的 文件系统。
/dev/sr0 on /mnt/config type iso9660 (ro,relatime,nojoliet,check=s,map=n,blocksize=2048)
• 查看 该挂载目录下的内容,可以发现其中有两个目录。
[root@fedora-newvm fedora]# ls /mnt/config
ec2 openstack
• 查看 最新版本( latest )的元数据文件目录。
[root@fedora-newvm fedora]# ls /mnt/config/openstack/latest
meta_data.json network_data.json user_data vendor_data2.json vendor_data.json
任务四 增加一个计算节点
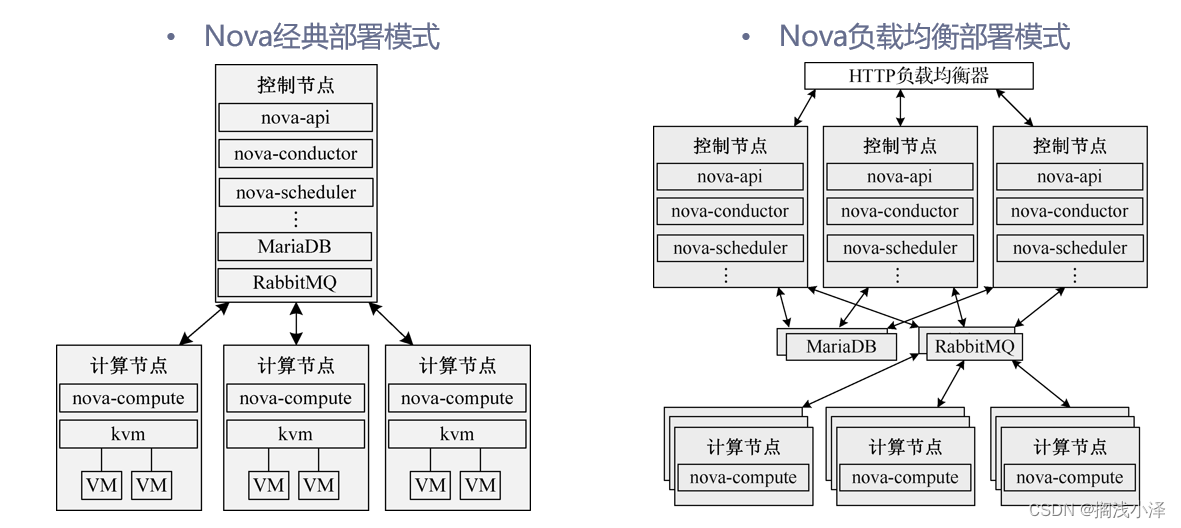
4.1 •Nova的物理部署
• Nova 多 个组件和 服务部署 在计算节点和控制 节点节点 上 。
• 计算 节点上安装 Hypervisor 以运行虚拟机实例,只需要运行 nova-compute 服务 。
• 其他 Nova 组件和服务则一起部署在控制节点 上。
• 通过增加控制节点和计算节点,可以实现简单、方便的系统扩容 。
4.2 •Nova的部署模式
4.3 •准备双节点OpenStack云平台安装环境
• 添加 一个计算节点 node-b ( 192.168.199.32/24 ),为 第 2 个节点准备环境 。
• 更改 其主机名为“ node-b” ,将新的主机名追加到 / etc /hosts 配置文件中,并将第 1 个节点的主机名的解析添加进来,本例配置如下。
192.168.199.31 node-a node-a.localdomain
192.168.199.32 node-b node-b.localdomain
• 将 第 2 个节点主机名的解析也添加到第 1 个节点主机的 / etc /hosts 配置文件中。
• 设置 时间同步。第 2 个节点也与第 1 个节点一样配置 Chrony 。
• 编辑应答文件
• 编辑 packstack-answers-addnode.txt 。
CONFIG_COMPUTE_HOSTS=192.168.199.31,192.168.199.32
CONFIG_PROVISION_DEMO_FLOATRANGE=192.168.199.0/24
CONFIG_KEYSTONE_ADMIN_PW=ABC123456
CONFIG_KEYSTONE_DEMO_PW=ABC123456
• 使用修改过的应答文件运行 Packstack 安装器
[root@node-a ~]# packstack --answer-file=packstack-answers-addnode.txt
…
Installing:
Clean Up [ DONE ]
Discovering ip protocol version [ DONE ]
root@192.168.199.32's password: #提供第2个节点root账户密码
Setting up ssh keys [ DONE ]
Preparing servers [ DONE ]
…
Copying Puppet modules and manifests [ DONE ]
Applying 192.168.199.31_controller.pp
192.168.199.31_controller.pp: [ DONE ]
Applying 192.168.199.31_network.pp
192.168.199.31_network.pp: [ DONE ]
Applying 192.168.199.31_compute.pp
Applying 192.168.199.32_compute.pp #应用第2个计算节点
192.168.199.31_compute.pp: [ DONE ]
192.168.199.32_compute.pp: [ DONE ]
Applying Puppet manifests [ DONE ]
Finalizing [ DONE ]
最后登入仪表盘进行验证
任务五 迁移虚拟机实例
5.1 •什么是实例冷迁移
• 冷迁移是一种非在线的迁移 方式。
• 冷迁移 主要 用于重新分配节点的计算资源,或者主机节点停机维护等场合 。
• 实例 冷迁移的功能与调整实例大小类似 ,只是冷 迁移不改变实例的实例 类型。
• 冷迁移不要求源和目的主机必须共享存储,但要求两者必须满足在计算节点间配置 nova 用户的无密码 SSH 访问。
• 默认只有云管理员角色能够执行实例迁移 操作。
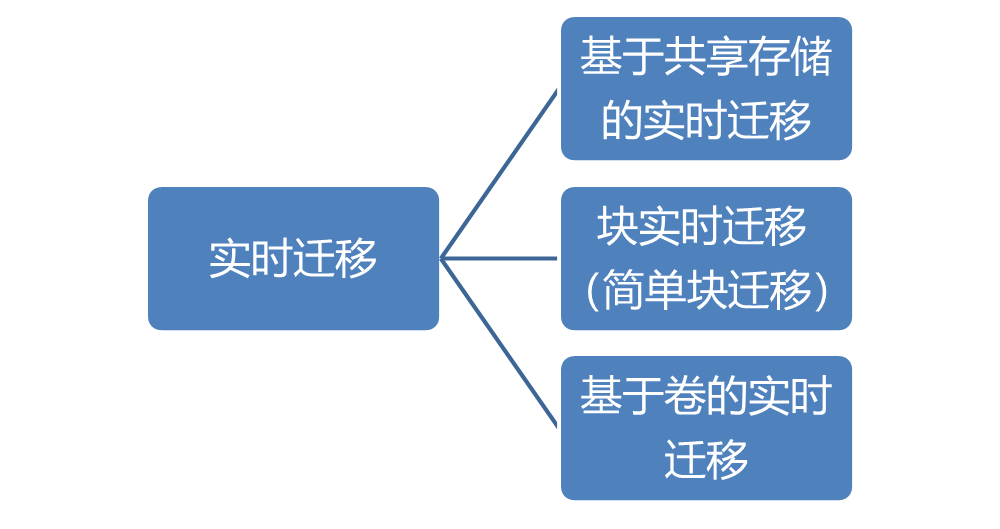
5.2 •什么是实例热迁移
• 热迁移是一种在线的迁移方式,又称实时 迁移。
• 在 迁移过程中实例不会关闭,始终保持运行 状态。
5.3 •热迁移命令行用法
openstack server migrate
[--live <目的主机>]
[--shared-migration | --block-migration]
[--disk-overcommit | --no-disk-overcommit]
[--wait]
<实例名或ID>
• 在计算节点之间配置 SSH 无密码访问
(1)在两个节点上准备SSH密钥对及其配置文件。
Ø 使 SSH 可以进行非交互式登录。
[root@node-a ~]# echo -e 'StrictHostKeyChecking no' > /var/lib/nova/.ssh/config
Ø 将 /var/lib/nova/. ssh /config 文件复制到 node-b 节点对应的目录中。
[root@node-a ~]# scp -r /var/lib/nova/.ssh/config node-b:/var/lib/nova/.ssh
(2)在两个节点上分别执行命令使nova用户可以登录。
usermod -s /bin/bash nova
(3)在两个节点上检查确认nova用户可以不用密码登录到对方节点。
(4)以root用户身份在两个节点上重新启动libvirt和计算服务。
systemctl restart libvirtd.service openstack-nova-compute.service
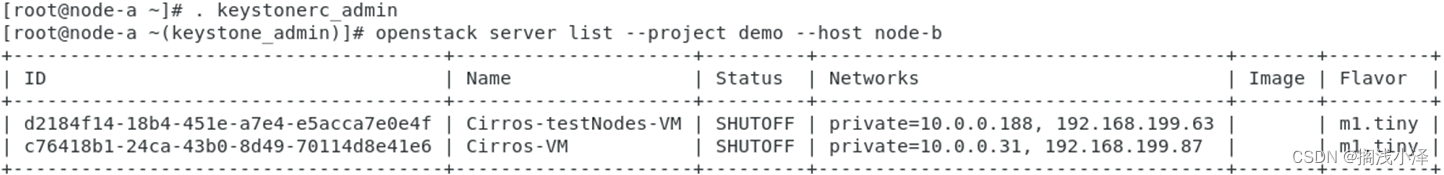
• 执行实例的冷迁移 操作
• 查看实例 列表
•
•
• 执行命令 迁移虚拟机 实例
[root@node-a ~(keystone_admin)]# openstack server migrate c76418b1-24ca- 43b0-8d49-70114d8e41e6
• 执行实例的冷迁移 操作
• 执行命令 确认调整。
[root@node-a ~(keystone_admin)]# openstack server resize confirm c76418b1-24ca-43b0- 8d49-70114d8e41e6
• 查看 实例列表
• 实现热迁移的通用配置
(1)在每个计算节点上的/etc/nova/nova.conf配置文件中设置server_listen和instances_path参数。
(2)确认每个计算节点具有相同的名称解析配置,以便它们能通过主机名互相访问。
(3)启用root用户免密码SSH功能。
① 在第1个节点上将root用户的SSH公钥加入authorized_keys文件。
② 在第1个节点上将authorized_keys文件复制到第2个节点上。
③ 在第2个节点上将root用户的SSH公钥追加到authorized_keys文件中。
④ 在第2个节点上将authorized_keys文件复制回第一个节点上。
(4)如果启用防火墙,则应允许计算节点之间的libvirt通信。


- 聚类)


